


来源:头部科技
文章链接:https://mp\.weixin\.qq\.com/s/2WGZG6oBTTelabXpvUHf4A
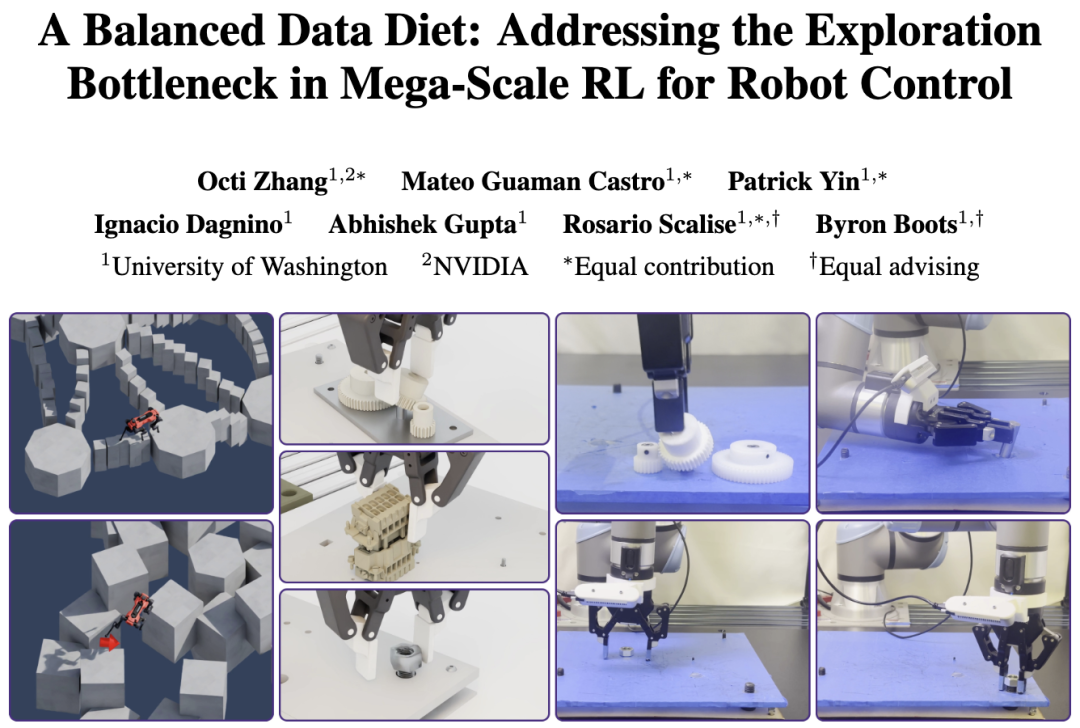
研究人员将训练得到的操作策略蒸馏为基于RGB图像输入的策略,在真实硬件上可实现多项高难度装配任务的零样本迁移。
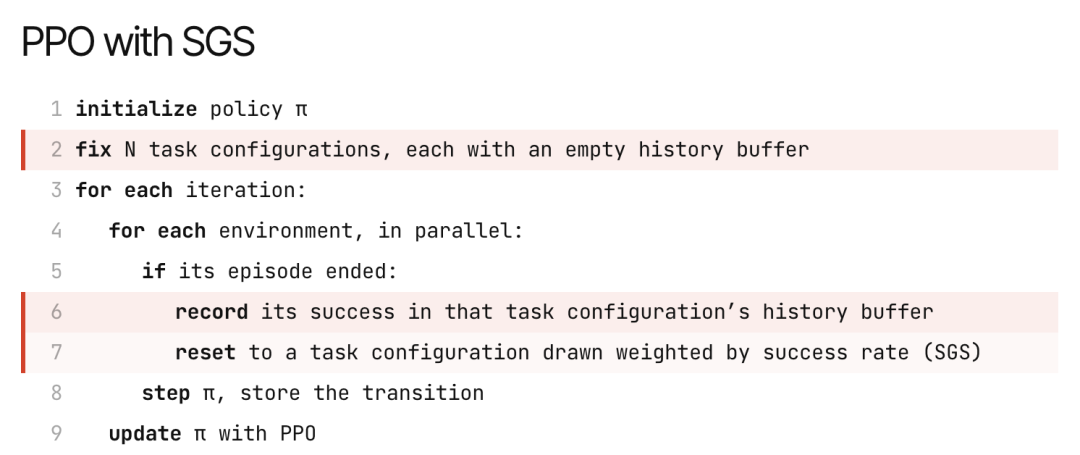
具体来讲大概分三步:
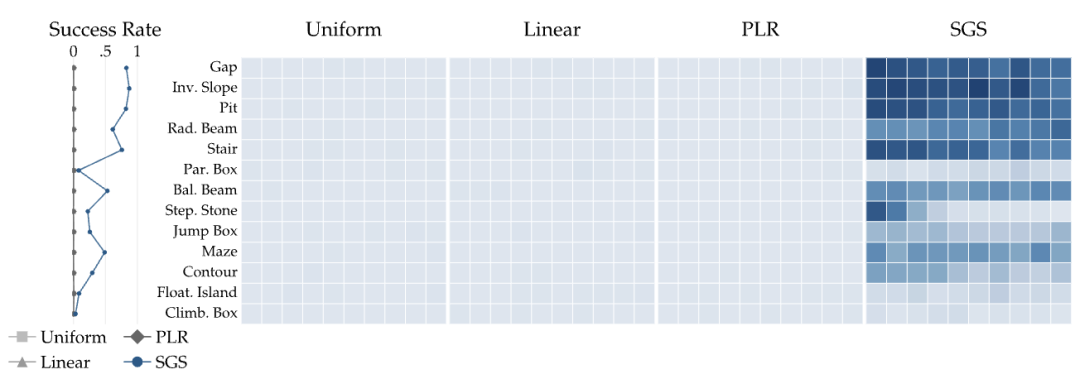
1、统计成功率,训练前从任务分布里预采样N个固定配置,对每个配置维护最近100次回合的成败结果,实时估算其成功率;2、贝塔分布加权打分,控制采样“贪心程度”,确保所有任务始终被回顾、成功率估计不失真;3、Softmax采样,就是按分数高低“加权抽签”,****每回合结束按打分做Softmax采样更新成功率,再进入下一轮挑战。
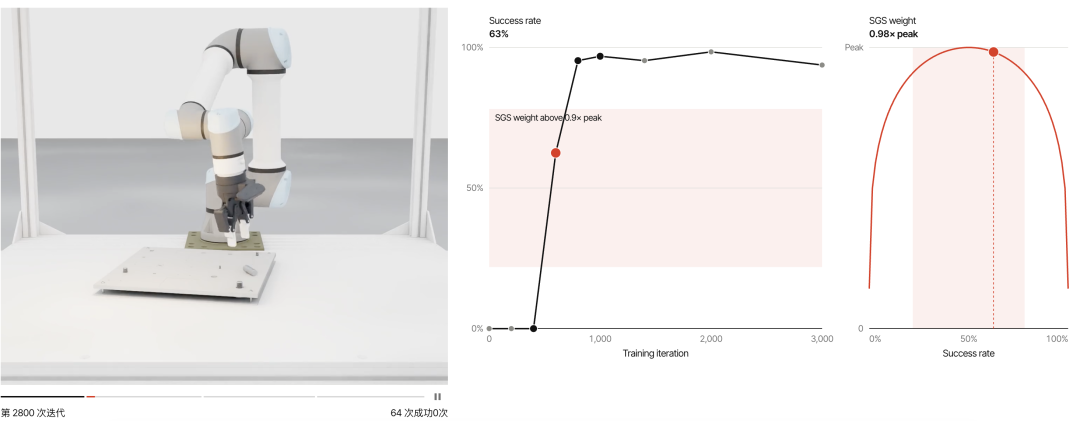
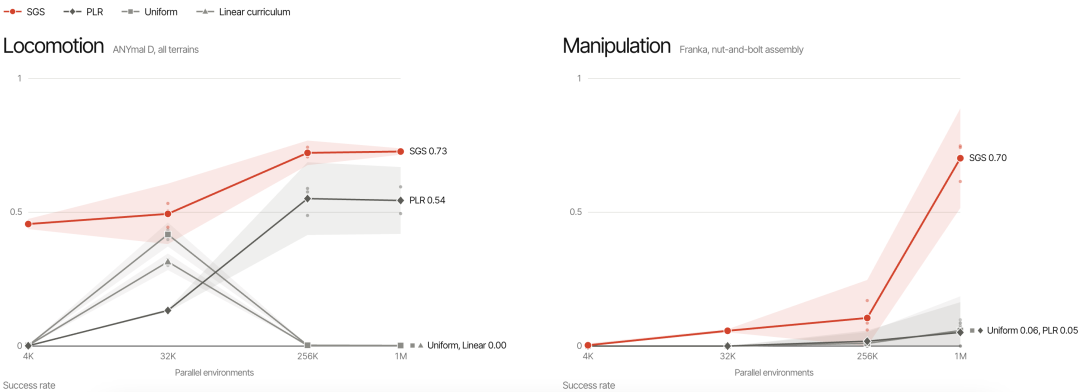
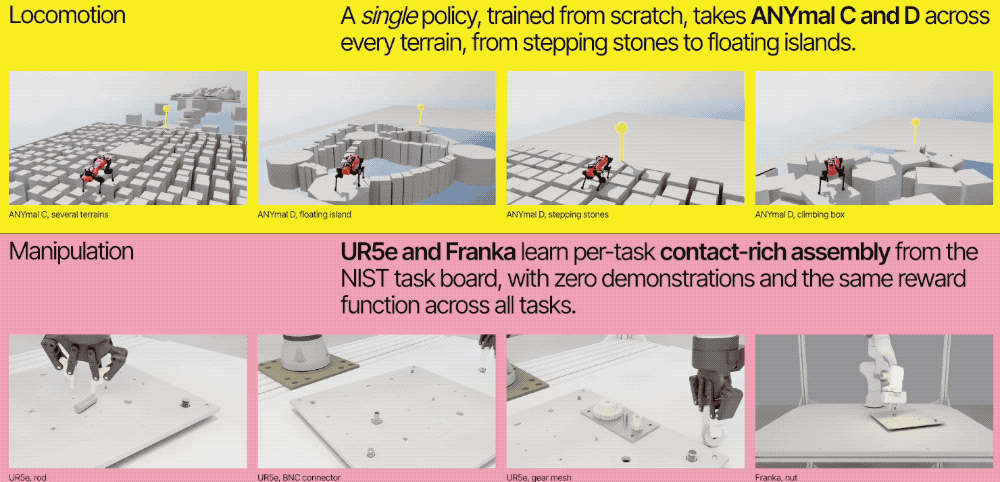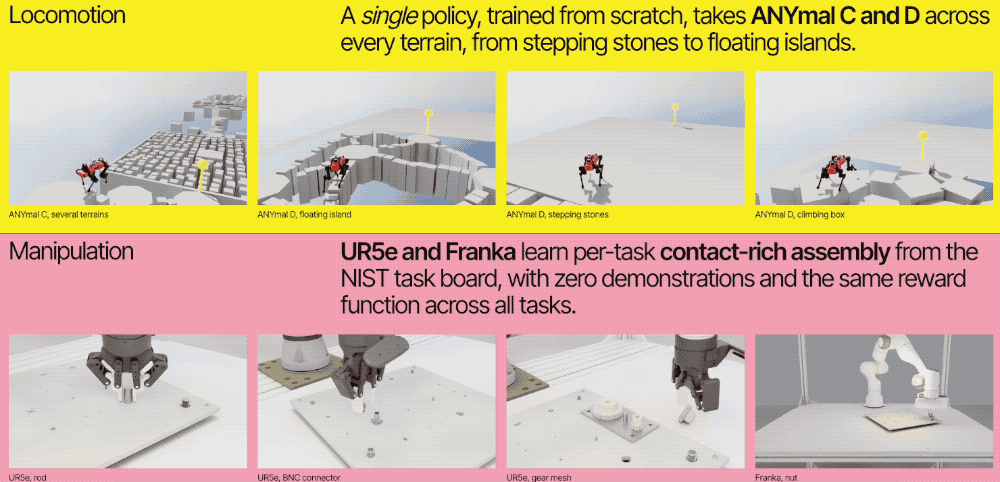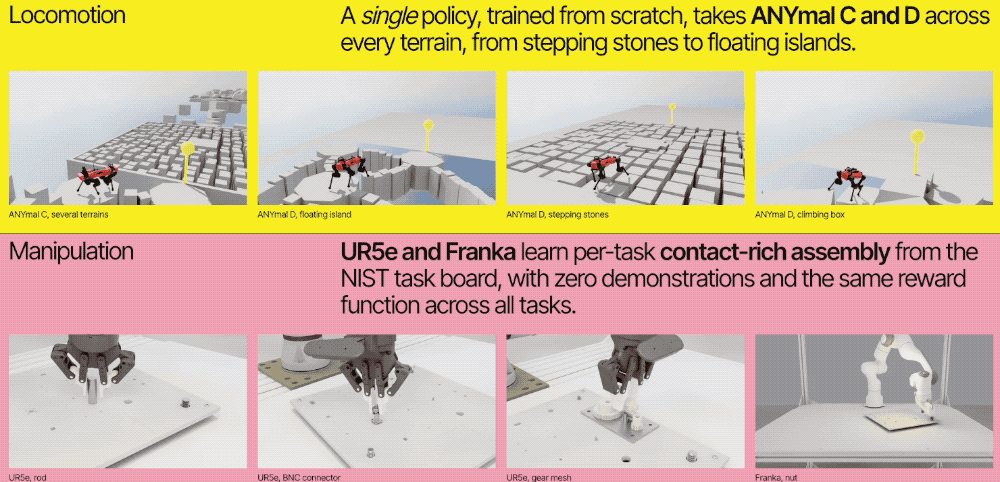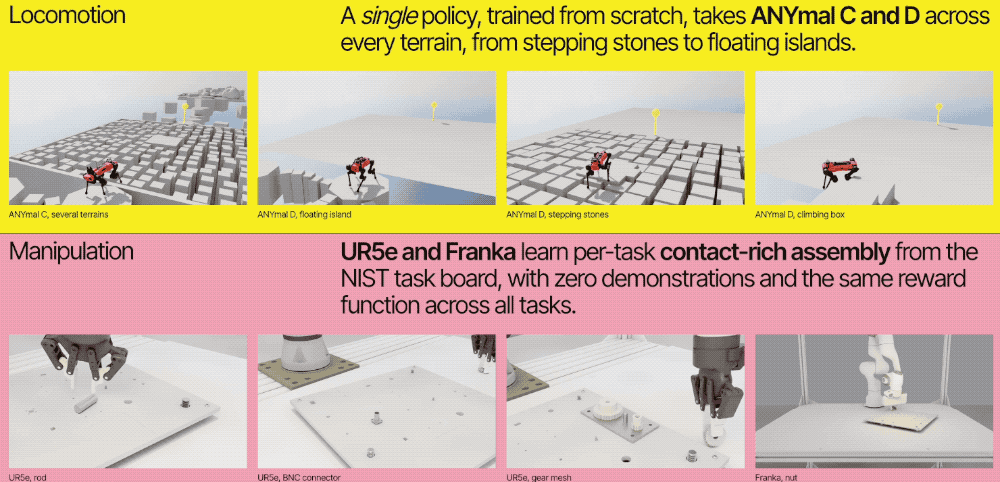
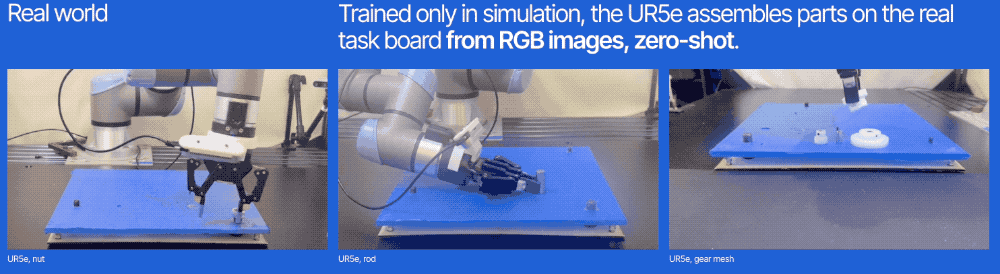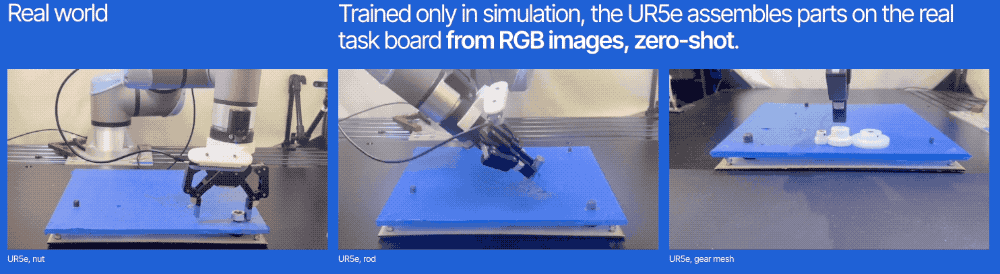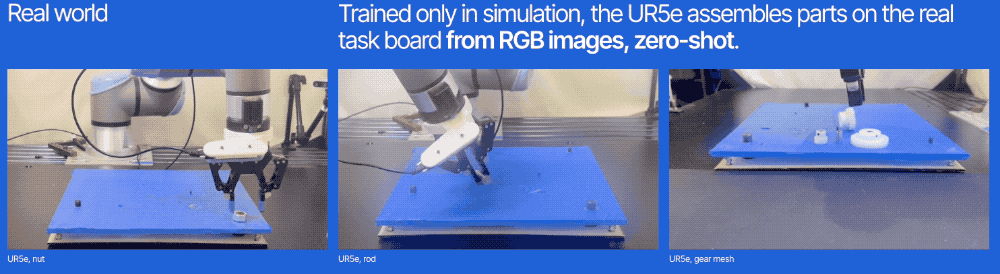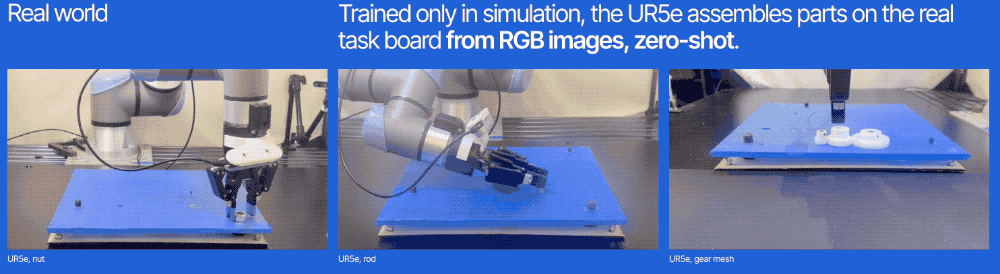
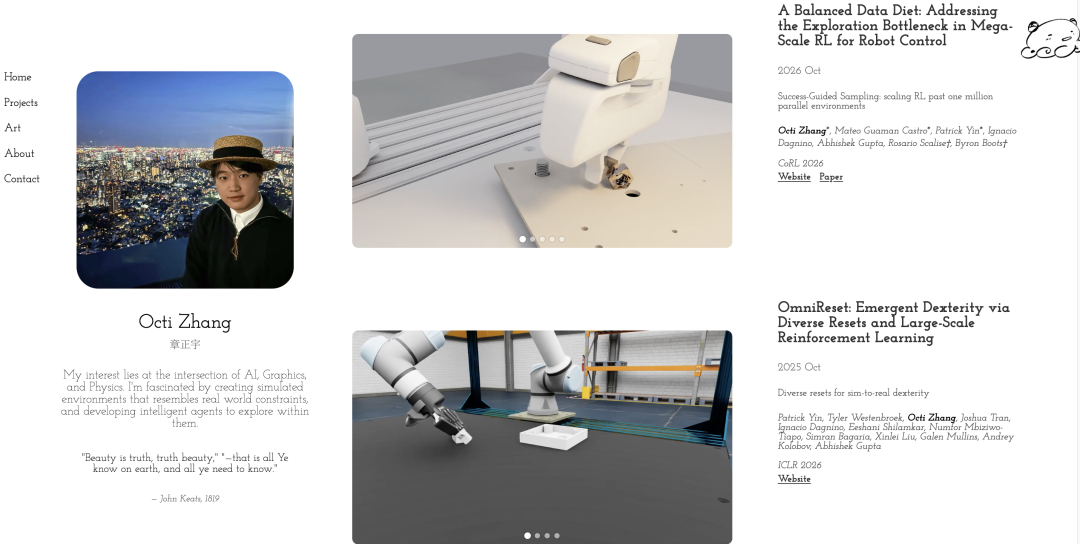
这项研究的一作章正宇(Octi Zhang)是位华人小伙,此前在华盛顿大学机器人实验室从事AI、图形学和物理学交叉方向研究,目前在英伟达Isaac Lab开源项目组工作。
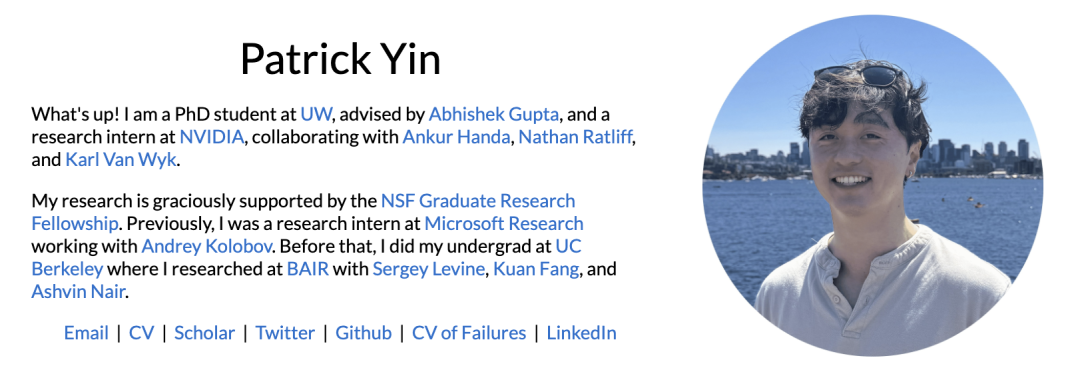
另一位同等贡献作者Patrick Yin是华盛顿大学(UW)的博士生,在英伟达做研究实习生。
研究人员表示,SGS目前还存在三点局限性: 第一,SGS是对预先定好的一批有限任务场景统计成功率,虽然本实验里设置32768个场景够用了,但如果遇到任务是连续变化、或者任务数量极其庞大的情况,就得改用可学习打分,或者分层打分的方式才行;
第二,SGS只会从已经准备好的任务池里挑选场景,它自己不会创造出新的任务场景。本研究要依靠OmniReset这类工具,来生成各种各样的开局,保证任务足够丰富,但怎么让算法自动生成需要的训练场景,实现完整闭环,目前还是一个待解决的难题。
第三,仿真训练出来的模型,部署到真实机器人上依然存在性能落差,怎么把真机效果提升到和仿真差不多的水平,需要后续研究去攻克。
和过去的工作对比,SGS的关键贡献是不再需要大量人工去编写奖励函数,也不用手动设计由易到难的训练顺序,让机器人自适应地选择“策略现在该练什么”,是扩大强化学习规模的重要一环,也为更广泛的多任务学习和通用灵巧策略指出了一条新路。
原文链接: https://www.leiphone.com/category/private/bLZ8Awnd0jAMWMJs.html
