


文章链接:https://mp\.weixin\.qq\.com/s/Wpv0oRCg5jN7XisDNYHXEw
2026 年 10 月,两份成绩单前后脚摆上桌。
一份来自商汤 SenseNova 联合大晓机器人、南洋理工大学、东京大学的真机评测报告:把 GPT-6-Astra 接上八个真机平台,不给任务示范、通常限时 60 分钟,让它直接指定机械臂每个关节的角度——成功率 9.72%。同一个模型,只改成指定机械臂末端的位置和姿态,成功率升到 15.83%;再用“往左 30 厘米”这种相对方向加移动距离来描述动作,18.06%。
另一份来自 UC Berkeley 参与的 TANGO 论文(arXiv:2609.09158,CoRL 2026 接收):一个直接输出 29 维全身关节角的模型,在没采过任何真机导航数据的前提下,零样本在一栋真实办公楼里走完 30 米杂乱路线,途中蹲身钻过横杆、侧移挤过窄缝、抬腿跨过地上的障碍。
两份成绩单说的都是“大模型直接给关节角”。一个 9.7%,一个能走 30 米。差别不在谁的模型更大,而在架构图角落里一个不起眼的小框——一个跑在机载电脑上、每秒闭环约 200 次的运动跟踪器。
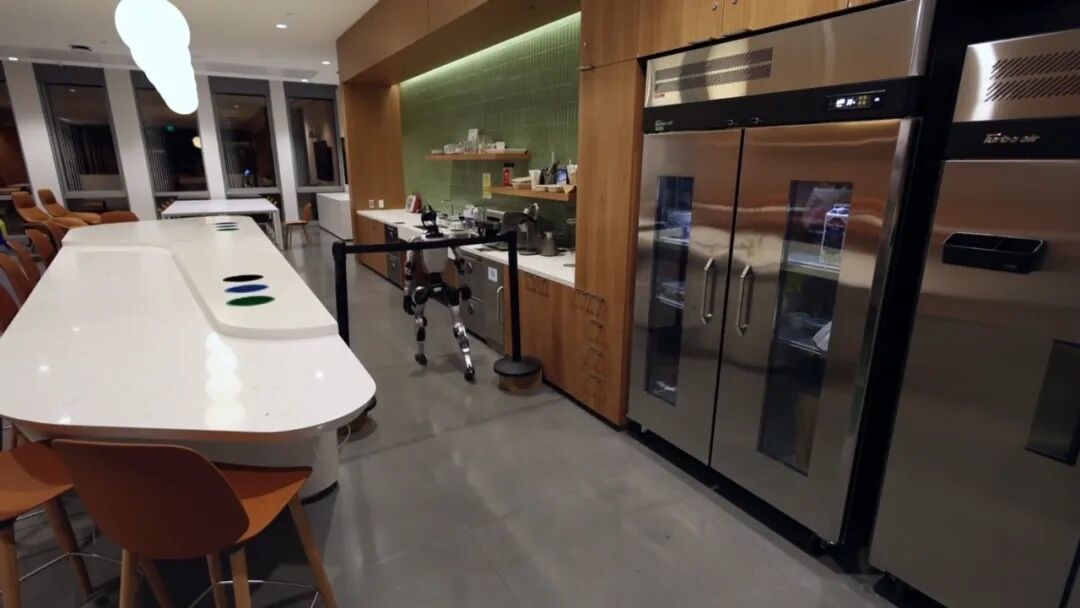
▲ G1 在真实茶水间蹲低身体钻过横杆。大脑决定“钻过去”,姿势由 200Hz 小脑实时兑现|TANGO 项目页官方部署视频截帧
有一点得先说清:这两个数字来自不同任务,机械臂操作和全身导航不能直接对表比“谁强”。真正可比的是接口层级的选择逻辑——而这套逻辑,做过伺服调试的工程师其实很熟:位置环、速度环、电流环各管各的频率,谁也不能替谁。人形机器人的“大脑—小脑”分层,就是同一件事在 29 个关节上的放大。下面把这三层频率一层层拆开。
一、先看一张部署图:三个系统,三个频率
TANGO 的真机部署图(论文 Figure 3)画得很直白:机载端是 Client,机房是 Server,中间用普通 IP 网络连着。
VLA 模型——白话讲,就是“看得懂摄像头画面和语言指令、能输出动作序列的模型”——跑在配 RTX PRO 6000 显卡的服务器上,每 0.5 秒推理一次,折合 2Hz。它不看一步走一步,而是一次生成一个动作块:15 步、每步间隔 1/30 秒,正好打包出半秒钟的未来动作。
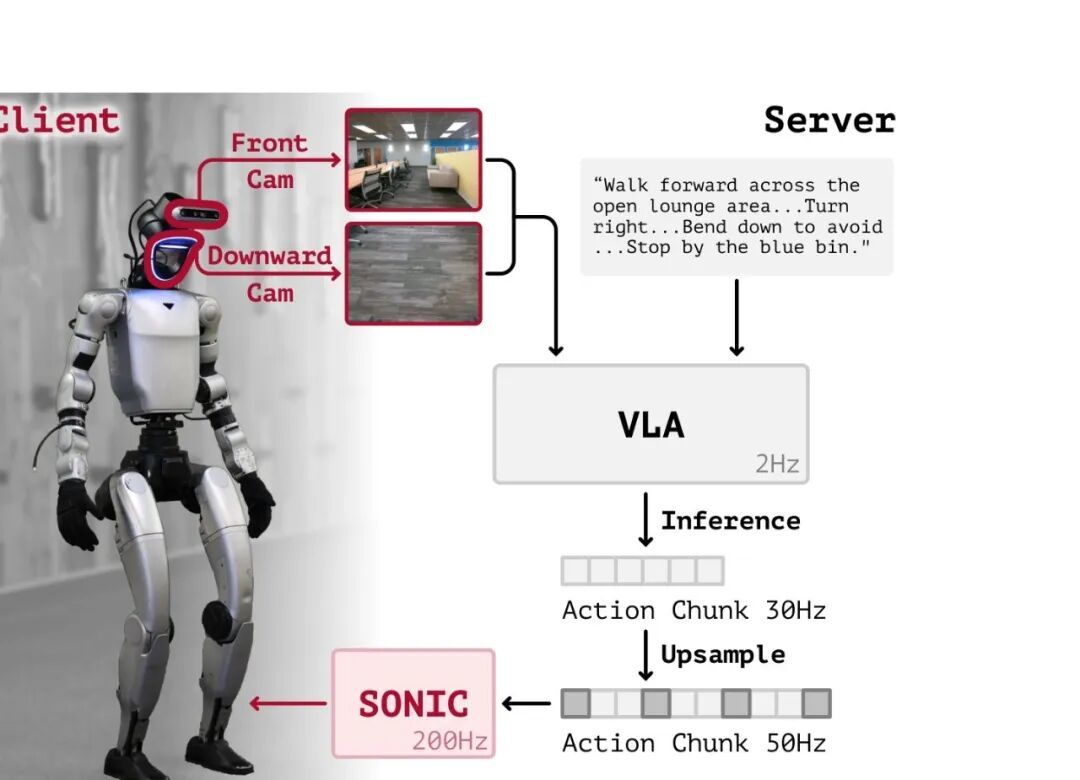
▲ TANGO 云边部署架构:VLA 2Hz 出动作块、重采样 50Hz、SONIC 约 200Hz 机载闭环,低频大脑与高频小脑经 IP 网络分离|TANGO 论文 Figure 3(arXiv:2609.09158),图内英文标注为原图自带
动作块回传到机器人后先重采样到 50Hz,再交给一个叫 SONIC 的跟踪器——白话讲,小脑:把“半秒后髋膝踝该在的角度”实时翻译成每个关节出多大力气的控制器。它跑在机载的 Jetson Orin NX 上,以约 200Hz 的频率闭环,论文原文的表述是 “closes the low-level control loop at approximately 200Hz”。
视频流往反方向走:机器人头部的前视和下视相机把画面推给服务器,上行延迟约 20 毫秒。
2Hz、30Hz、50Hz、200Hz——四个频率差出两个数量级,缺哪层都不行。大脑像领航员,每半秒报一次“接下来半秒怎么走”;小脑像握方向盘的手,每 5 毫秒修一次偏差。领航员可以迟到 20 毫秒,反正他报的是半秒后的路;方向盘的手一秒都不能停。
二、为什么大模型不能直接写关节角:抽象层级的账
商汤那份评测里最值钱的,是三档成功率的台阶:关节角 9.72%、末端位姿 15.83%、相对方向 18.06%。指令越“像人话”,成功率越高。
为什么?一个机械臂五六七个关节,让模型一次写对每个关节的角度值,每个值还要满足动力学的隐性约束——电机出不了这个力矩、关节到不了那个角度,写错一个动作就变形。而“往左 30 厘米”只锁定结果,中间每个关节怎么动,交给底层控制器去解,误差被闭环消化掉,不再压在模型身上。
调用频率是同一类账。每执行一步都喊一次模型,纠错及时但开销惊人;让模型自己决定一次执行 1 到 4 步,成功率从 15.83% 提到 20.00%,Token 消耗——模型处理指令时计费的最小单位——从 256 万降到 114.6 万,直接砍掉一半多。真机上的代价更直观:评测方记录到,GPT-6-Astra 在宇树 G1 上约 90% 的运行时间花在“想”上,一次操作实验可能超过一小时(评测方口径,无第三方复现)。
更进一步的对照也支持同一件事:在 RoboDojo 基准上,大模型开环地给子目标、VLA 埋头执行,成功率只有 5.83%;改成闭环、让大模型在执行前逐个审核候选动作,升到 25.83%;再叠加经验知识包,54.17%。模型的价值在“判断”,不在“亲手写关节角”。
做过伺服系统的人对这套逻辑不陌生:没有人让规划软件直接输出电流环的给定值。规划给目标,内环管执行,接口选在哪一层,决定了上面每一层要背多少误差。
三、TANGO 的答案:关节角可以给,但要有人兜底
TANGO 偏偏选了商汤评测里那个最差的接口——直接输出 29 维关节角加 6 维基座姿态。为什么它反而走通了?
答案在动作块的身份:它只是参考轨迹。SONIC 在机载端以 200Hz 闭这个环,把参考角度实时翻译成关节力矩,机器人真实姿态始终被拉回参考线附近。大模型给的是“意图”,小脑负责“兑现”。
论文的消融实验把这件事量化了。在增广 VLNVerse-unseen 测试集上,完整系统成功率 43.75%、碰撞率 9.90%;去掉 RTC——白话讲,就是让新生成的动作块开头对齐旧动作块正在执行的位置,避免每半秒“抖”一下——成功率掉到 10.94%,碰撞率涨到 14.60%。一个衔接算法,值 32.81 个百分点的成功率。把 SONIC 换成另一个通用跟踪器 ScaleBFM,成功率 40.94%,三顶指标都只掉 3 个点以内——说明小脑是可替换的标准件,不是绑死某个黑盒。
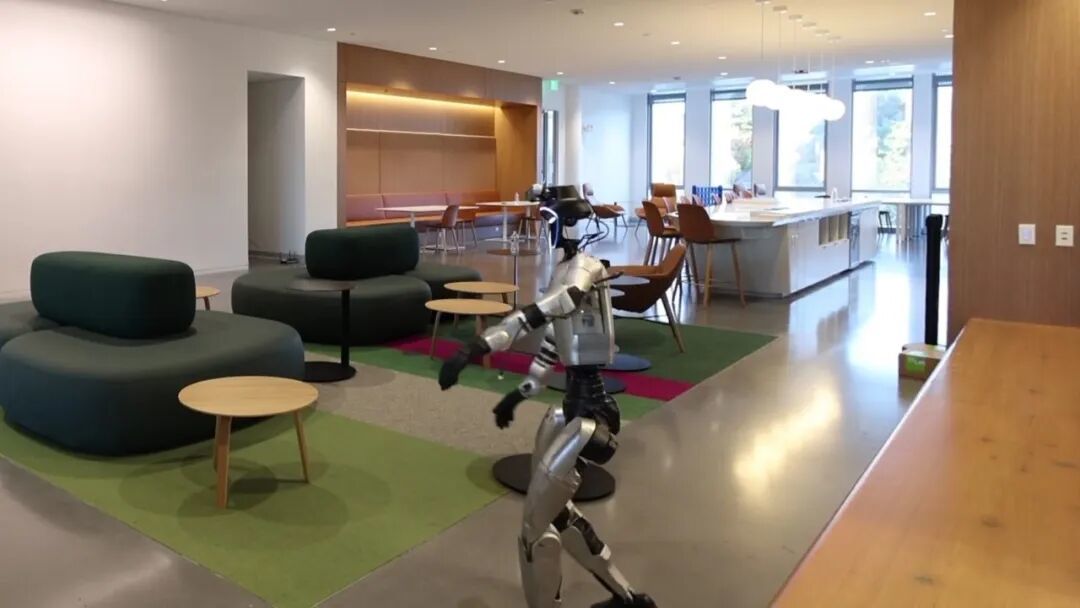
▲ 侧移通过窄缝:29 维全身动作里,侧移是训练中被重点加权补偿的稀有行为|TANGO 项目页官方部署视频截帧
真机成绩单也在这里:每场景 5 次试验、每次 15 试——短航程 12/15、约 30 米长航程 8/15、带障碍 3D 场景 10/15;长航程平均每次试验碰撞 1.07 次,对照基线的 3.47 次。局限同样写在论文里:低层跟踪器的能力是整个系统的上限——上楼梯不行;纯 RGB 输入,弱光、玻璃门、视觉上含混的场景不可靠。
四、延迟的物理账:误差约等于速度乘时间
那能不能把小脑也搬上云端,全交给一个大模型?这道题可以算。
简化假设:机器人以 0.5 米/秒匀速直线走(室内导航的典型量级),两次修正之间的间隔是 Δt,那么每段间隔里机器人“盲走”的距离约为 v×Δt。
如果闭环只有大脑那 2Hz,Δt=0.5 秒,盲走 0.25 米。桌角、门框、横杆的特征尺寸是 5—20 厘米级,0.25 米足够从“许可通过”直接变成“撞上”。换成机载 200Hz 小脑,Δt=5 毫秒,盲走 2.5 毫米,比障碍的特征尺寸小两个量级——这就是“能走”和“能走稳”之间的距离。
那 20 毫秒的视频上行延迟为什么可以容忍?因为视频不是喂给闭环的,是喂给大脑的——它影响的是下一个 0.5 秒动作块的内容,而不是这 5 毫秒的关节修正。状态反馈走的是另一条路:关节编码器数据在本机,微秒级送达小脑。数据和闭环待在哪一层,延迟容忍度就差在哪一层。
假设边界:上式为匀速直线的量级估算,不含减速、避障轨迹曲率与通信抖动;实际系统的滤波和执行延迟只会让预算更紧,不会更松。
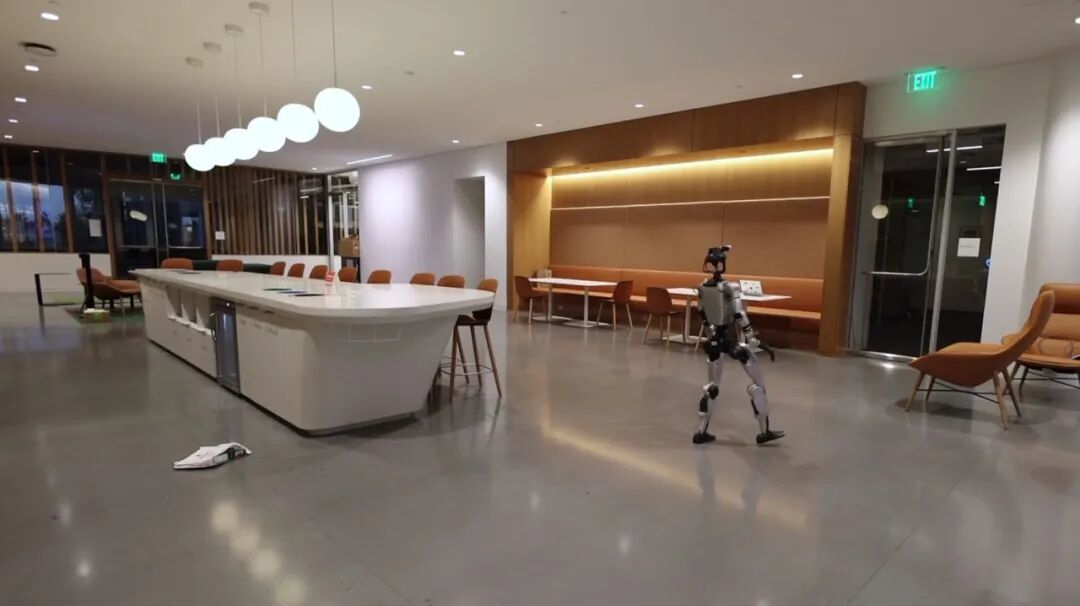
▲ 跨步越障:200Hz 闭环下“盲走”距离只有毫米级|TANGO 项目页官方部署视频截帧
五、这套架构要喂多少数据、花多少钱
分层架构省下的是真机数据,账在论文 Table 6 里:64,633 条训练轨迹,全部由仿真管线 PET(规划—编辑—跟踪)生成,其中 PET 花了 86 个 RTX PRO 6000 GPU 小时,渲染再花 125 个小时,合计 211 个 GPU 小时。平摊下来,一条轨迹约 11.7 秒 GPU 时间(本文估算:211×3600÷64,633)。对照真机遥操——人戴着设备实时遥控机器人采数据——每小时数百到上千元的行业口径(本专题 10 月 19 日篇核验在案),这是“一条轨迹 GPU 秒级”对“一条演示人工小时级”的差距。代价也得认:sim-to-real——仿真里练、真机上走——的鸿沟,要靠仿真保真度和那个 200Hz 的小脑一起填。
训练本身另算:896 个 A100 GPU 小时。考卷成绩:VLNVerse 仿真基准上成功率 54.69%(见过场景)/52.89%(没见过的场景),都是参评方法里最高的。但注意论文脚注的口径:对照方法全部跑在“传送”设定里——规划出路径直接算作走到,只有 TANGO 带底层物理控制。分数高是一回事,敢不敢让真机执行是另一回事。
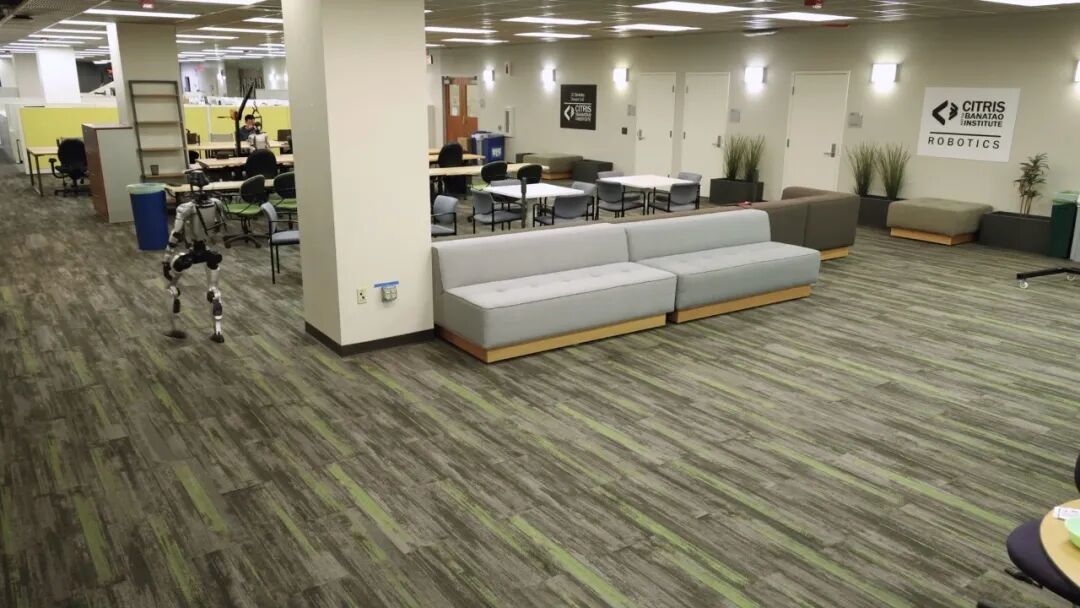
▲ 30 米长航程路线的真实办公环境|TANGO 项目页官方部署视频截帧
六、现实校验:六七成到 99% 之间差的是什么
把镜头拉回国内。南方周末 10 月对矩阵超智 CEO 张海星的专访里有一句很实的话:零样本新任务成功率约六七成,“可 work 但不可部署”,要和客户共采真实数据训练到 99%,才能替换真人(受访人单方口径,原文在付费墙内,以转载全文核对)。
六七成到 99% 之间差的那 30 个百分点,恰好就是本专题 10 月 20 日算过的那笔账:98% 的单次成功率配上高频循环,异常处理会把免维护性拖垮。模型侧补这 30 个点,靠共采数据;小脑侧补这 30 个点,靠失效兜底和降级运行。两层各管一段,谁都替不了谁。
七、给工程师的追问清单
下次评审任何“端到端”方案,四个问题可以直接开问:
1. 小脑在哪、多少赫兹?没有 100Hz 量级的机载闭环,全身控制谈不上稳定。论文里 200Hz 是硬门槛,不是工程偏好。
2. 动作块多长、怎么衔接?有没有 RTC 这类对齐机制?去掉它掉多少点,论文里有没有消融数据。没有消融的“端到端”,先打个问号。
3. 跟踪器能不能换?TANGO 换 ScaleBFM 只掉 3 个点,小脑是标准件;如果方案绑死某家的黑盒小脑,下一代产品也被一起锁死了。
4. 云断了怎么办?20 毫秒网络分离的设计,本身就默认了大脑可以卡顿、小脑必须活着。降级预案是安全项,不是可选项。
对机械工程师,还有一层职业判断:所谓“小脑”,拆开看就是位置环、速度环、电流环那套功夫在 29 个关节上的放大,外加跌倒恢复、接触稳定这些新考题。大模型越强,这层的门槛没有降——反而因为要接住更强的意图流,被抬得更高了。
原文链接: https://www.leiphone.com/category/private/sf34zhZRPLEHrwP5.html
