


来源:具身智能论文日记
文章链接:https://mp\.weixin\.qq\.com/s/Tn5w\-\-jJZG2fiwES\-z0hOg
开放环境中的物体类别会不断增加,视觉语言模型也可能把同一障碍映射成多个候选标签。CoSMO 用在线保形校准维护这些候选类别,并按最保守的类别安全距离扩张障碍边界。作者在 2,195 个 MP3D episodes 上报告,语义碰撞率相较几何基线从 25.5% 降至 9.8%;但与同一视觉特征下的 Argmax 相比,成功率从 18.4% 降到 13.8%。Go2 实验的经验覆盖率为 90.73%,接近 90% 目标,理论保证则从相关类别被发现后才适用。
来源:具身智能论文日记文章链接:https://mp\.weixin\.qq\.com/s/Tn5w\-\-jJZG2fiwES\-z0hOg开放环境中的物体类别会不断增加,视觉语言模型也可能把同一障碍映射成多个候选标签。CoSMO 用在线保形校准维护这些候选类别,并按最保守的类别安全距离扩张障碍边界。作者在 2,195 个 MP3D episodes 上报告,语义碰撞率相较几何基线从 25.5% 降至 9.8%;但与同一视觉特征下的 Argmax 相比,成功率从 18.4% 降到 13.8%。Go2 实验的经验覆盖率为 90.73%,接近 90% 目标,理论保证则从相关类别被发现后才适用。
论文信息
https://yangming911\.github\.io/cosmo\-page/
https://arxiv\.org/abs/2610\.18321
导读
机器人走进陌生室内环境时,避开桌椅等几何障碍只是第一步。不同物体需要不同的安全距离,语义标签出错可能让规划器低估风险;但把所有障碍都按最大半径膨胀,又容易堵住窄通道。
CoSMO(Conformal Semantic Mapping for Open-World Safe Robot Navigation)尝试把视觉语言模型的语义不确定性直接接入安全地图。它不只保留单个最可能的物体标签,而是为每个障碍网格构造一组经过校准的候选类别,再按候选集合中最严格的安全距离进行规划。
问题:标签不确定性会变成几何风险
传统几何导航关心障碍在哪里。语义安全导航还要根据类别设置不同的净距。视觉语言模型给出的相似度分数通常没有经过安全校准;若类别词表固定,新增标签也会改变依赖 Softmax 的分类分数,使历史阈值失去原有含义。
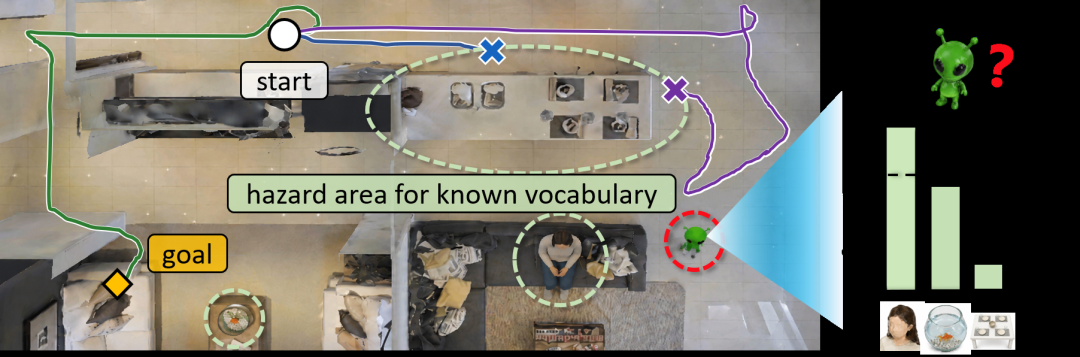
图 1:论文比较无语义安全的导航、单标签 VLM 避障、CoSMO 多候选语义规划,以及遇到未见类别时失效的闭集保形预测。
图中的关键区别是规划器拿什么做安全判断:Argmax 只使用最可能标签,一旦误分类就可能低估净距;CoSMO 保留多个符合阈值的候选标签,再按最保守的安全半径规划。示意图表达了方法动机,实际效果仍要看后续碰撞率与成功率的共同变化。
方法总览:从视觉嵌入到安全膨胀地图
CoSMO 的输入是 RGB-D 观测、机器人当前位姿、类别安全字典和延迟到达的专家标签。图像编码器把观测转为稠密视觉特征,深度信息将特征投影到俯视网格。每格保留连续嵌入,而不是固定词表下的类别概率,因此新类别可以直接与已有地图匹配。
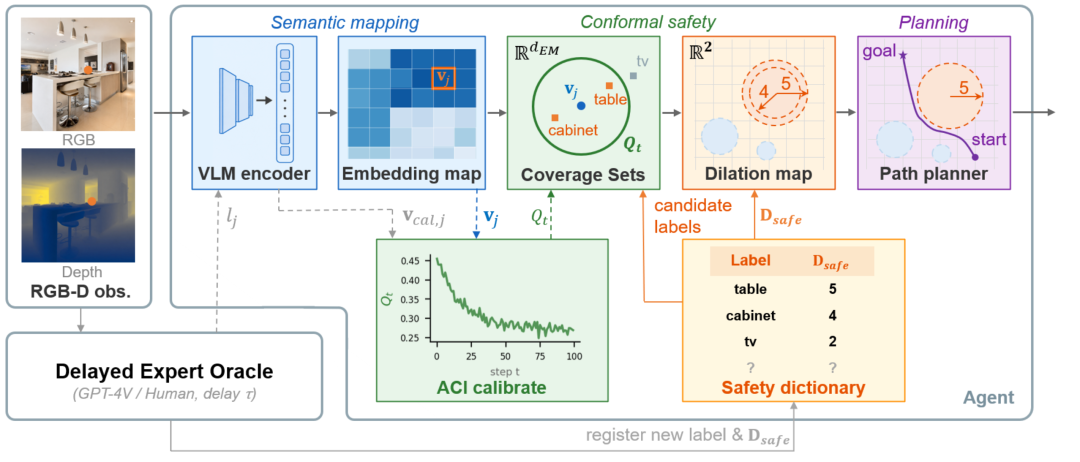
图 2:CoSMO 的模块关系。RGB-D 特征形成嵌入地图;保形覆盖集生成安全膨胀距离;延迟专家反馈同时扩充类别字典并更新在线校准阈值;下游规划器使用更新后的障碍地图。
整条链路包含三个接口:嵌入地图提供类别无关的视觉表示;在线校准把不确定表示变成标签集合;安全层再把标签集合转换成可被现有规划器使用的障碍膨胀图。论文没有为 CoSMO 重新训练一个端到端网络,而是在预训练视觉语言特征之上进行在线统计校准。
方法细节:在线发现、校准与规划
1. 延迟专家扩充类别字典
系统开始时安全字典为空。专家在 τ 步后返回先前观测邻域的真实标签和安全距离。遇到尚未登记的标签,系统将其文本嵌入及安全距离追加到字典。字典只增不减,已登记类别的安全距离保持不变。
专家标签不会直接改写网格视觉特征,而是用于比较“当时看到的视觉嵌入”与“后来确认的类别文本嵌入”,得到追溯校准分数。仿真实验采用 GT 标签或 Grounding-DINO 作为专家;真实机器人实验用延迟的 Grounding-DINO 检测结果。
2. 词表增长时仍可复用的分数
CoSMO 使用视觉嵌入与标签文本嵌入之间的成对差异作为非符合分数,例如余弦距离。由于分数只依赖一对向量,插入新类别不会重算已有分数。机器人邻域中的所有分数再取最大值,让校准覆盖的是一整个安全相关邻域,而不是各网格互不相关的单点。
每次收到延迟标签后,算法比较旧邻域的最大分数与当前阈值。若该分数越过阈值,说明这次出现了覆盖误差,系统就提高阈值并放宽候选集;若持续覆盖,阈值会向下调整。主实验的目标误覆盖率为 10%,ACI 步长为 0.05。
3. 候选标签决定安全半径
对一个障碍网格,CoSMO 把所有成对分数低于当前阈值的已知类别纳入覆盖集。规划时取集合内最大的类别安全距离,并据此膨胀障碍地图。
这里有一个重要的冷启动边界:如果覆盖集为空,CoSMO 设置语义膨胀半径为 0,只依赖基础几何障碍图。也就是说,标签进入字典后才有相应的语义覆盖保证;一个尚未发现的新危险物体,不会自动获得最大安全距离。
实验设置与真实平台
主仿真实验使用 Matterport3D ObjectNav 的完整验证集,共 2,195 个 episodes。主实验中机器人从空字典开始在线发现 5 个安全相关类别。论文还用 330 个 episodes 测试专家延迟、不同安全字典、覆盖目标和场景变化。
使用的导航骨干为 ConvNeXt-Large-d-320(LAION-2B),GCLIP 障碍特征使用 ViT-B/16(OpenAI CLIP),几何检测基线为 YOLO-World/L;Grounding-DINO 用于噪声专家实验。仿真使用 Habitat-Sim 0.2.2,网格分辨率为 0.1 米,最大安全半径为 0.5 米,邻域半径为 0.6 米。论文报告的硬件为 2 张 RTX 4090。
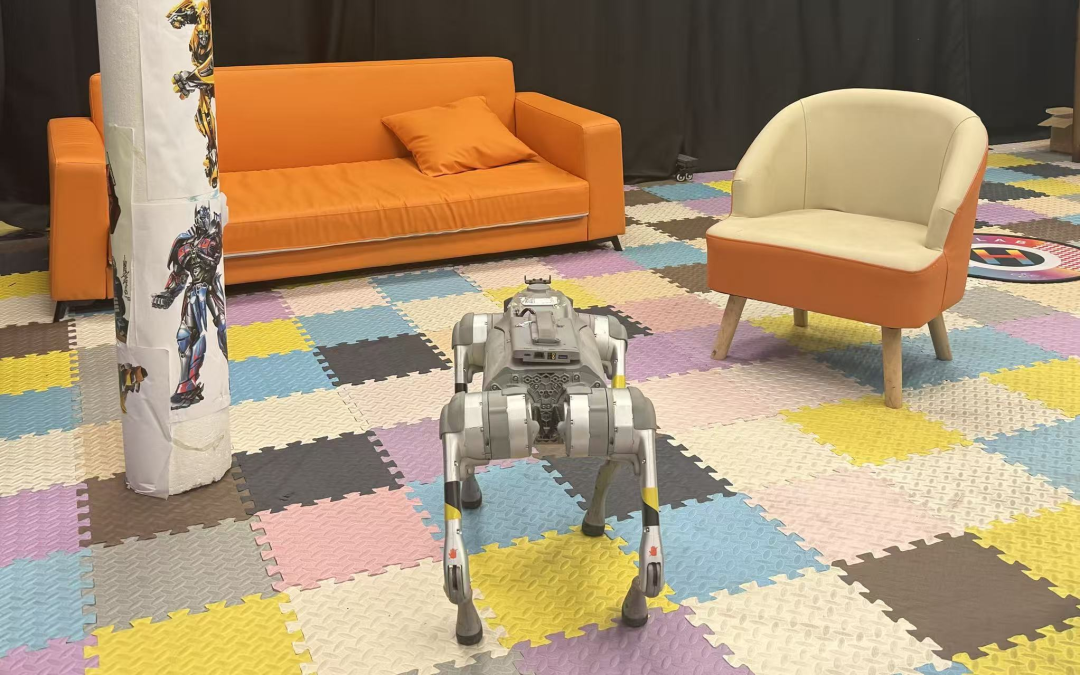
图 3:论文的 Unitree Go2 实体机器人部署场景。
真实平台照片说明作者搭建了室内四足导航环境,但照片本身不是性能证据。接下来需要把实机覆盖率与任务成功、语义碰撞指标区分开来阅读。
定量结果:碰撞率下降,成功率也有代价
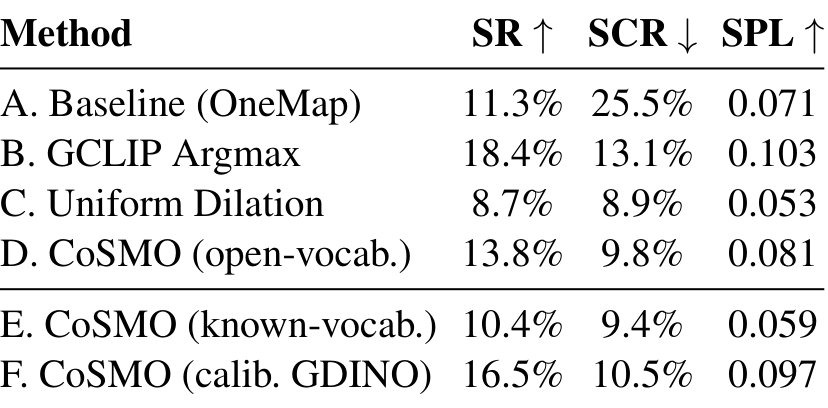
表 1:MP3D 全验证拆分 2,195 episodes 上的主结果。指标为成功率 SR、语义碰撞率 SCR 和成功加权路径长度 SPL。
以 OneMap 几何基线为参照,开放词表 CoSMO 将 SCR 从 25.5% 降至 9.8%,相对下降 61.6%,SR 从 11.3% 升至 13.8%。但要评估保形校准带来的增益,更直接的比较是相同 GCLIP 特征下的 Argmax 与 CoSMO:SCR 从 13.1% 降至 9.8%,SR 从 18.4% 降至 13.8%,SPL 从 0.103 降至 0.081。换句话说,语义碰撞减少的同时,任务完成率下降了 4.6 个百分点。
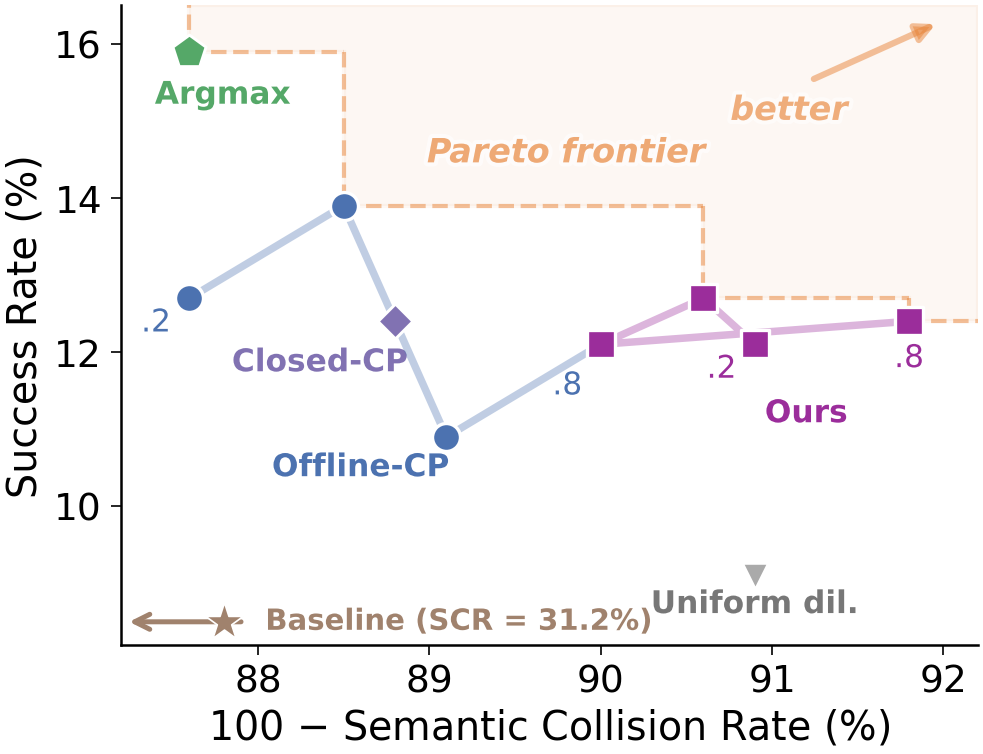
图 4:330 个消融 episodes 上安全率与成功率的 Pareto 前沿,展示不同覆盖目标下的安全—效率折中。
图中比较了 Argmax、闭集保形、固定阈值 Offline-CP、统一膨胀和 CoSMO。CoSMO 在多种覆盖水平下获得较低 SCR,统一膨胀则更保守但成功率更低。该图支持在线校准有助于调节折中关系;不过样本是 330 集消融拆分,不能把曲线上某个点直接当作普遍导航水平。
消融:词表规模与专家反馈
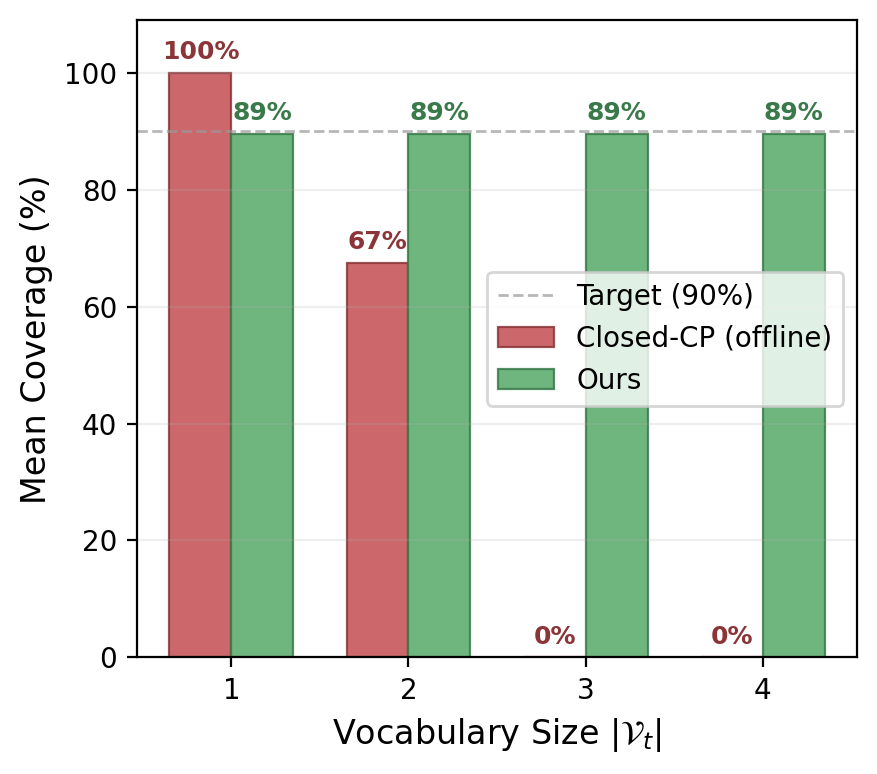
图 8:词表从 1 类增长至 4 类时的经验覆盖率。闭集 Offline-CP 覆盖率降至 0%,CoSMO 维持在约 89%。
随着候选词表变大,闭集 Softmax 分数依赖的归一化项也改变,导致这组试验中闭集方法的覆盖率快速下降;CoSMO 的成对嵌入分数不受类别总数影响,因此保持在目标值附近。这个结果针对人工扩大的类别词表,标签实际发现依然依赖专家。
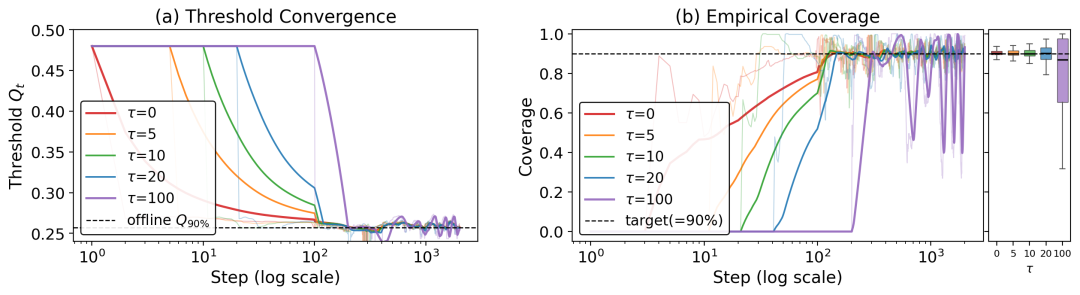
图 5:专家反馈延迟 τ 对 ACI 阈值收敛和经验覆盖率的影响;较大的延迟会增加在线振荡。
不同延迟条件下,阈值都趋近约 Q₉₀%=0.257,覆盖率趋近 90% 目标,但 τ 越大,前期振荡越明显。实验表明算法可以在所测延迟范围内校准,并不意味着任何动态分布下都不受时延影响。
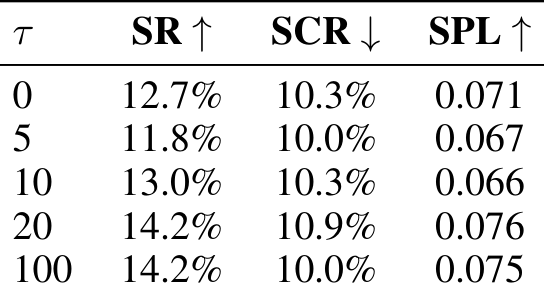
表 6:330 个消融 episodes 下的延迟敏感性结果,列出不同 τ 的 SR、SCR 与 SPL。
表中 τ=0、5、10、20、100 时 SCR 依次为 10.3%、10.0%、10.3%、10.9%、10.0%,没有随延迟单调恶化。SR 在 11.8%–14.2% 之间变化,SPL 在 0.066–0.076 之间。样本较少且指标离散,适合说明当前实验未发现明显趋势,不足以推出实时部署完全不受延迟影响。
定性与场景分析
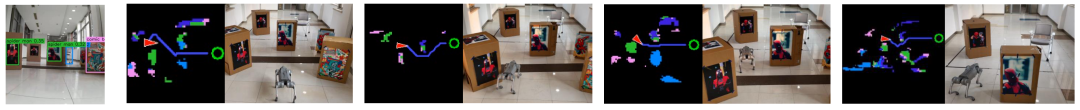
图 6:Go2 在约 3.5 m × 10 m 的室内环境中寻找椅子并避开语义障碍;不同颜色表示 GCLIP 在观察间变化的 Argmax 标签。
视觉语言模型对障碍的单标签判断会随视角变化。作者用延迟 Grounding-DINO 反馈构造校准覆盖集,并在两间室内场景共做 30 次导航:CoSMO 的任务成功率为 46.67%,语义碰撞率为 16.67%;GCLIP Argmax 的障碍标签 top-1 准确率为 58.06%,CoSMO 的真实标签经验覆盖率为 90.73%,接近 90% 目标。覆盖率是候选集包含真标签的比例,不等同于任务成功率或零碰撞率。
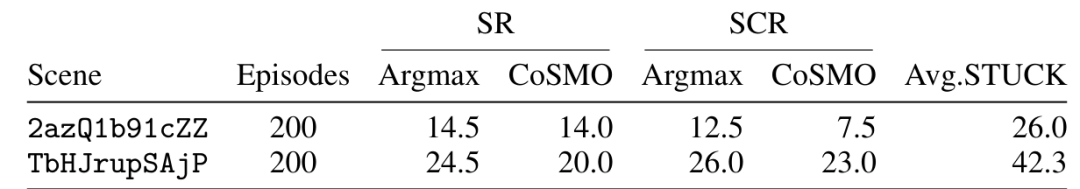
表 5:两个 MP3D 场景各 200 episodes 的 Argmax 与 CoSMO 对照,同时报告平均 STUCK 比例。
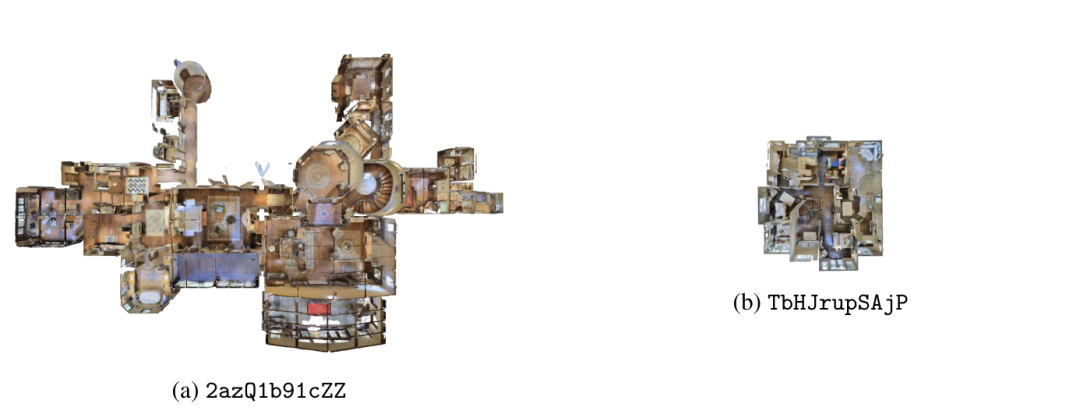
图 7:表 5 中较开放和较受限两个场景的俯视布局。
在较开放场景中,SCR 从 12.5% 降至 7.5%,SR 只从 14.5% 变到 14.0%;较受限场景中,SCR 从 26.0% 降到 23.0%,SR 则从 24.5% 降到 20.0%,平均 STUCK 为 42.3%。两组结果提示安全膨胀的任务代价与可用绕行空间有关,场景差异不能只用类别识别精度解释。
覆盖目标与噪声专家
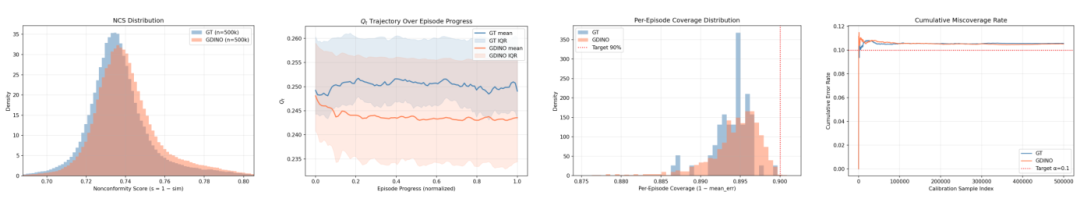
图 9:GT 与 Grounding-DINO 专家下的分数分布、阈值轨迹、episode 覆盖率和累计误覆盖率。
四组诊断曲线大体相近,经验覆盖率分布接近 90% 目标,累计误覆盖率也接近 α=0.1。这说明 Grounding-DINO 在作者测试设置中能替代 GT 标签参与校准;但形式化理论仍基于可靠专家标签,噪声标签如何改变覆盖保证还没有完整界定。
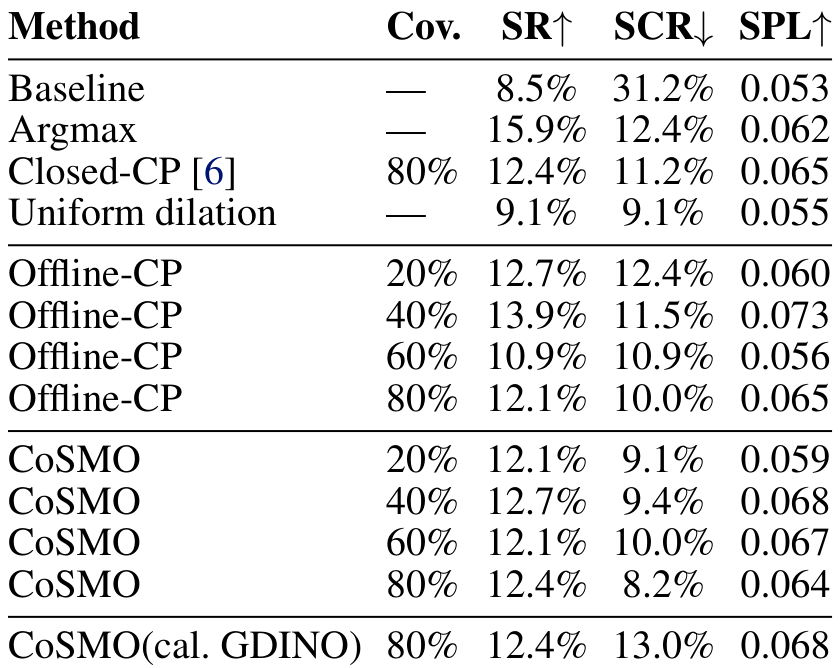
表 7:330 个消融 episodes 上不同覆盖目标的 SR、SCR 和 SPL 全量结果。
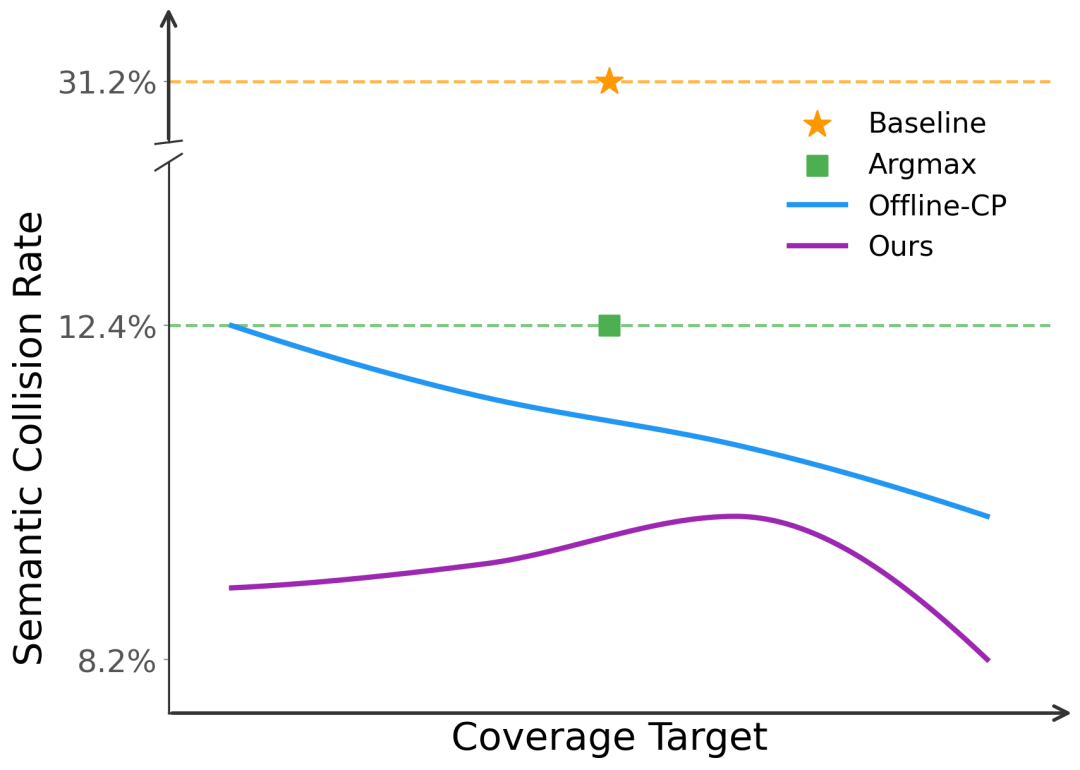
图 10:不同目标覆盖率下 CoSMO 与 Offline-CP 的 SCR 曲线。
在 20%、40%、60%、80% 覆盖目标下,CoSMO 的 SCR 分别为 9.1%、9.4%、10.0%、8.2%,Offline-CP 则为 12.4%、11.5%、10.9%、10.0%。Grounding-DINO 校准版本在 80% 目标下 SCR 为 13.0%,高于 GT 校准的 8.2%。覆盖目标改变了安全与路径可达之间的平衡,因此应和表中的 SR、SPL 一起判断。
代码与复现条件
作者公开了 CoSMO 的核心仿真代码,并在仓库中提供评测配置、地图更新、校准和规划模块。仓库采用 MIT 许可,但没有分发 MP3D 数据或模型权重;复现仍需另行准备场景数据和视觉模型 checkpoint,并配置 Habitat-Sim、CUDA 等依赖。真实机器人测试使用 Unitree Go2、GCLIP 和延迟 Grounding-DINO。
边界与思考
CoSMO 的方法价值在于把视觉语义不确定性变成现有地图规划器可以消费的空间安全代价,并且让类别字典能够在线增长。实验覆盖了词表规模、延迟、噪声专家和地图布局,证据比单一成功率数字更完整。
但安全收益有明确边界。类别的安全距离由实验字典指定;标签未发现时系统回退到零语义膨胀;理论结果还要求可靠障碍检测、可靠专家标签、邻域覆盖和受限的分布漂移。主仿真中 SCR 大幅下降,但与 GCLIP Argmax 相比 SR 也下降;实机样本仅 30 次、两个室内场景。
总结
CoSMO 为开放词表语义导航提供了一个较清晰的在线校准接口:把候选类别集合映射为最坏情形安全半径,再交给常规规划器执行。论文通过 MP3D 主集、延迟与词表消融以及 Go2 实机试验展示了这一设计的潜力。现有结果支持它在已发现类别、特定专家与实验环境下减少语义碰撞;未知类别的发现前安全、噪声专家的理论边界、狭窄环境下的成功率代价和数据权重获取仍需继续验证。
原文链接: https://www.leiphone.com/category/private/poGEBtrQNBBAaF7L.html
