


来源:AI Paper每日精选
文章链接:https://mp\.weixin\.qq\.com/s/KW1BTOYgc6VqjICMy\_raGw
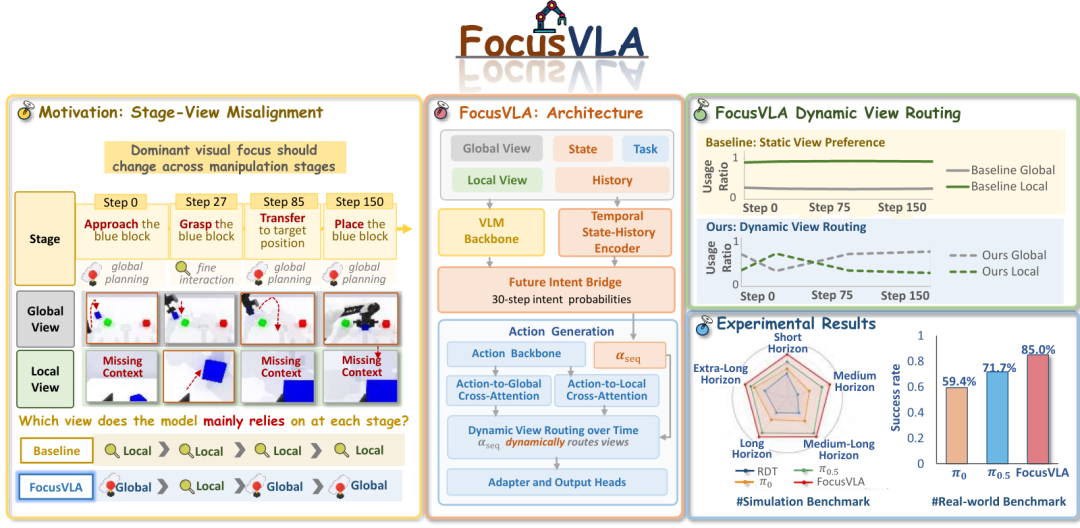
多视角输入的 VLA 模型,嘴上说着「全局+腕部互补」,注意力却几乎全程黏在腕部相机上:该看全局规划的阶段它不看,该切回局部操作的阶段它又不调。这篇 CoRL 2026 论文让模型先预测「接下来要干什么」,再用这个意图去调度该看哪个视角。
多视角输入的 VLA 模型,嘴上说着「全局+腕部互补」,注意力却几乎全程黏在腕部相机上:该看全局规划的阶段它不看,该切回局部操作的阶段它又不调。这篇 CoRL 2026 论文让模型先预测「接下来要干什么」,再用这个意图去调度该看哪个视角。
论文:FocusVLA: Future-Intent Guided Dynamic View Routing for Vision-Language-Action Models
机构:南京软件技术研究院、中国科学院软件研究所、中国科学院大学南京学院、南京邮电大学、河海大学
会议:CoRL 2026(已录用)
论文:https://arxiv\.org/abs/2610\.31423
「多视角」经常只是多接了台相机
视觉—语言—动作(VLA)模型已成为机器人操作的重要范式,它把视觉感知、语言理解和动作生成统一在一个模型里。而可靠的操作需要充分观察到物体、末端执行器与它们的空间关系,因此多视角输入被广泛用来提供互补信息——全局相机看工作区整体,腕部相机看精细接触。
这篇论文的起点是一个诊断实验:现有的 VLA 模型并没有真正用上这种互补性。作者拿 π₀.₅ 这个多视角基线,逐动作步统计全局与局部视角的注意力比例(和为 1,多个腕部相机求和记为局部),并定义两个量:
D_t = | a_t^global − a_t^local |,D = (1/T) Σ_{t=1}^{T} D_t
L_t = a_t^local,ΔL_t = L_t − L_{t−1},V_{ΔL} = Var( {ΔL_t}_{t=2}^{T} )
前者是支配裕度,衡量全局—局部有多不平衡;后者是局部依赖的时间变化量,衡量这个依赖会不会随任务推进而调整。读法很明确:D 越大说明某个视角的支配越强,V_{ΔL} 越小说明视觉依赖随时间调整得越少。
观测结果是——成功和失败的 rollout 都偏向局部视角,说明「偏好腕部」本身很常见、不必然有害;但失败的 rollout 支配裕度更大、V_{ΔL} 更小。也就是说,失败不是因为它偏向局部,而是因为它偏得太死、而且不会随阶段调整。
但注意力比例不必然等于因果依赖,所以作者补了一个阶段条件化的视角屏蔽实验:在 Stack Blocks Three 任务上每个设置跑 20 次 rollout,分别在全局规划阶段屏蔽全局或局部视角。逻辑是:如果策略真在用全局观测做规划,屏蔽全局应该掉得更狠。结果恰好相反:
1. 无屏蔽:成功率 85.0%;
2. 规划阶段屏蔽全局:掉到 65.0%(−20.0 pp);
3. 规划阶段屏蔽局部:掉到 20.0%(−65.0 pp)。
屏蔽局部掉得更惨,说明即便在全局规划阶段,这个静态多视角基线依然高度依赖局部观测。注意力分析与因果干预互相印证,共同指向「阶段无关的视角依赖」这个病灶。
方法(一):未来意图桥——从动作历史推断「接下来要看什么」
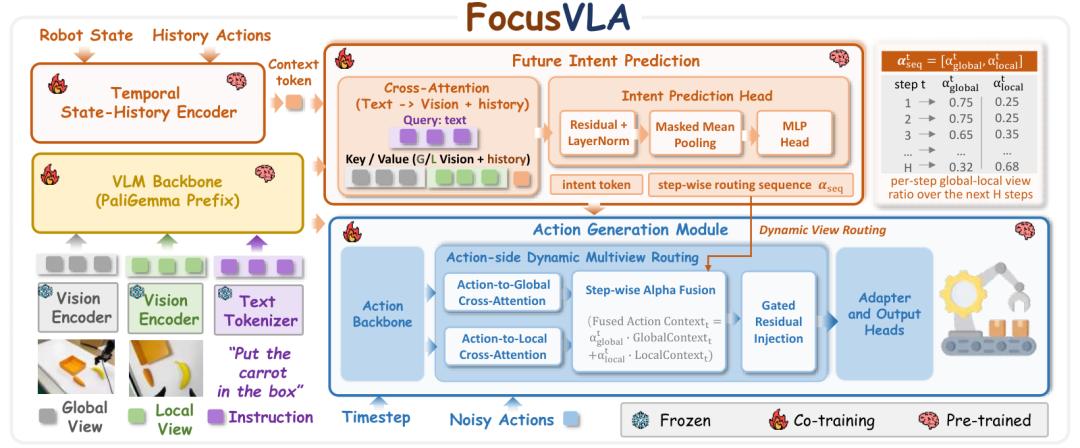
FocusVLA 建在 π₀.₅ 多视角骨干之上。输入包括全局与局部观测 o_t = { I_t^g, I_t^l }、语言指令 L、机器人状态 s_t,以及短时动作历史 h_t;输出是未来的一段动作块 A_t = [a_t, a_{t+1}, …, a_{t+H−1}]。与静态融合的分野在于:FocusVLA 用未来动作趋势去指导视角依赖,让视觉依赖能随任务推进演化。模型由两个模块组成——未来意图桥预测未来交互意图、产出块级意图 token 与逐步路由权重;动作侧动态路由用这些信号在动作生成过程中调节全局与局部视觉上下文的贡献,不修改预训练骨干。
未来意图桥先编码近期动作动力学得到时间摘要,再做跨模态注意力——以语言特征为 query,以视觉与状态历史特征为 key/value,得到用于预测未来意图的上下文表示。基于这个表示,桥输出一段逐步意图序列:
I_t = [ i_t^(1), i_t^(2), …, i_t^(H) ]
其中 i_t^(k) ∈ [0, 1] 表示第 k 个未来动作步需要「面向局部交互」的视觉证据的概率;相应地,1 − i_t^(k) 可理解为工作区级运动(如目标定位、物体搬运)的概率。这个序列被用两次:
1. 聚合成块级意图 token:z_intent = MLP_token( Pool(I_t) ),概括整段未来的交互趋势;
2. 转成路由权重:α^(k) = f_route( i_t^(k) ),其中 α^(k) = [ α_g^(k), α_l^(k) ] 是非负且和为 1 的权重,控制第 k 步里全局与局部视觉上下文的相对贡献。f_route 是一个固定的有界线性映射,保证两个视角的互补信息都保留。
方法(二):用轨迹自动造弱监督,不靠人工标注阶段
意图预测需要监督信号,而人工给每帧标「这是规划阶段还是交互阶段」显然不现实。论文的解法是从末端执行器轨迹自动构造弱监督标签 y_t^(k) ∈ {0, 1}:先把所有时间步初始化为「运动导向」标签 0,再从动力学里识别交互导向的区间——有夹爪闭合信号时,闭合前的短窗口算高置信交互区间;否则把交互区间识别为被更高速运动包围的低速局部运动(用平移速度、累积路径长度、轴向支配线索判断),并过滤掉「像搬运中途停顿」的短低速暂停;落在区间内的步标 1,其余保持 0。
训练目标写成带类别权重的逐帧二分类交叉熵:
?_intent = − (1/T) Σ_{t=1}^{T} ( λ₊ · y_t · log p_t + λ₋ · (1 − y_t) · log(1 − p_t) )
论文特意说明这些标签只作弱监督用,不是硬性的语义阶段标注;推理时直接从多模态上下文与动作历史预测连续意图概率。支撑判定的运动学量是末端执行器的平移速度与旋转速率:
v_t^a = ‖ x_t^a − x_{t−1}^a ‖₂,r_t^a = 2·arccos( | ⟨ q_{t−1}^a, q_t^a ⟩ | )
双臂取两侧最大值,再按速度分位数划分高速段(v_t ≥ p₇₀(v))与低速段(v_t ≤ p₄₅(v)),并用累积路径长度的 p₈₀ 分位数导出动态阈值。
方法(三):动作侧路由——在动作生成端融合视角,而不是改编码器
有了路由权重,第二个模块负责把它们真正用起来。动作骨干先基于噪声动作 token、块级意图 token 与扩散时间步嵌入(经自适应 RMS 归一化注入),生成整段未来动作特征;然后以这些动作特征为 query,分别与全局、局部视觉特征做交叉注意力,为每个未来动作步 k 抽出全局与局部的动作上下文,最后按逐步权重融合:
Fused Action Context_t = α_t^global · Global Context_t + α_t^local · Local Context_t
这里有一个刻意的设计选择:在动作生成侧重塑视角权重,而不是去改视觉编码器内部的多视角表示。理由是——视角的选择本来就该由「这一步动作需要什么」来决定,把调制放在动作侧,视觉信息才能按每个动作步的需求被挑选与融合。路由信号通过门控残差注入动作通路,整体训练目标是:
?_total = ?_act + λ_intent · ?_intent
实验:仿真 +10.10 pp,真机 +13.3 pp
仿真评测在完整的 RoboTwin 2.0 基准上做,覆盖 50 个操作任务,每任务 100 次试验,对照 RDT、π₀、π₀.₅,所有方法使用相同演示数据、优化步数、测试种子与协议。结果是 FocusVLA 平均成功率 76.92%,比最强基线高出 10.10 个百分点。短时程任务平均 74.00%(π₀.₅ 63.10%),其中 LiftPot 从 π₀.₅ 的 35.0% 提到 60.0%、RotateQrcode 从 56.0% 提到 71.0%;中时程任务平均 67.80% 对 π₀.₅ 的 54.90%,Move Can Pot 从 75.0% 到 93.0%、Move Pillbottle Pad 从 50.0% 到 79.0%。增益在中长时程任务上更明显,这与「视角重要性随时段变化」的动机正好吻合。
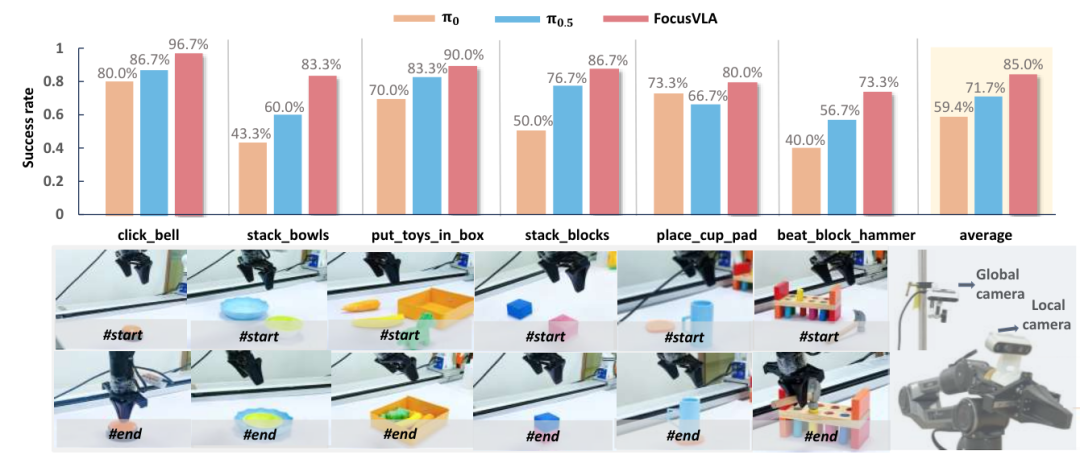
真机评测用 Piper 机械臂配两台 Intel RealSense D435i(分别做全局与局部观测),在六个代表性任务上各跑 30 次试验。FocusVLA 平均成功率 85.0%,比 π₀.₅ 高 13.3 个百分点、比 π₀ 高 25.6 个百分点,且在全部六个任务上都是最好的。论文还单独测了空间重排下的执行适应性:物体位置被重新摆放,要求策略重新做目标定位与接近路径规划。
消融:意图监督本身贡献了 18 个百分点
消融在 9 个任务上做(每任务 2 个种子、各 100 次试验),完整版 FocusVLA 平均成功率 73.7%(95% 置信区间 [71.6, 75.7])。逐项拆开:
1. 路由信号:换成全局共享的静态分配掉到 67.5%(−6.2 pp)——全局统一的视角偏好无法满足「样本相关、步相关」的视觉需求;换成只用当前视觉相关性掉到 57.4%、用时间/状态捷径掉到 58.5%,分别低 16.3 与 15.2 pp——当前的视觉相关性、或时间与状态的捷径,都替代不了「多模态未来意图」;
2. 监督目标:E2E Future 保留同样的路由架构与意图 token 通路,但只用动作损失优化,掉到 55.7%(−18.0 pp)。这条最有说服力:它排除了「提升只是来自多插了一个路由网络」的解释——显式的未来意图监督是学到有效路由的前提;
3. 块级 vs 步级条件:保留逐步路由、但去掉块级意图 token 掉到 63.3%(−10.4 pp)。说明两条通路互补:逐步路由决定「每一步看哪里」,块级 token 提供「整段任务要做什么」的全局约束;
4. 正则化:换成 RDT 式的训练期随机视角丢弃只到 54.6%(−19.1 pp)。
为什么有效:视角选择应该是「动作的因」,不是「输入的果」
这篇论文最值得琢磨的一点,是它对调制位置的选择。
多视角融合的常见做法是在视觉编码器里就把多个视角的特征合掉——拼接、交叉注意力或加权求和。但融合一旦发生在编码器端,视角权重就变成一个与当前时刻相关的静态量:它知道「此刻画面里有什么」,却不知道「接下来这一步动作需要看哪里」。这正是诊断实验里那条「视角依赖惯性」的来源。
FocusVLA 把决策顺序倒过来:先问「接下来要做什么」,再决定「看哪里」。未来意图是从动作历史里推出来的(那里已包含机器人自己的运动趋势),天然带有「下一步是搬运还是精细接触」的先验;把这个先验变成逐步视角权重、再作用到动作生成的交叉注意力上,视角选择就成了动作意图的下游结果。消融从正反两面验证了这条因果链:只看当前视觉不够(−16.3 pp)、按时间或状态机切视角也不够(−15.2 pp),而把意图监督拿掉掉得最多(−18.0 pp)——证明真正起作用的不是多出来的那层网络,而是那层网络被要求预测的未来。一句话总结 FocusVLA:让视角选择成为动作意图的下游结果,而不是视觉输入的静态副产物。
原文链接: https://www.leiphone.com/category/private/lkMEb8XVpDdglCcu.html
