


来源:中国图像图形学会CSIG
文章链接:https://mp\.weixin\.qq\.com/s/Q2gpFovDTTRAAkMzeXa\_\-g


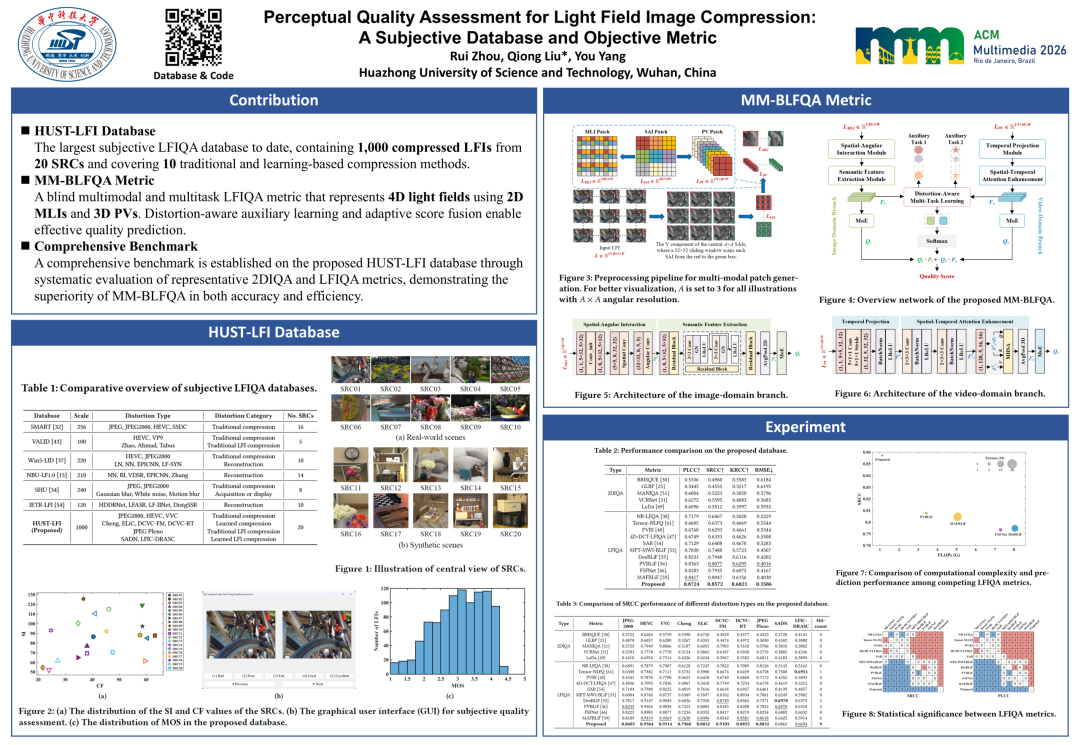
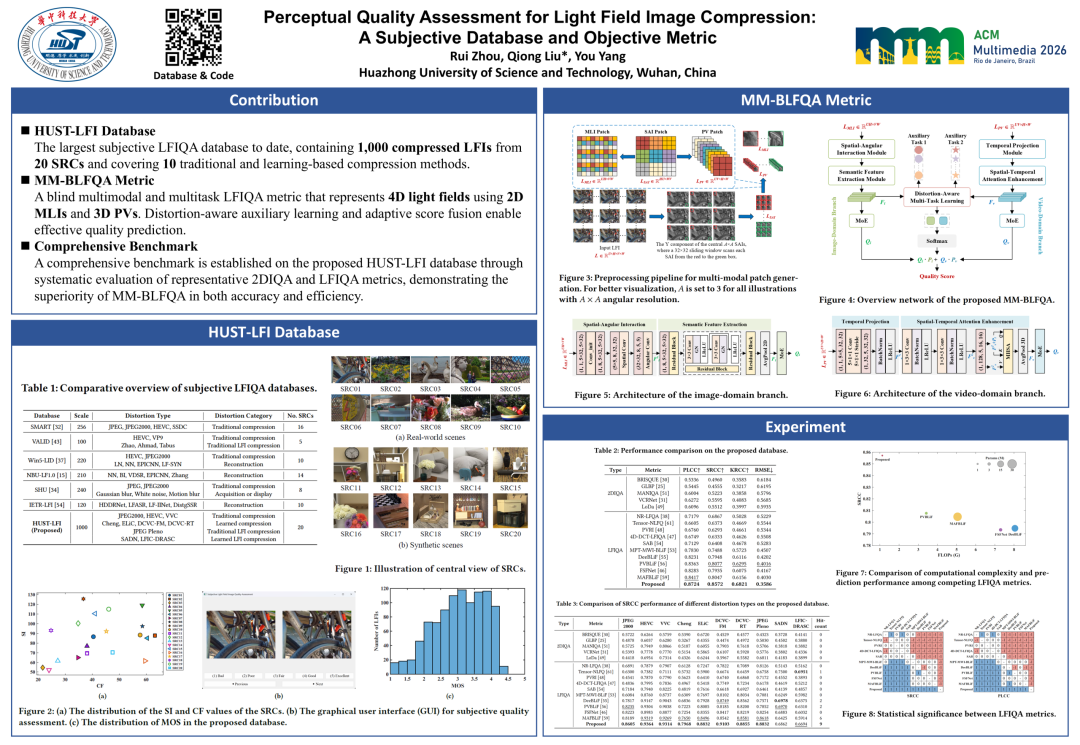
Perceptual Quality Assessment for Light Field Image Compression: A Subjective Database and Objective Metric
作者:周锐、刘琼、杨铀
单位:华中科技大学
论文简介:本文聚焦光场图像压缩的感知质量评价,构建了涵盖20个场景、10种压缩方法和1000幅失真光场图像的HUST-LFI主观数据库,并提出多模态多任务盲质量评价方法MM-BLFQA,联合建模光场的图像域与视频域信息,实现准确高效的质量预测。
Paper 链接:
https://github\.com/oldblackfish/HUST\-LFI/blob/main/paper\.pdf
Code 链接:
https://github\.com/oldblackfish/HUST\-LFI


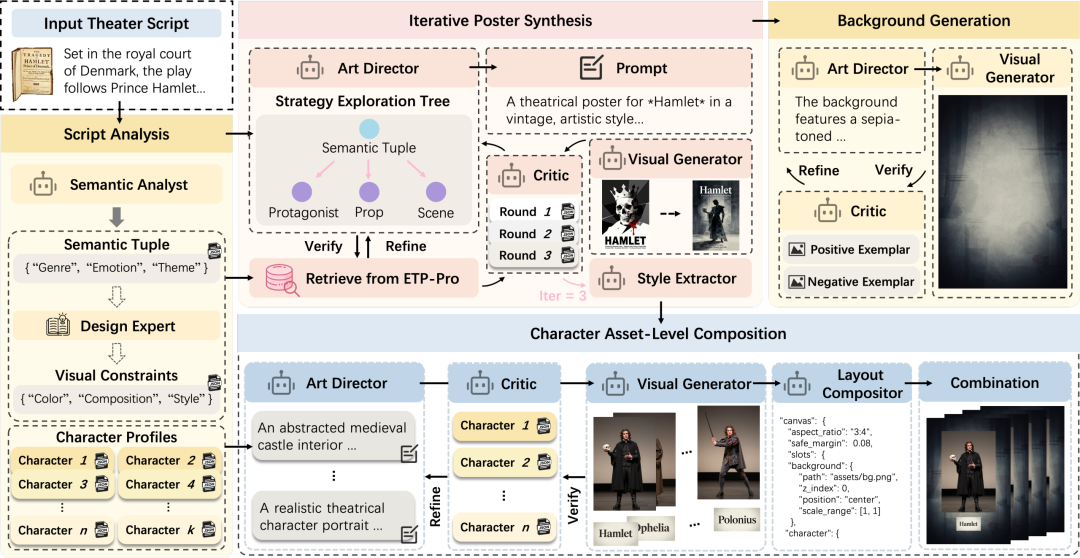
ETPDesigner: Multi-Agent Orchestration for Interactive Multimodal Electronic Theater Program
作者及对应单位:李梦甜(上海大学、上海电影特效工程技术研究中心)、郭心如(上海大学)、林小茹(上海大学)、容晓(上海大学)、谢志峰(上海大学、上海电影特效工程技术研究中心)、陈超锋(武汉大学人工智能学院、武汉数学与人工智能研究所)
论文简介:我们提出ETPDesigner,一种面向影视戏剧电子场刊生成的多智能体框架。该系统可从剧本自动生成风格统一、内容丰富的电子场刊,并通过角色动画、语音合成与大语言模型赋予虚拟角色交互能力。同时构建ETP-Pro基准,推动智能化影视内容创作研究。
Paper 链接:
https://arxiv\.org/pdf/2607\.19947
Code 链接:
https://umunmun\.github\.io/ETPDesigner/


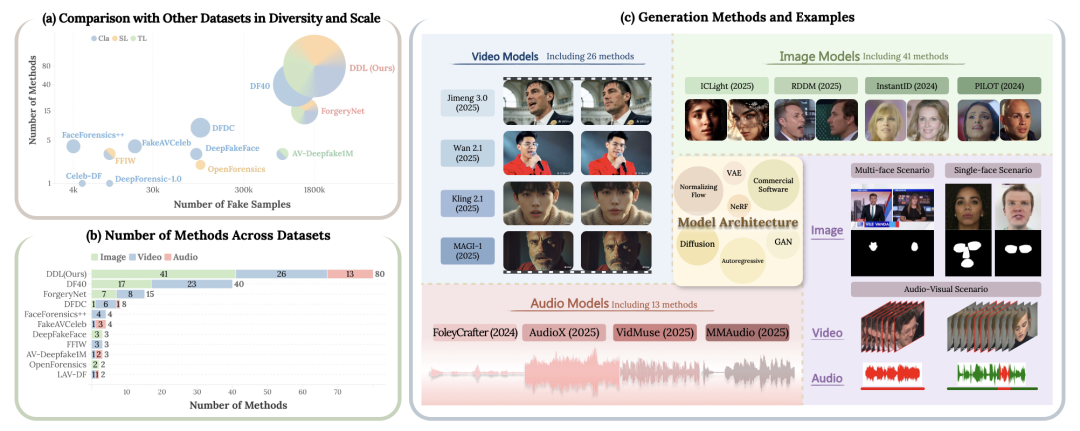
DDL: A Large-Scale Datasets for Deepfake Detection and Localization in Diversified Real-World Scenarios
论文简介:本文构建大规模深度伪造检测与定位数据集DDL,包含140万余伪造样本、80种方法、10类篡改模式及多场景多模态数据,并提供精细空间掩码与时间片段标注,为复杂环境下的检测、定位和可解释研究提供重要基准。
Paper链接:
https://openreview\.net/pdf?id=yKZFMopqOS
Code链接:
https://github\.com/inclusionConf/DDL


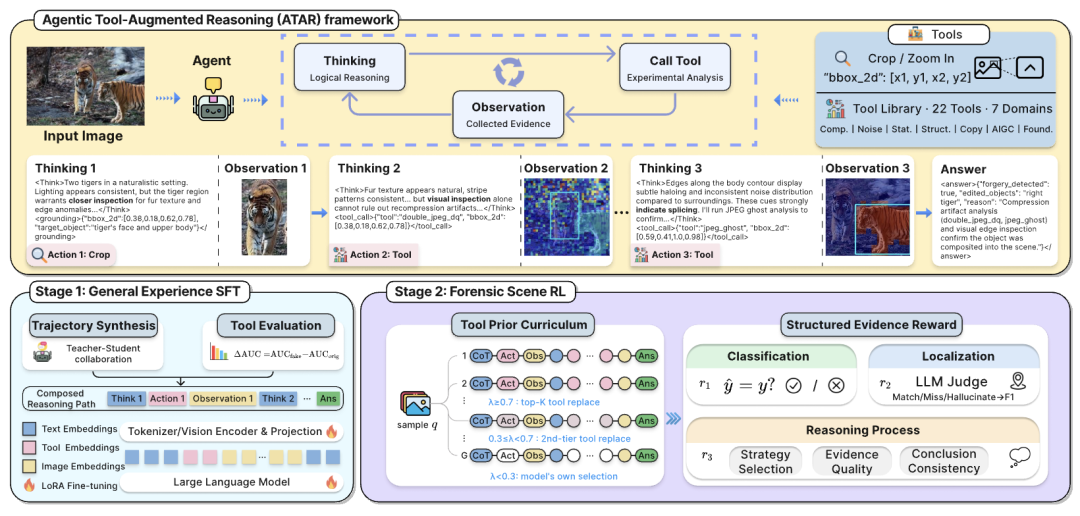
Agentic Tool-Augmented Reasoning for Explainable Image Forgery Detection
论文简介:本文提出智能体工具增强推理框架ATAR,融合22种取证工具,通过语义异常分析和伪造痕迹提取,实现图像伪造检测、定位与解释,并采用课程学习优化工具调用及证据推理。实验表明,方法性能优异,能够生成可追溯的解释。
Paper链接:
https://openreview\.net/pdf?id=Y6Fs4mcehQ


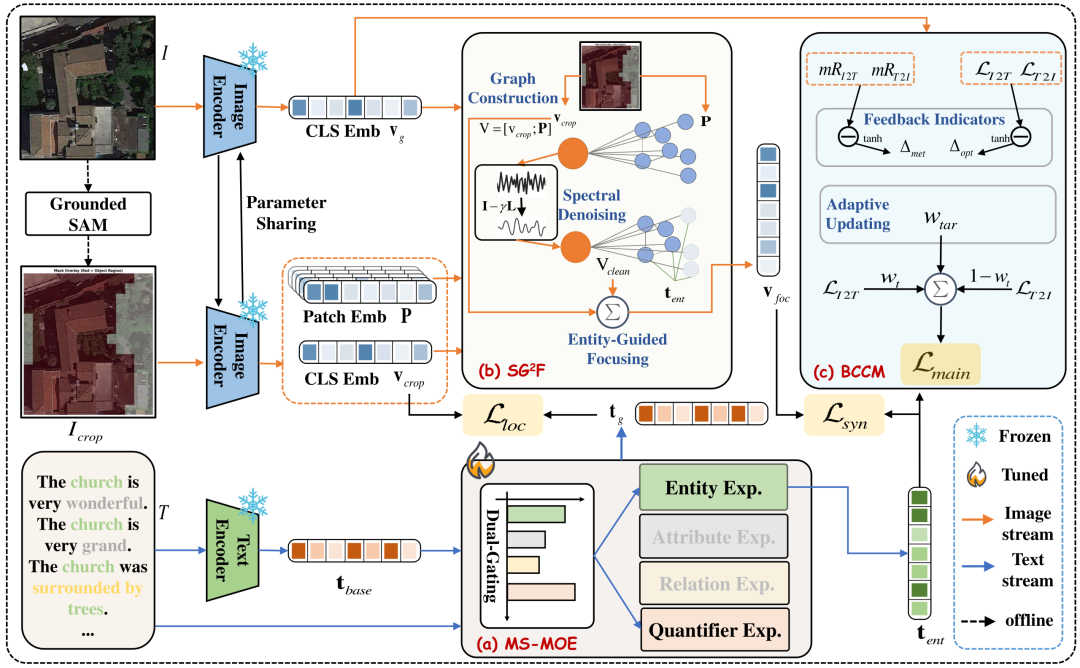
DFPR: Dynamic Fine-Grained Perceptive Bidirectional Image-Text Retrieval
论文简介:动态细粒度感知双向图文检索通过多结构混合专家模块解耦文本中的不同语义角色并提取实体锚点,利用谱图引导聚焦模块,在实体语义指导下聚合关键目标特征,通过双向校准约束机制动态调整训练权重,缓解优化偏置。
Paper链接:
Code链接:
https://openreview\.net/pdf?id=3ApAMVloY5


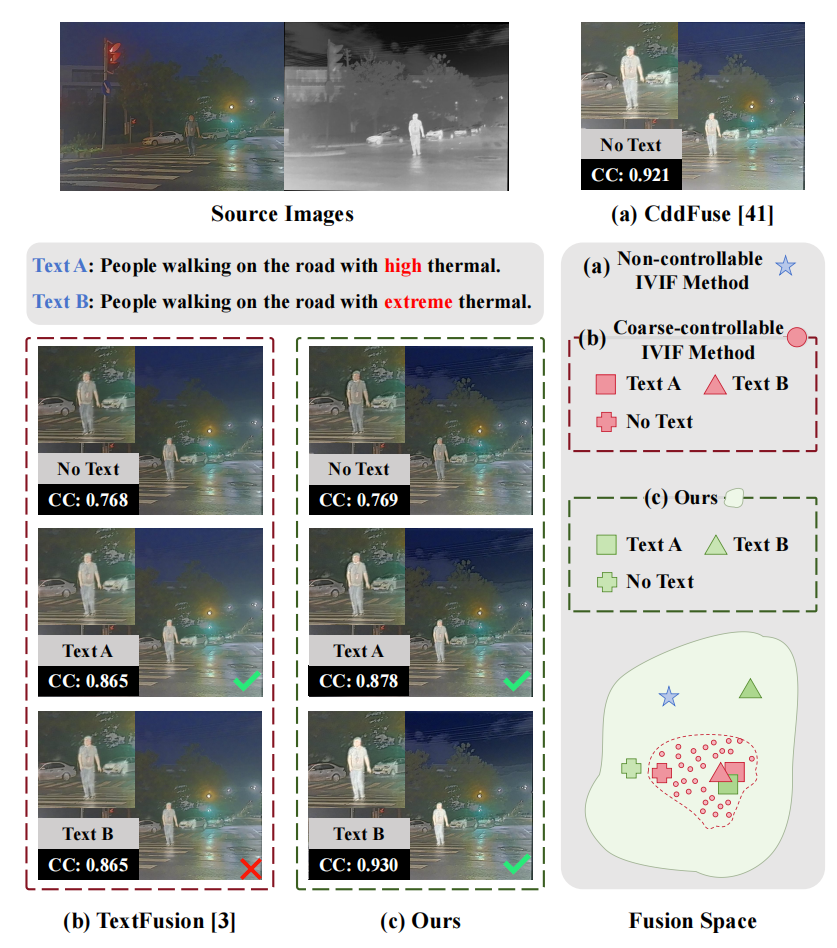
ConFusion: Continuous Fusion Space Learning for Fine-Grained Controllable Infrared and Visible Image Fusion
论文简介:针对现有方法依赖离散控制条件,难以满足灵活调控需求,我们提出ConFusion,一种面向红外与可见光图像融合的可控生成框架,支持细粒度的实例级连续调制。ConFusion通过高斯条件建模连续融合空间,采用双分支结构解耦模态共性特征与特有特征,并借助Grounded SAM生成的实例掩码和文本语义对齐,实现区域感知调制。推理时,多模态大语言模型解析用户意图并生成调制变量。实验表明,ConFusion在融合质量和下游任务上均达最优性能。
Paper链接:
https://arxiv\.org/abs/2607\.23600
Code链接:
https://github\.com/HeyufeiAnto/Confusion


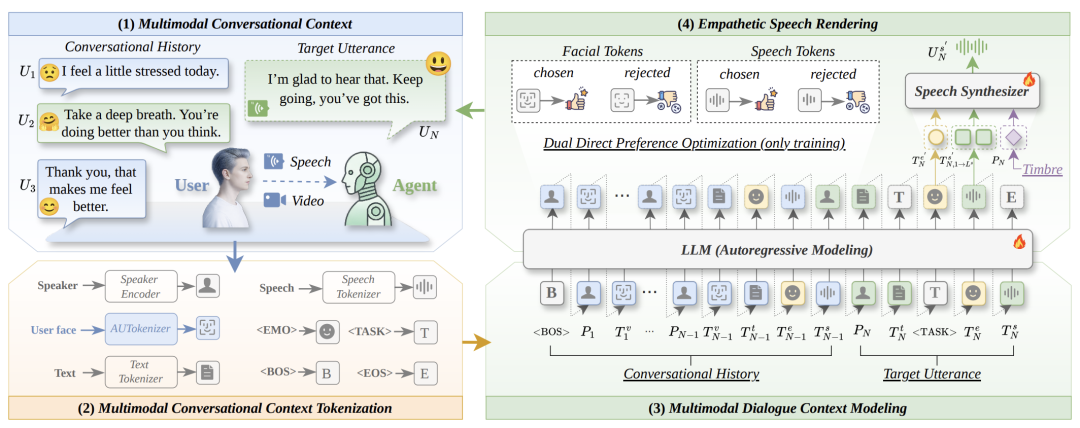
Let Me Look at You: Advanced Facial Expression Modeling for Conversational Speech Synthesis
论文简介:对话语音合成旨在生成上下文一致、富有表现力和共情能力的语音。然而,现有方法忽视面部表情中的情感线索,限制了多模态情感理解。针对上述问题,我们提出FacialTalker,一种基于大语言模型的面部表情感知对话语音合成框架。
Paper链接:
https://arxiv\.org/pdf/2607\.24430
Code链接:
https://github\.com/walker\-hyf/FacialTalker


原文链接: https://www.leiphone.com/category/private/kPXTHZi57ck7BYZt.html
