


来源:灵初智能
文章链接:https://mp\.weixin\.qq\.com/s/Qx9A8rhG576JbU2p9g7nJw
近日,北大-灵初联合实验室提出的研究成果RoboFFT 被CoRL2026正式接收。RoboFFT是一种面向生成式机器人策略的强化学习后训练方法。它利用扩散模型和流模型预训练时已有的前向加噪过程,构造策略更新所需的近似概率比,让机器人根据任务反馈继续改进。研究在仿真任务、视觉语言动作模型和四项真机操作任务中进行了验证。
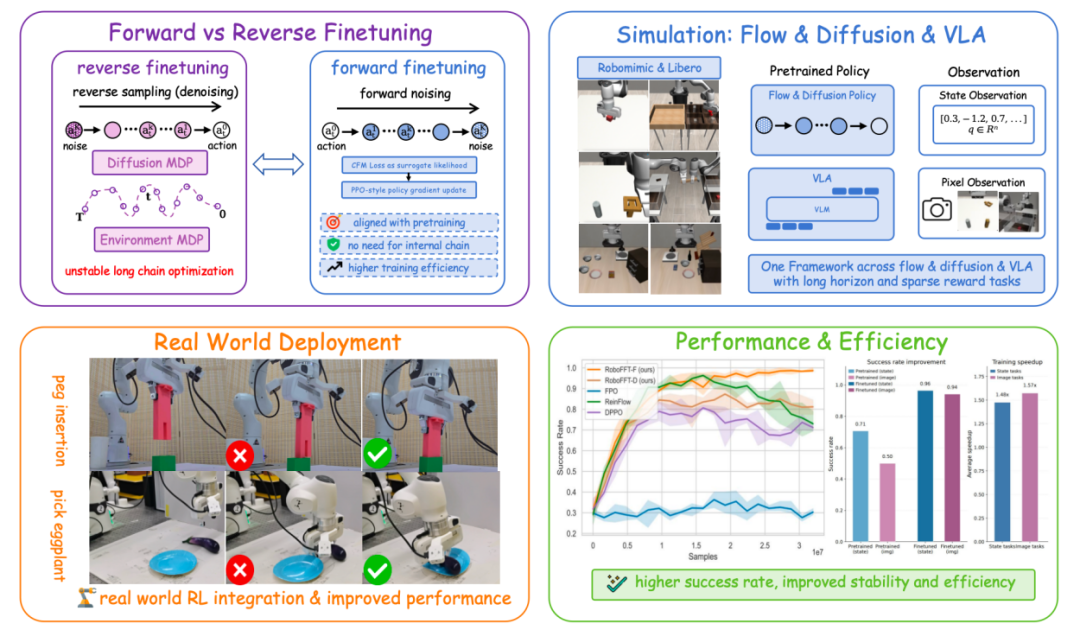
RoboFFT框架概览
论文地址:https://arxiv\.org/pdf/2609\.32236
项目网站:https://student\-of\-holmes\.github\.io/RoboFFT/
开源代码:https://github\.com/shshsunny/RoboFFT
为什么生成式策略难以直接使用Policy Gradient?
扩散模型和流模型能够从人类示范中学习复杂动作。但示范无法覆盖执行时的所有变化:物体位置偏移、抓取角度不准,或某一步没有完成,都可能让机器人遇到训练数据中少见的状态。强化学习则可以利用任务成功或失败的反馈,继续改进策略。PPO更新策略时,需要比较同一个动作在新旧策略下出现的概率。生成式策略通过采样过程得到动作,最终动作的精确概率通常难以直接计算。已有方法可以沿多步去噪过程构造优化信号,但也会增加计算和显存开销。RoboFFT 的思路是利用模型原有的前向加噪训练损失,提供策略更新所需的信号。
RoboFFT如何更新策略?
机器人先用当前策略执行任务,记录观察、动作和任务反馈。更新时,RoboFFT 对已经执行的动作加噪,分别计算它在新旧模型下的匹配损失,再用损失差构造近似策略概率比。这个比值结合动作的优势估计,用于 PPO 风格的裁剪更新。
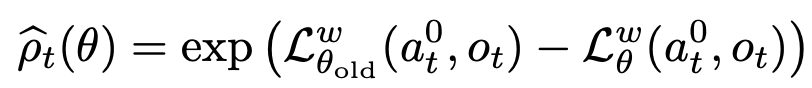
这里得到的是用于优化的代理比值,并非精确的动作概率比。为减少估计波动,方法会对噪声进行多次采样,并用温度参数调节比值的尺度。对于通常采用确定性采样的流策略,RoboFFT 还会在采集交互数据时加入可控噪声,让机器人尝试不同动作。
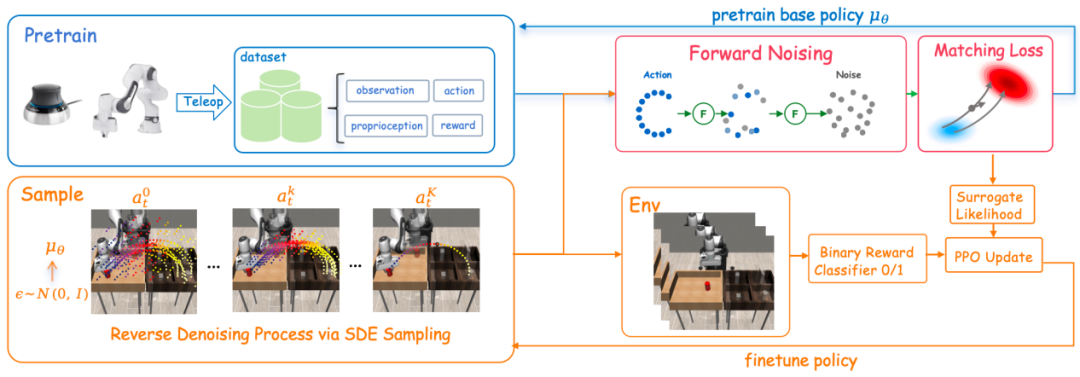
RoboFFT方法概览。从示范预训练、机器人交互,到对已执行动作进行前向加噪并更新策略
仿真实验
研究在 Robomimic 的 Lift、Can、Square 和 Transport 任务中测试了 RoboFFT,覆盖状态输入和图像输入,以及流策略和扩散策略。在较难的长程任务中,尤其是图像输入设置下,RoboFFT 展现出较稳定的性能提升。各设置的完整成功率曲线如下。
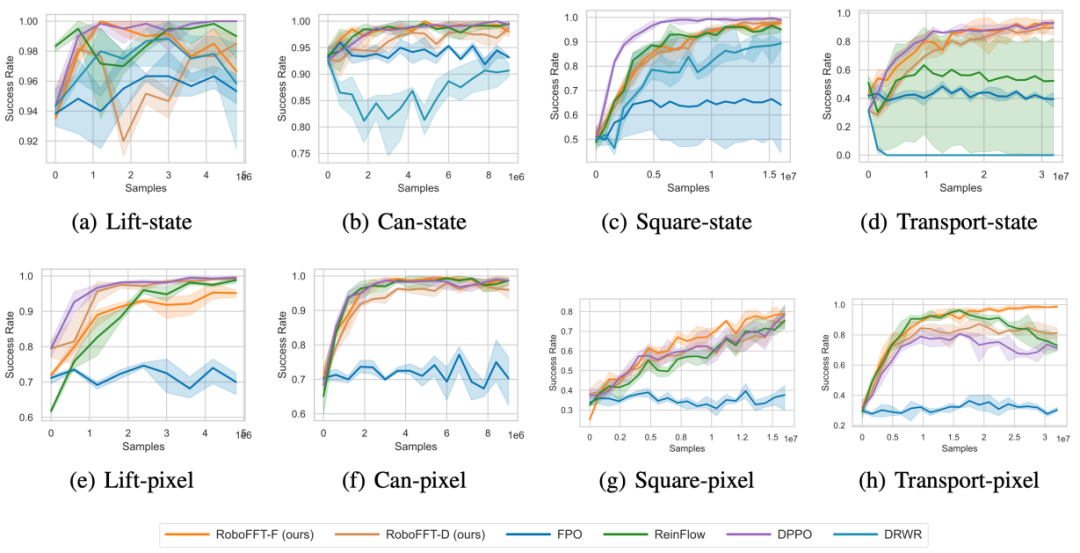
Robomimic任务在状态输入和图像输入下的成功率曲线
论文还将这一方法用于视觉语言动作模型 π₀ 的流式动作头,在LIBERO-Object 和 LIBERO-Spatial 任务上测试了后训练效果。
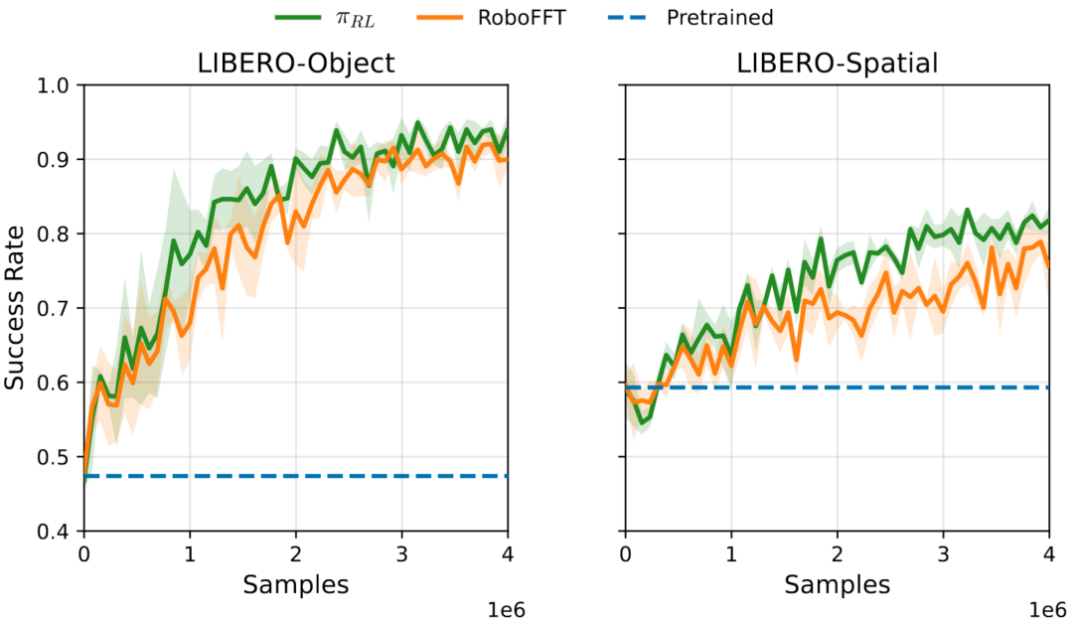
视觉语言动作模型在两组 LIBERO 任务中的后训练表现
训练耗时对比中,RoboFFT 的流策略版本相对 ReinFlow 平均加速1.53 倍;扩散策略版本在四个状态输入任务上相对 DPPO 平均加速38.0 倍。这里统计的是策略和价值网络的训练时间,不包含环境数据采集。
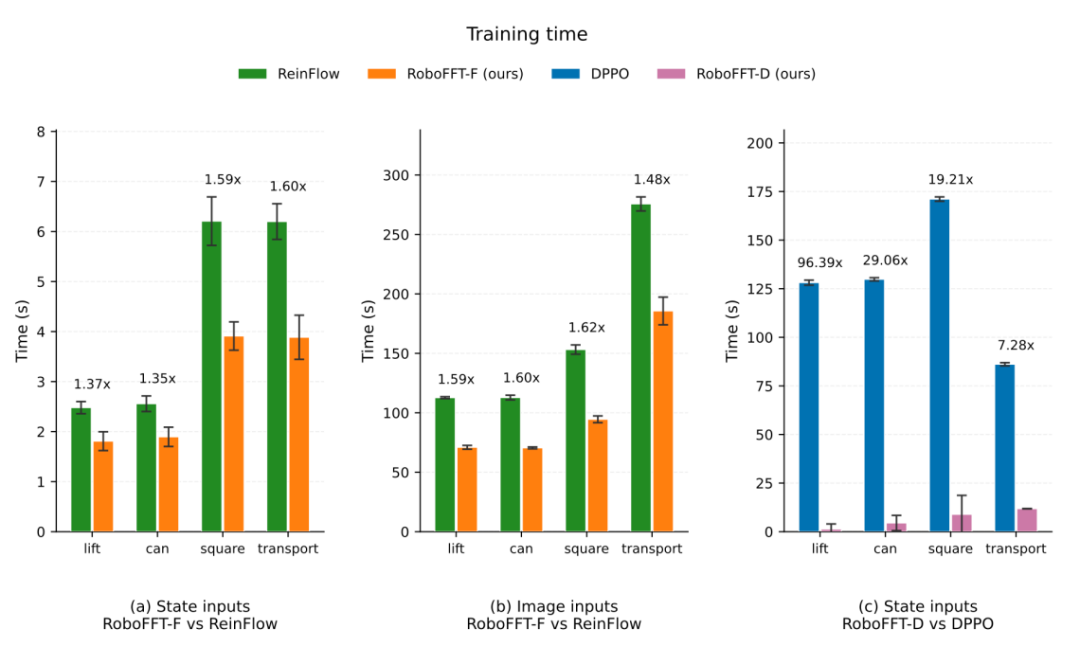
RoboFFT 与对应方法的每轮训练耗时对比
策略在关键步骤更集中地选择高质量动作。图 6 展示了 Square 任务中一次成功执行的过程。研究在相同轨迹状态下,比较预训练策略与后训练策略生成的动作,并借助辅助价值模型评估动作质量。在抓取、搬运和对齐等关键阶段,后训练策略的动作质量指标提高,采样动作的多样性则有所降低。这一图示分析表明,策略的变化集中出现在影响任务完成的决策步骤。这里的动作质量来自辅助模型评估,并不是每个动作在真机上的直接成功率。
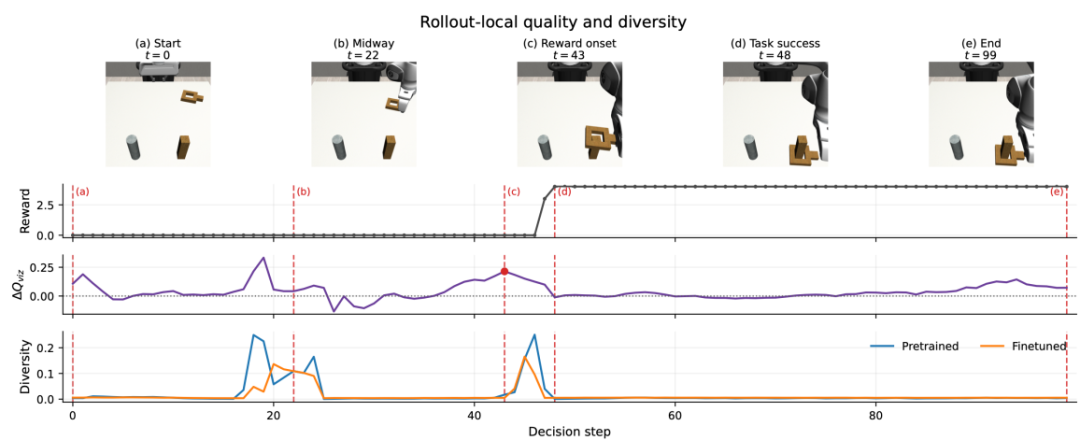
一次成功执行中,任务进展、辅助动作质量指标及动作多样性的变化
探索噪声需要适中。RoboFFT 对流策略加入采样噪声,让机器人在交互时探索不同动作。图 7 左侧显示,在 Robomimic Square-state 任务上,噪声过小难以形成有效探索,训练表现会下降;噪声过大同样会影响任务成功率。中等噪声强度取得了更好的平衡。图 7 右侧比较了计算代理比值时使用的蒙特卡洛采样次数。在这一流策略实验中,将采样次数从 1 次增加到 2 次有助于更快收敛,继续增加次数的收益则较有限。这是该任务和策略设置下的观察,不能推断所有生成式策略都只需要少量采样。
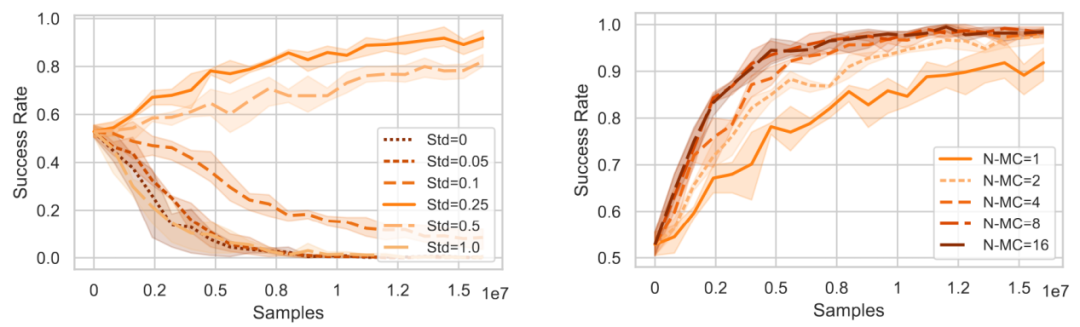
左图比较探索噪声强度,右图比较估计代理比值时的采样次数
真机实验结果
真实机器人交互较慢,数据采集成本也高。研究因此采用离线到在线的流程:先用人工遥操作示范预训练流策略,再结合机器人采集的轨迹进行离线强化学习及模仿学习,最后继续通过在线交互更新。任务反馈采用人工判断的成功或失败。
实验覆盖插销插入、抓取茄子、倾倒和柜内取物,每项任务各测试 20 次。从预训练、离线后训练到在线后训练,四项任务的成功次数分别为:
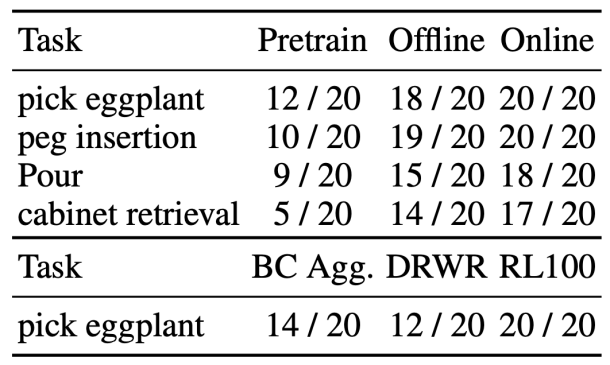
四项真机任务在不同训练阶段的成功率,及抓取茄子任务上的方法对比
在抓取茄子的相同数据预算对比中,仅汇集数据继续做行为克隆达到14/20;RoboFFT 离线后训练达到18/20,在线后训练达到20/20。这一结果表明,性能提升不能仅用增加数据来解释,利用任务反馈更新策略也发挥了作用。
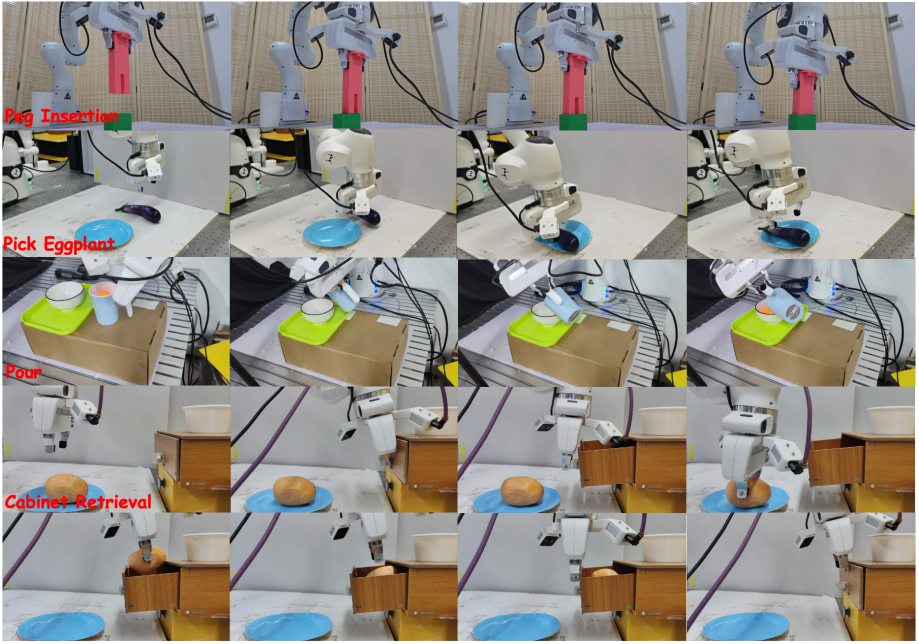
真机执行画面
结语
RoboFFT 展示了一条生成式机器人策略的后训练路径:先从示范中学习,再利用实际执行的任务反馈改进。它复用前向加噪的匹配损失,为强化学习提供可计算的策略更新信号。
原文链接: https://www.leiphone.com/category/private/B5D6i7ABmXnBr8Hj.html
