


来源:深度强化学习CASIA
文章链接:https://mp\.weixin\.qq\.com/s/EV6qf3uNGc\_85ZqkHV3NMg
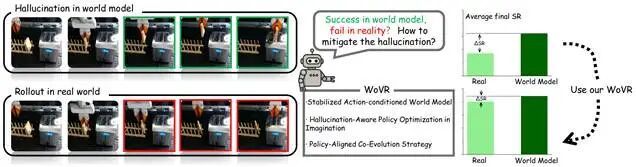
中科院自动化所深度强化学习团队联合清华大学、北京中关村学院等机构,提出了面向视觉语言动作模型(VLA)后训练的强化学习框架WoVR。针对“世界模型中的成功,未必能在真实机器人上复现”这一核心问题,WoVR通过控制世界模型的幻觉与预测误差,让机器人策略能够在更可靠的想象环境中训练,并将学习收益迁移到真实机器人操作中。
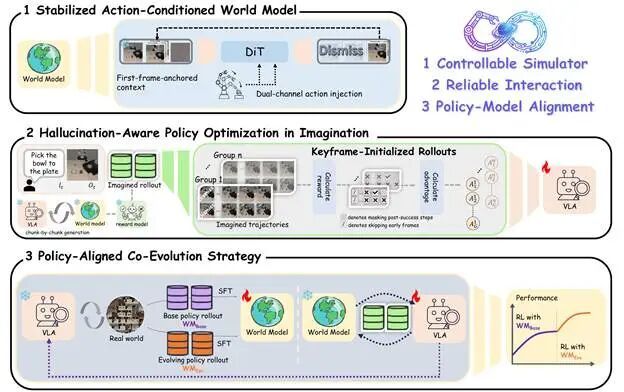
2.1模型层—让生成结果响应动作并保持场景稳定
2.2 交互层—从关键状态开始练习
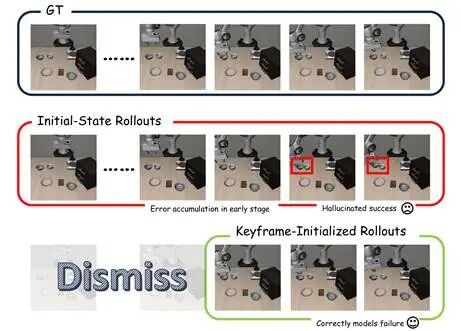
2.3 对齐层—随策略更新模型
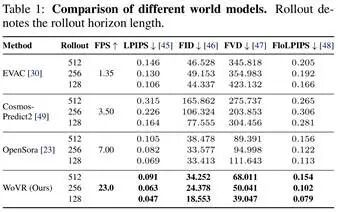
3.1 世界模型质量与生成效率
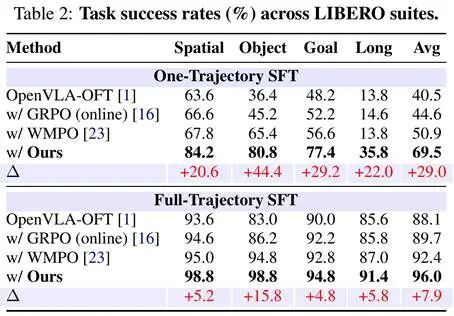
3.2 one-shot 与 full-shot 初始化后进行强化学习后训练
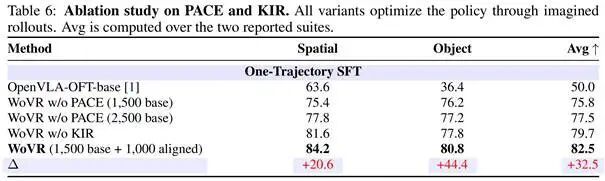
3.3 消融实验:KIR 与 PACE 的作用
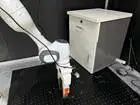
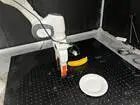
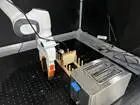
3.4 真实机器人迁移
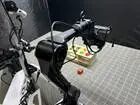
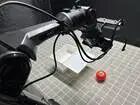
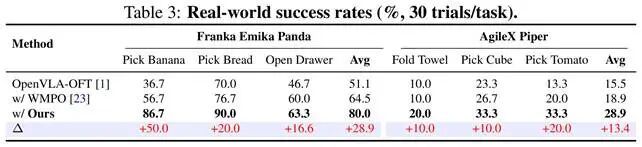
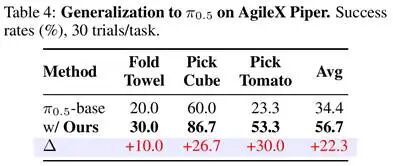
3.5 不同 VLA 骨干上的应用
原文链接: https://www.leiphone.com/category/private/raPPTlJe64awl5UI.html
Loading...
TS
