


来源:高效智能计算与学习
文章链接:https://mp\.weixin\.qq\.com/s/FNW\_t22HaMBRK6IN\_AbpHQ
CoRL 2026 会议简介
标题:ACE-VLA: Action Centric Evaluation for Token Pruning in Vision-Language-Action Models
作者:PeihuanNi*, Zeyu Zhu*, Weifan Guan, Zitao Mo, Minnan Pei, Tielong Liu, Junwen Si, Qinghao Hu, Peisong Wang, Gang Li, Jian Cheng (*Equal Contribution)
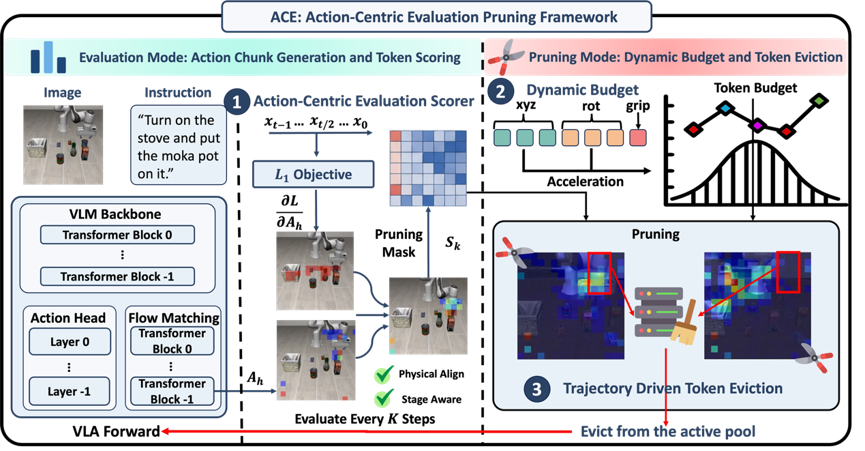
图1. 方法架构
简介:Vision-Language-Action(VLA)模型将视觉、语言和机器人动作统一到一个端到端框架中,但大量视觉Token也带来了很高的推理成本。现有VLA加速方法通常沿用VLM中的Token剪枝思路,根据视觉与文本之间的Attention判断哪些视觉Token更加重要。然而,机器人操作具有明显的阶段性:同一条任务指令在整个执行过程中不会改变,但机器人真正需要关注的区域却会随着动作不断变化。例如,在“打开炉灶,然后把摩卡壶放到炉灶上”的任务中,机器人首先应该重点关注炉灶开关;完成开启动作后,视觉重点则应该转移到摩卡壶及其把手。如果始终根据文本语义判断Token重要性,就很难及时反映这种操作阶段的变化。
针对这一问题,论文提出ACE-VLA(Action-Centric Evaluation),核心思想是:不再问“这个视觉Token和文本有多相关”,而是直接问“这个视觉Token对机器人接下来生成的动作有多大影响”。ACE首先将VLA预测的一段Action Chunk通过L1范数聚合成一个标量目标,然后计算该目标相对于视觉Attention的梯度,并利用Gradient × Attention得到每个视觉Token的Action Relevance。简单来说,如果某个视觉Token发生变化会明显影响机器人下一步动作,那么它就是当前阶段的重要Token;反之,则可以优先剪枝。相比传统Vision-Text Attention,ACE得到的视觉关注区域能够随着机器人动作阶段动态变化,更集中地落在当前真正需要操作的物体和交互区域上。在Action-Centric Scorer之外,ACE还设计了Kinematic-Driven Dynamic Budget根据任务状态动态调整及计算开销和Trajectory-Driven Token Eviction机制来进一步减少计算量。
论文在π0、π0.5和OpenVLA-OFT三个VLA模型上进行了LIBERO和真实Franka机械臂实验。结果显示,ACE最高能够减少约39%的FLOPs。对于π0和π0.5,ACE均实现约1.33倍推理加速,同时平均成功率反而提升2.0和1.7个百分点;对于OpenVLA-OFT,成功率仅下降0.3个百分点,但获得了1.57倍加速。在真实机器人实验中,ACE也分别实现1.34倍、1.36倍和1.55倍加速,同时基本保持甚至略微提升任务成功率。
--- End ---
高效智能计算与学习团队(CLab)隶属中国科学院自动化研究所,致力于高效神经网络计算和智能科学计算等理论方法研究,在模型压缩与加速、神经网络加速器设计、组合优化求解、强化学习、具身智能等方向上取得了丰硕的成果,并广泛应用于电力、石化、航天等行业。

中国科学院自动化研究所CLab主页:https://clab\.ia\.ac\.cn
原文链接: https://www.leiphone.com/category/private/nzjug7O2t4lGxUS1.html
