来源:多模态信息融合
文章链接:https://mp.weixin.qq.com/s/_BBmHCa8DMXBF1TBuUneng
ACM MM 2026 · IMAGE FUSION
再做多模态融合

最难的就是:让模型能够识别哪些是场景本身,哪些只是环境干扰?
SGPDFuse 使用DINOv3进行语义先估计“变化因素”
再只融合本征信息,最终让一个模型承担三种融合任务。





论文标题:SGPDFuse: Semantically-Guided Physics-Disentanglement General Multi-Modal Image Fusion
作者:Haozhen Wei,Chengjun Jiang,Yutong Guo,Xinrui Ju,Xingyuan Li,Xiang Chen,Jinyuan Liu*。
单位:大连理工大学、香港城市大学、浙江大学;
论文链接:
https://arxiv.org/abs/2608.29220
一句话概括:SGPDFuse 不再把多模态融合看作是“盲目聚合”,而是在先本征场景信息Φ与环境/传感器的变化 Ψ打开之后只有Φ进入下一轮融合。
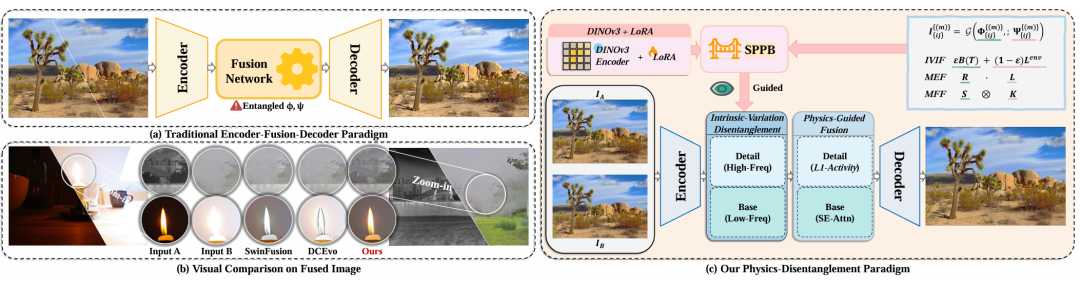
目前融合的方法大多使用加权求和、特征拼接或者更加复杂的注意力机制来“尽可能地保留信息”。作者认为这样的做法有一个共通的问题:输入本身就将场景的真实属性和外界的变化混为一谈了,后面网络再强大也可能会把不应该保留的干扰一起融合进去。
在红外-可见光融合的时候,热辐射会受到环境反射的影响而被污染;在多曝光融合的时候,反射率和照明混杂在一起;在多聚焦融合的过程中,清晰结构和模糊核相互缠绕。论文把三种成像过程统一地写成了:
其中,Φ 为要保留的 Intrinsic(本征)部分Ψ是需要被抑制的Variation(变化)成分。用这样的方式来表达,“如何融合”就变成了“先确定哪些东西不能融合”。
论文还用一个简单的加性情况来说明,在解耦之前就进行自适应加权,变化项仍然存在:
如果变化场是非负的,那么任何仍然包含Ψ的位置都不可靠一次加权自动“消失”。因此,作者认为伪影融合中最重要的并不是用一个更复杂的聚合器代替它,而是在于显式地估计Φ、抑制Ψ。


SGPDFuse 整体框架可以用以下四个步骤来概括:双分支编码、SPPB 估计变化置信图 W、Intrinsic–Variation 解耦、只对 Φ 做物理引导融合。训练过程分为两个阶段:首先进行编码器-解码器重建预训练,然后进行端到端微调,最后实现整个网络的融合。
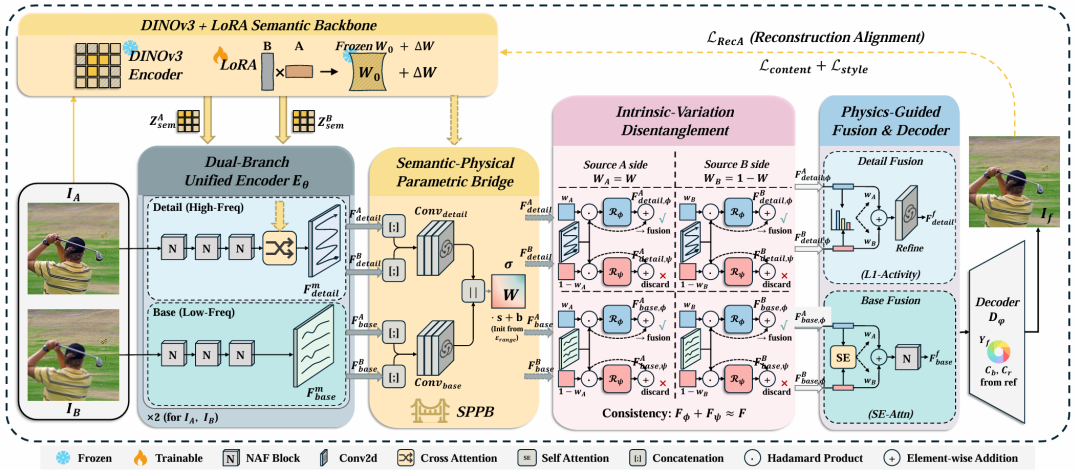
编码端把每一个输入都分成低频base和高频detail。base 负责承载低频结构和变化,detail 强调边缘、纹理以及清晰度。DINOv3 语义 token 只有在 detail 分支中被注入,并且单独送入 SPPB,用来推断物理变化参数。
SPPB(Semantic-Physical Parametric Bridge)就是本文的主要桥梁。它要将高层语义“翻译”成低层物理参数:IVIF 对应发射率,MEF 对应曝光最优性,MFF 对应聚焦概率。
论文使用了任务相关材料库M、DINOv3的空间语义特征进行软最近邻回归,首先得到每个像素的物理锚点,然后和编码特征一起预测W:
DINOv3 使用了LoRA适配(ViT-S/16,rank 32,α=64)来使语义特征对于材料和任务更加敏感。该设计的意义在于:模型不需直接测量发射率、照明或者模糊核,也可以从视觉语义中得到一个可以用于物理解耦的近似参数。
得到 W 后,SGPDFuse 在 base/detail 两个频段中都做同样的 Intrinsic–Variation 投影,并用两个残差校正网络补偿 Φ、Ψ 非严格正交问题:
两路输入使用的是互补分配律:W_A=W,W_B=1-W。作者承认这种互补性是近似的,但是利用RΦ/RΨ以及一致性约束使得网络能够在复杂的像素上继续自我修正。
最核心的一环就是:所有的Ψ在进入融合之前就被直接抛弃了。之后 base 层用带有 W 偏置的 SE 通道注意力来置信加权;detail 层使用 L1 活跃度来选出更加清楚的高频内容。
为防止“物理上干净,语义上却跑偏”这种情况发生,论文中又加入了ReconstructionAlignment(RecA)损失:一部分用DINOv3特征的余弦相似度来约束内容一部分使用了Gram矩阵来限制纹理风格。
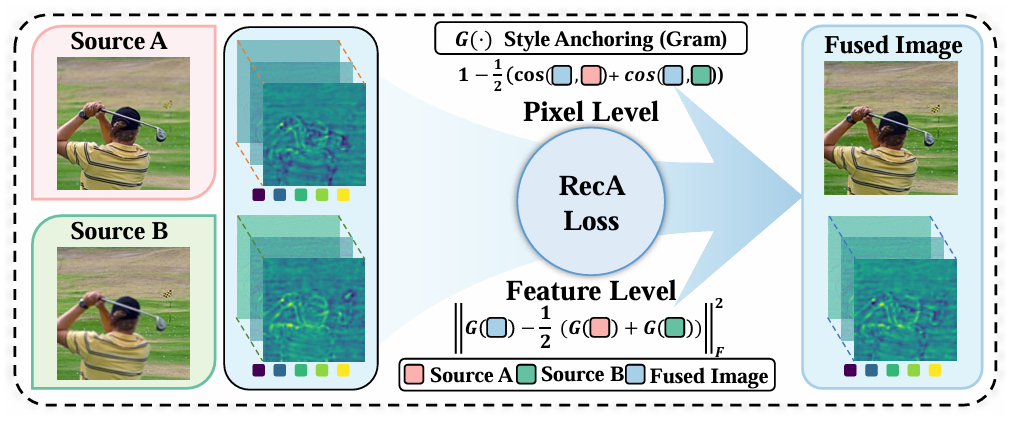
因此,SGPDFuse的方法逻辑并不是简单的“语义指导融合权重”,而是在语义上估计出物理变化,在物理解耦中决定哪些特征可以被纳入到融合当中去。


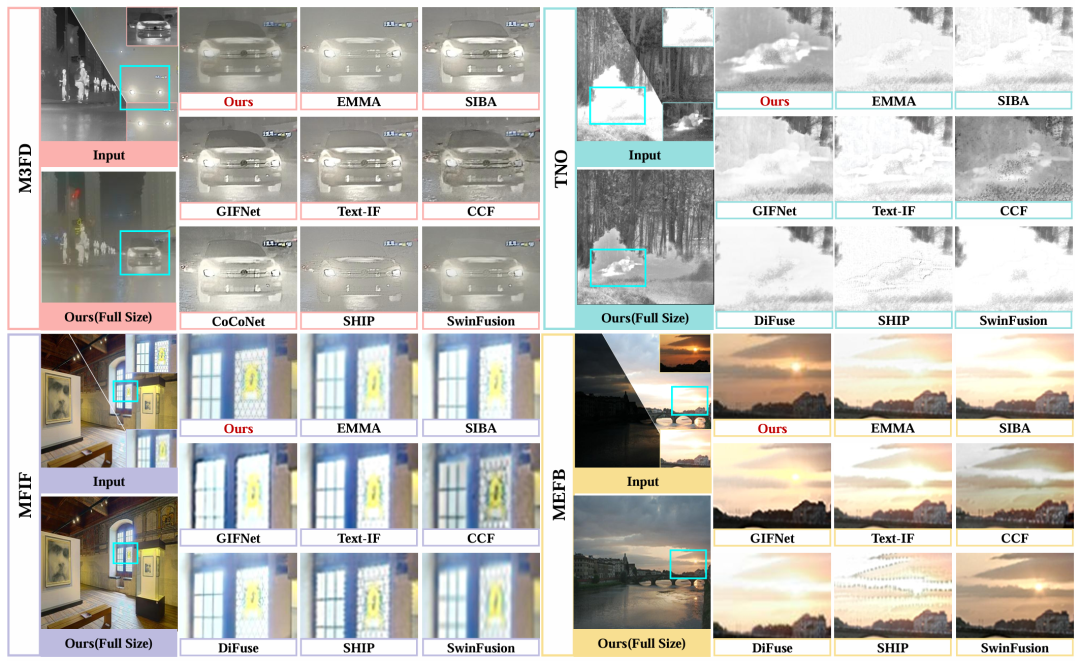
本实验涉及到三种典型的融合任务:红外-可见光融合(M3FD、RoadScene、TNO)、多曝光融合(MEFB)和多聚焦融合(MFIF)。下游的任务还会在M3FD中做目标检测,在FMB中做语义分割。
定量的结果里,论文提到SGPDFuse在四个基准、四项指标上都取得了最好的或者第二好的成绩。特别是结构相似性指标方面,作者给出的相对次优方法提升分别为:M3FD+0.07、T&R+0.09、MFIF+0.05、MEFB+0.02。
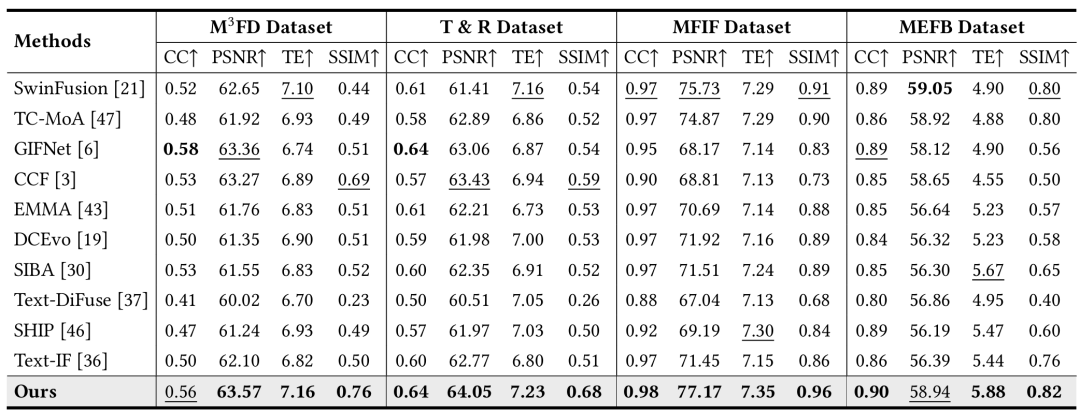 在四类数据集中进行CC、PSNR、TE、SSIM定量化比较
一些代表性的数据是:M3FD上PSNR为63.57,TE为7.16,SSIM为0.76;T&R上PSNR=64.05、TE=7.23、SSIM=0.68;在 MFIF 上,CC=0.98、PSNR=77.17、SSIM=0.96;MEFB上CC=0.90、TE=5.88、SSIM=0.82。
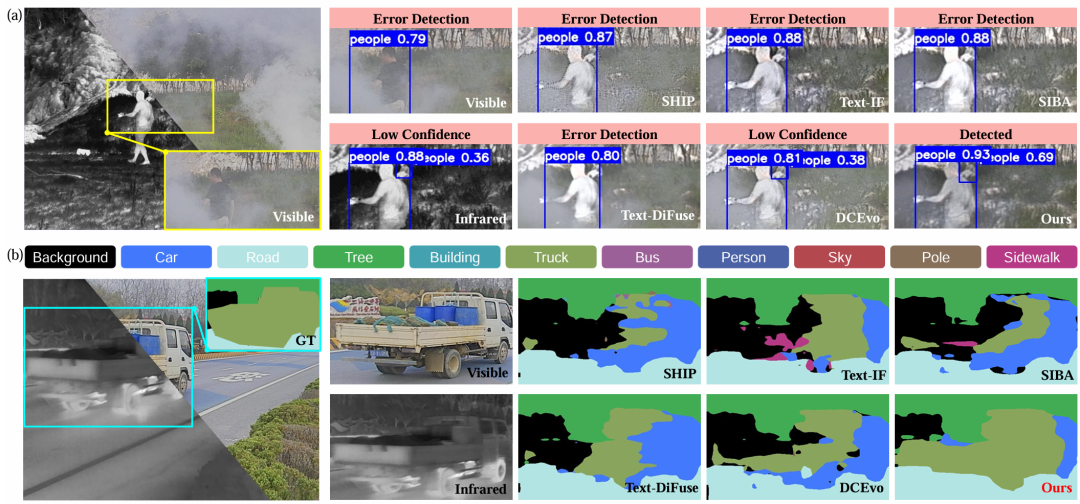
从可视化的角度来看,在红外场景中,车辆轮廓和地面纹理更加清楚;在多聚焦场景下,焦点过渡更为自然;而在多曝光场景中,则会同时恢复过曝和欠曝区域的细节。论文由此得出结论,SPPB 引导下的 Φ/Ψ 解耦对于各种物理干扰都具有相同的抑制效果。
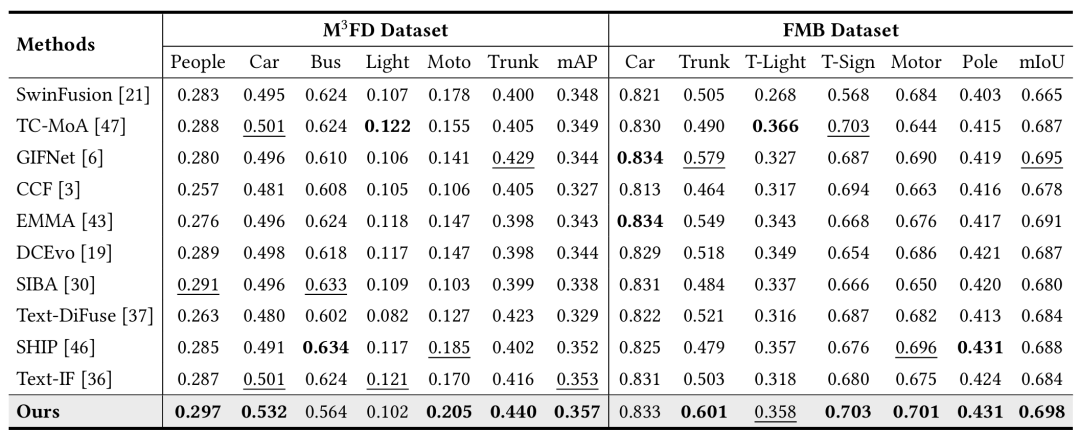
融合图像最后还是要为检测、分割服务。论文使用了YOLOv8s来对M3FD的目标进行检测,同时使用了SegFormer-B1来进行FMB语义分割,SGPDFuse整体mAP50:95为0.357。mIoU 为 0.698,均是表格中最高的。
消融实验也证实了这三部分是重要的。把SPPB换成固定的W=0.5之后,M3FD的SSIM由原来的0.76下降到现在的0.72;去掉Intrinsic-Variation解耦之后降到0.73;冻结DINOv3,不让LoRA进行适配的时候把LoRA的参数调到0.69。
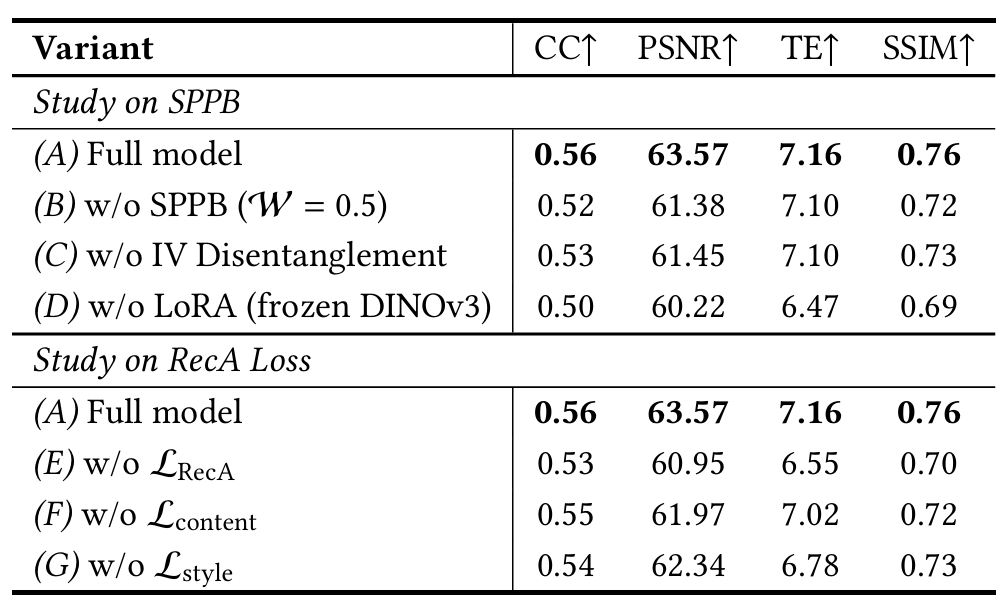
RecA 也不是“装饰项”,去掉完整的RecA之后,PSNR由原来的63.57降到现在的60.95、TE由原来的7.16降到现在的6.55、SSIM 由原来的 0.76 降低到了现在的 0.70;只去掉content或者style分支也都会带来语义漂移和纹理不一致的问题。
总结:SGPDFuse最有趣的地方,并不是又设计出一套更加复杂融合块了,而是一道题被重新表述为“先解耦本征和变化,再融合本征”。DINOv3+LoRA提供语义先验,SPPB把语义投影到物理变化参数上,Φ/Ψ分解把干扰在融合前去掉,RecA再把语义和纹理的一致性拉回来。
论文中也明确指出W_A=W、W_B=1-W的互补关系是近似的;材料库、任务相关的物理先验和跨域泛化能力仍然可以作为后续需要进一步验证的边界。因此,该项工作更像是一条给“通用图像融合”提供的新建模方向:由原来的堆叠聚合模块转为显式建模成像中的不变量和变化量。