


来源:3DCV
文章链接:https://mp\.weixin\.qq\.com/s/UwlJ2Swmp1ChBkM5jUwUJw
0. 论文信息
标题:Anchor3R: Streaming 3D Reconstruction with Transient Anchors for Long-Horizon Visual Mapping
作者:Peilin Tao, Chong Cheng, Yuansen Du, Caiwei Song, Zhengqing Chen, Xiaoyang Guo, Wei Yin, Weiqiang Ren, Qian Zhang, Hainan Cui, Shuhan Shen
机构:中国科学院自动化研究所、中国科学院大学人工智能学院、地平线机器人、香港科技大学(广州)
论文:https://arxiv\.org/abs/2606\.05035
官方主页:https://polar\-explorer\.github\.io/Anchor3R\-project\-page/
GitHub 代码:https://github\.com/polar\-explorer/Anchor3R
1. 导读
用 48 帧的短序列训练,处理超过 1 万帧的长视频。Anchor3R 的核心思路是:让模型专注于当前窗口内的局部重建,再通过几何约束与全局优化,将局部结果连接成完整地图。
给模型几十张图像,它已经能够估计相机运动、重建三维场景。但如果输入是一段覆盖数公里、包含上万帧图像的视频,模型还能做好这件事吗?
Anchor3R 将局部重建与全局建图这两项任务分开:模型负责局部重建,系统通过几何约束将局部结果整合为全局地图。
每一帧到来时,模型都以当前帧为参考,估计局部窗口内的相对位姿与当前帧的三维结构。位姿描述相机的位置和朝向。系统不断积累这些局部测量,并将其组织成位姿图,记录各帧之间的相对关系,再用于恢复和优化全局轨迹。序列可以不断延长,网络每一步仍然只需处理当前窗口内的局部重建任务。
基于这一设计,Anchor3R 使用每段 48 帧的短序列进行训练,即可直接处理超过 1 万帧的视频序列。在固定窗口的在线推理中,网络状态所需的 GPU 显存不会随视频长度持续增长。
这项工作由地平线机器人、中国科学院自动化研究所、中国科学院大学、香港科技大学(广州)的研究者共同完成,已被 CoRL 2026 高分接收。论文、代码、模型权重与可视化 Demo 已公开。
2. 效果展示
视频展示了 Anchor3R 在庭院、公路、城区与建筑群等不同场景中的长序列重建效果,覆盖步行采集、车辆行驶和大范围室外环境等多种视角变化。
这些结果不仅呈现了单帧的深度或局部几何,还展示了相机轨迹持续延伸时,系统如何将不同窗口产生的局部三维结构逐步对齐到统一坐标系中。随着输入视频不断向前推进,模型始终处理固定大小的活动窗口,而累积的相对位姿测量则用于扩展并优化全局地图。
在 VBR 的两个真实校园场景中,Anchor3R 分别处理了 12,042 帧和 11,671 帧图像,对应的相机轨迹长度约为 2.73 km 和 2.95 km。
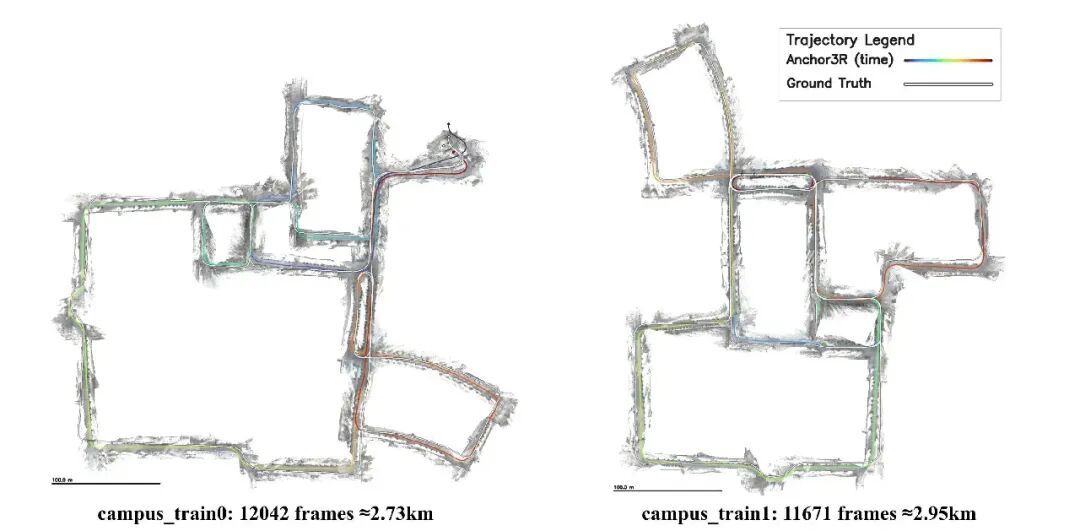
这表明,即使面对校园尺度、跨越数公里的长序列,使用短序列训练的模型仍可以持续输出局部几何测量,并将其组合为大范围三维重建。
值得注意的是,这种长序列能力并不要求网络在内部保存不断增长的完整场景状态。在线推理期间,活动窗口大小保持固定,因此网络状态所需的 GPU 显存不会随着视频长度持续增长;序列尺度的扩展主要由窗口间的几何约束和后续全局优化承担。
3. 引言
随着 VGGT 等三维基础模型的发展,神经网络展现出了强大的局部几何推理能力。但在长时间运行中,许多逐帧处理图像的流式方法还需要通过内部状态持续维护一个参考坐标系:一边理解眼前的场景,一边维护从早期帧延续下来的坐标参考。
随着序列延长,模型需要处理的历史状态逐渐超出短序列训练时见过的范围,形成训练与推理之间的分布差异。加长训练序列、引入测试时训练(Test-Time Training,TTT)等方法,可以在一定程度上缓解这种差异。但只要模型仍需持续维护历史坐标状态,局部几何推理与长期状态传播就仍然耦合,长序列中的分布偏移与误差累积也难以仅靠这些手段彻底消除。
长序列重建,为什么会给模型带来额外负担?
在短序列中,把相机和场景统一到同一个参考坐标系,是一种自然的做法。
随着序列延长,相机可能已远离起点,看到的场景也与最初大不相同。对于依赖固定参考坐标系,或需要逐帧传递坐标状态的方法,网络仍然需要将新观测对齐到此前的参考系中。这样一来,局部几何推理与长时间维护坐标参考的任务就耦合在一起:历史误差可能继续向后传播,推理时不断积累的状态也可能偏离短序列训练时的分布。
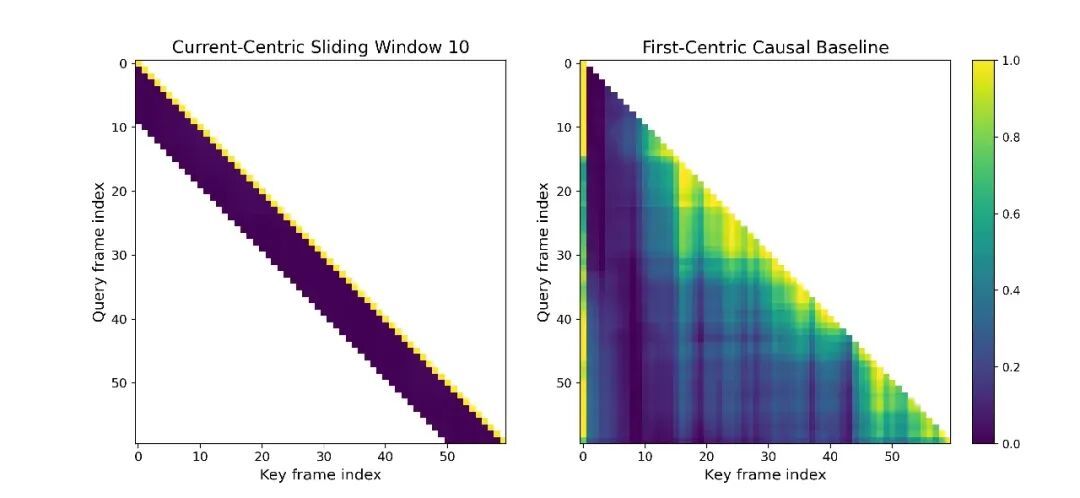
论文中的注意力分析呈现了这种现象:以首帧为固定参考的基线,在后续预测中仍持续关注早期锚点;Anchor3R 的注意力则随当前窗口向前移动,集中于活动窗口内的图像特征。
这一观察促使我们重新划分模型的职责:让网络专注于当前可见的局部几何,再利用几何测量和全局优化,将不同时刻的局部结果对齐到统一坐标系中。
4. 主要贡献
Anchor3R 的主要贡献可以概括为三点:
5. 方法
Anchor3R 采用从局部到全局的设计:网络围绕当前帧重复完成固定窗口内的局部测量预测,系统再将连续窗口产生的相对位姿与局部三维结构组织为全局地图。
每一帧,都成为新的局部起点
Anchor3R 采用 Current-Centric(以当前帧为中心) 的预测方式。
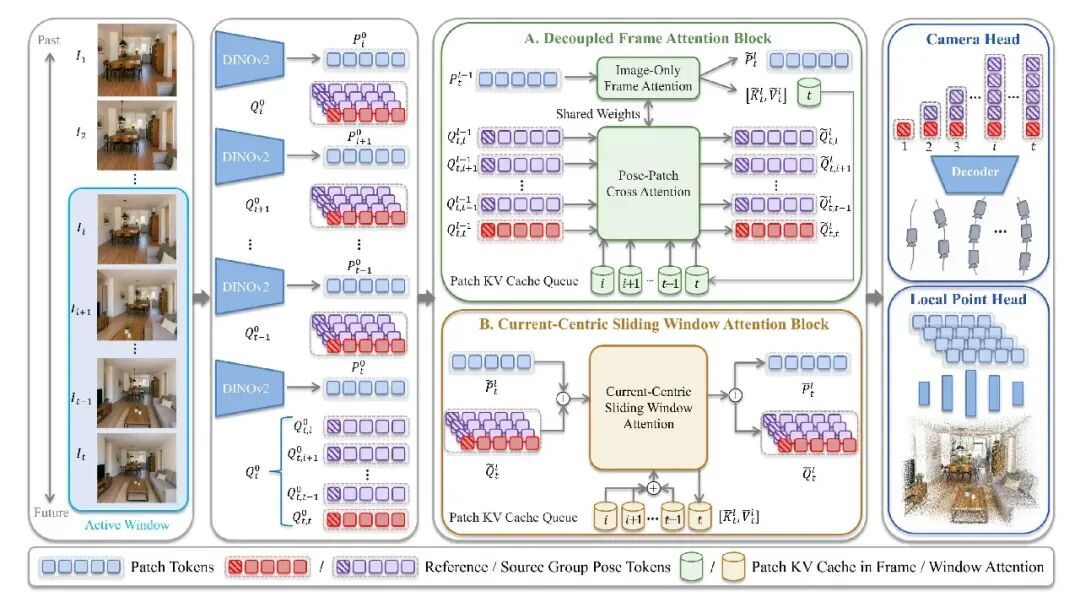
每当新图像到来,当前帧就成为一次局部重建的瞬时锚点(Transient Anchor)。围绕这个锚点,网络完成两项预测:
下一帧到来,参考系随之更新,网络再次完成相同形式的局部预测。
可以把它理解为:相机一路前进,模型始终专注于“眼前这一小段看到了什么、各个视角之间如何关联”。无论已经处理了几十帧还是上万帧,模型每一步都只需估计当前窗口内各帧之间的相对位姿,以及当前帧的三维结构。
窗口不断向前,模型始终专注于局部重建;测量不断积累,地图的范围持续扩展。
复用图像特征,让位姿推理随锚点更新
参考系不断切换后,历史信息应该如何复用?
Anchor3R 通过 Pose-Query Transformer 将图像特征提取与位姿推理解耦。图像特征包含外观、几何与跨帧匹配信息,以键值缓存(KV Cache)的形式在活动窗口内复用,供后续窗口继续使用。与当前参考系绑定的位姿查询,则在每一步重新初始化,不跨窗口缓存。
这种仅缓存图像特征、不保留旧位姿查询的设计,让网络既能利用历史观测,又能在每一步围绕当前参考系进行位姿推理,减少旧位姿状态对后续窗口的干扰。由于活动窗口大小固定,在线推理的网络状态所需显存不会随视频长度持续增长。
局部测量如何连接成全局地图?
相邻窗口之间存在重叠。同一帧会与多个时刻的锚点建立稠密相对位姿约束,这些测量随着视频推进逐步形成一张相对位姿图。
因此,网络每一步输出的局部结果,都能作为几何约束供后续建图使用。
在线阶段,系统结合当前窗口产生的多条相对位姿测量与此前估计的位姿,估计当前帧在全局坐标系中的位置和朝向。
离线优化阶段,系统还可以检索曾经到访的区域,将这些区域的回环关键帧重新引入局部预测,为时间间隔较长的帧补充相对位姿约束,再通过运动平均(motion averaging)联合优化整条轨迹,减小累积误差的影响。
最终,系统利用恢复出的全局位姿,将各帧的局部三维点图对齐到统一坐标系中,得到完整的三维重建结果。
这形成了 Anchor3R 的完整分工:网络持续产生局部几何测量,位姿图组织这些测量,全局优化利用它们改善长期一致性。
用 48 帧的短序列训练,为什么能处理上万帧视频?
Anchor3R 使用每段 48 帧的短序列进行训练,局部预测的活动窗口为 10 帧。推理时,即使完整视频包含上万帧,模型每一步处理的仍然是固定窗口内的局部任务。
这种设计使局部预测的范围不再随完整序列的长度增长,也减少了网络长时间维护坐标状态的负担,让使用短序列训练的模型能够用于长序列推理。
实验中,Anchor3R 可以直接处理超过 1 万帧的视频序列。当前公开实现也支持在首个窗口初始化后,随新图像输入逐帧推理。
6. 实验结果
长序列评测:KITTI 与 VBR
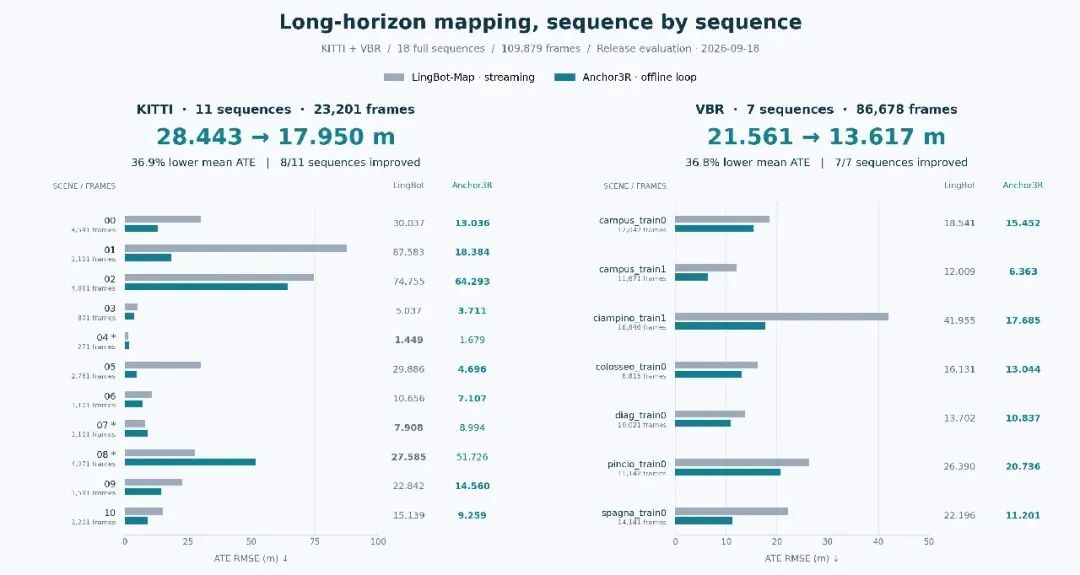
我们在 KITTI Odometry 的 11 条完整轨迹和 VBR 的 7 个场景上,将 Anchor3R 的离线回环优化结果与 LingBot-Map 的流式在线结果进行比较。每个场景独立完成整段序列的重建与轨迹评估,其中最长的单场景序列包含 18,846 帧。
评测指标为全序列 Sim(3) 对齐后的绝对轨迹误差(ATE RMSE,越低越好)。对各场景的 ATE 取算术平均,得到数据集上的平均误差。
在 KITTI 上,序列 01 的 ATE 从 87.583 m 降至 18.384 m,序列 05 从 29.886 m 降至 4.696 m;04、07、08 三条序列的误差仍高于对比方案。
在 VBR 上,Anchor3R 在全部 7 个场景中取得更低误差。其中,ciampino_train1 从 41.955 m 降至 17.685 m,spagna_train0 从 22.196 m 降至 11.201 m。
7. 总结 & 限制性
总结
将三维基础模型用于长时间、连续的视觉建图,需要明确局部几何预测与全局一致性维护各自承担的任务。
Anchor3R 给出的路径是:让模型在每一步专注于局部重建,不断积累预测得到的几何测量,再利用这些测量联合优化轨迹,重建更大的场景。
把模型从长序列全局状态估计的负担中解放出来,让它专注于局部重建——这是 Anchor3R 走向长期视觉建图的出发点。
限制性
论文同时指出了当前方法的几项限制:
项目主页提供 KITTI、VBR、Oxford、TUM 等场景的 RGB、深度、轨迹与三维重建可视化,欢迎体验和交流。
原文链接: https://www.leiphone.com/category/private/SaAzmBa9SHByVzIZ.html
