


来源
来源:chal1ce 文章链接:https://mp.weixin.qq.com/s/B6UWrSfxCRTg-MP92EVBzg
今日碎碎念
图片改坏了,到底该怪谁?dars让规划器和生成器分别背对的锅
复杂图像编辑通常由两个模型接力完成:视觉语言模型先制定计划,扩散模型再执行。但当最终图片失败时,一个总分并不能告诉我们究竟是谁出了错。dars把这个问题重新定义为“双层信用分配”,让训练信号找到真正需要修正的模块和规划步骤。
让一张图片里的白色灯罩变成蓝色,不是什么难事
但如果要求模型画出“30秒后的冰块”“标出毛毛虫到叶子的两条最短路径”,或者只移动两根火柴让等式成立,图像编辑就不再只是局部换色,而是先理解问题、形成计划,再把计划准确画出来
因此,越来越多图像编辑系统采用两阶段结构:前面的vlm负责理解指令并写出编辑计划,后面的扩散模型负责把计划变成图像
这套分工提升了可控性,却带来了一个很像团队管理的问题:项目失败了,到底该怪制定方案的人,还是负责执行的人?
论文《dars: Dual-Level Credit Assignment RL with Structured Reasoning for Instruction-Based Image Editing》研究的正是这件事
链接:https://arxiv.org/pdf/2608.20161
同样是失败,责任可能完全相反
论文首页给出了一个很直观的例子
任务是把红色和黄色液体充分混合,最后只留一碗橙色液体
左侧案例中,规划器已经正确写出了“混合后装在一个碗里”,但扩散模型没有执行好,结果仍然红黄分离,这时应该重点更新renderer
右侧案例中,规划器错误地要求橙色液体装满两个碗,renderer反而忠实执行了错误计划,这时应该重点更新planner
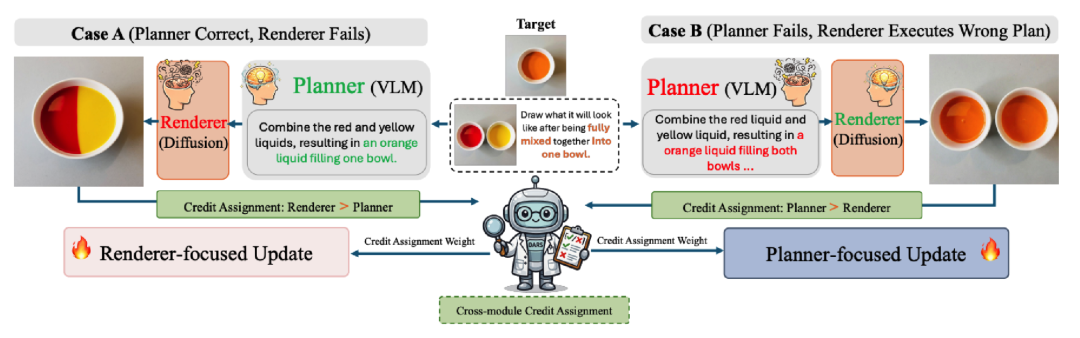
规划器正确但渲染器失败,与规划器失败但渲染器正确执行的对比。 图1:外观上都属于失败编辑,但左侧需要加强renderer更新,右侧需要加强planner更新,来源:论文figure 1。
如果训练系统只看最终图片分数,就会把这两种性质完全不同的错误压缩成同一个数字
现有方法通常选择只训练其中一个模块、交替训练两个模块,或者把同一个奖励平均发给两边,这些做法都没有真正回答“当前样本的主要瓶颈在哪里”
dars的出发点是:先找对责任,再决定梯度往哪里走。
第一层归因:该更新planner还是renderer
dars对每条编辑指令不只生成一份计划和一张图片,而是采样4份候选计划,每份计划再独立生成4张图片,一共得到16条rollout
这些重复尝试不是单纯用来挑最好结果,而是用来观察两种波动
第一种是计划之间的波动:换一份计划,结果就明显变化,说明planner的选择对成败影响较大
第二种是同一计划内部的波动:计划没变,renderer多生成几次,结果却忽好忽坏,说明执行端更不稳定
可以把它理解成一次小型的方差分解:跨计划差异更大,训练信号就更多路由给planner;同一计划下的生成差异更大,训练信号就更多路由给renderer
论文没有做生硬的二选一,而是采用连续的软路由权重,因为现实中的失败经常是混合型:规划不够好,执行也不够稳,只是双方责任并不对称
第二层归因:planner内部到底哪一段错了
即使知道主要问题在planner,仍然没有回答下一层问题:计划里的哪部分需要修改
自由形式的推理文本是一整段不透明序列,最终图片的奖励很难精确落到其中某句话上
dars因此把计划固定成4个语义槽位:
• modify:到底要改什么 • preserve:哪些内容必须保持不变 • overall:编辑后的整体场景应该是什么样 • tips:给renderer的具体执行提示
这四部分并不是平行关系,而带有因果顺序
如果modify都错了,那么preserve写得再周全、tips写得再漂亮,也不该获得完整奖励;只有前面的基础要求通过检查,后续字段的奖励才会被激活
论文把这种机制称为prefix-gated reward,它能减少一种常见投机:用大量听起来专业的执行细节,掩盖最核心的编辑目标其实理解错了
dars的完整训练闭环
整个系统把上述两层归因与自适应课程学习结合起来
planner基于原图和指令生成4字段计划,renderer为多份候选计划分别生成多张图片,奖励模型再从执行结果中评估计划质量与渲染质量
平均奖励被用来估计样本难度,让训练从相对简单的编辑逐步转向推理更密集的任务;跨计划和计划内的波动决定额外梯度应该更多分给哪个模块;槽位奖励则继续定位planner内部的问题
planner使用grpo更新,renderer使用flow-grpo更新,两者仍然联合训练,只是每个样本获得的更新权重不同
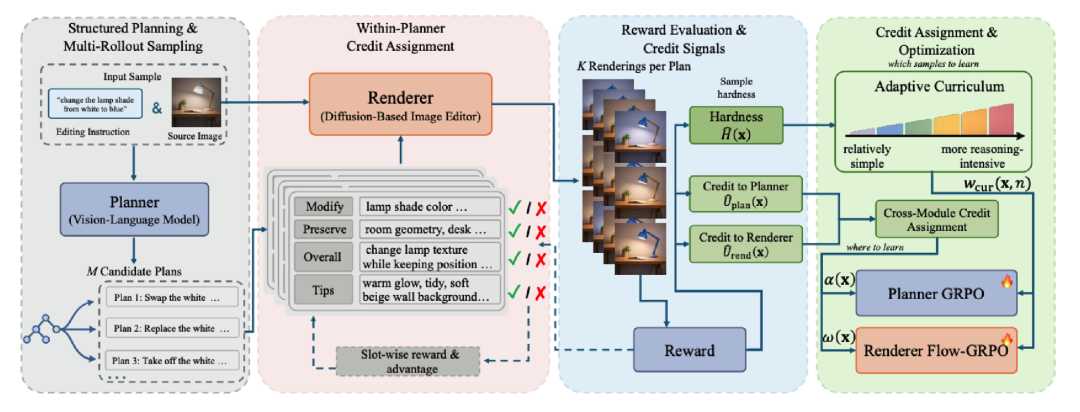
dars从结构化规划、多次采样、奖励评估到信用分配和优化的完整流程。 图2:dars同时回答三个问题:当前学哪个样本、重点更新哪个模块、planner内部更新哪个槽位,来源:论文figure 3。
为了构建评估信号,作者在训练前使用gemini 3 pro从原图和指令生成与4个槽位对齐的检查清单,训练期间则由qwen3-vl-32b对planner和renderer的表现进行在线是非判断
这意味着dars并不是凭空识别错误,它的归因能力仍建立在外部奖励模型和检查清单质量之上
为什么还要做自适应课程学习
简单样本和困难样本不仅难度不同,适合学习的时机也不同
训练早期,如果模型连基础局部编辑都做不好,过早塞入大量物理推理、时序变化和空间规划任务,奖励往往只剩噪声
dars利用多次rollout的平均奖励估计当前难度边界,早期更关注相对简单的样本,随着能力提升再逐步提高困难任务的权重
消融实验中,取消课程学习后,rise-bench从27.50降至18.89;使用固定课程得到24.56,仍低于动态课程的27.50
更有意思的是,没有课程学习的自由形式joint rl会直接发散,而4字段结构化planner即便不使用课程仍能收敛,说明结构化计划本身也在提供训练稳定性
实验结果:提升集中在真正需要推理的编辑上
作者使用1万条训练样本,planner初始化自qwen3-vl-4b-instruct,renderer初始化自qwen-image-edit-2511,并在5个编辑基准上评估
dars在论文报告的5组基准结果中均取得最高总分
与严格控制的joint rl+adaptive curriculum基线相比,双方使用相同backbone、数据、奖励模型、rollout预算和硬件,dars的提升分别为:
• kris-bench:72.15提升至80.72,增加8.57 • rise-bench:25.70提升至27.50,增加1.80 • imgedit-bench:4.20提升至4.39,增加0.19 • gedit-bench-en:7.83提升至7.86,增加0.03 • pica-bench:简单指令增加0.64,详细指令增加0.53
最明显的收益出现在kris-bench和rise-bench,它们更强调知识、因果、空间与复杂推理,这与dars专门解决planner-renderer归因的设计相符
在更偏一般编辑和局部保真的gedit-bench-en上,提升只有0.03,这也提醒我们:dars不是为每种编辑任务提供同等幅度的增益,它最有价值的场景是计划质量真正会成为瓶颈的复杂任务
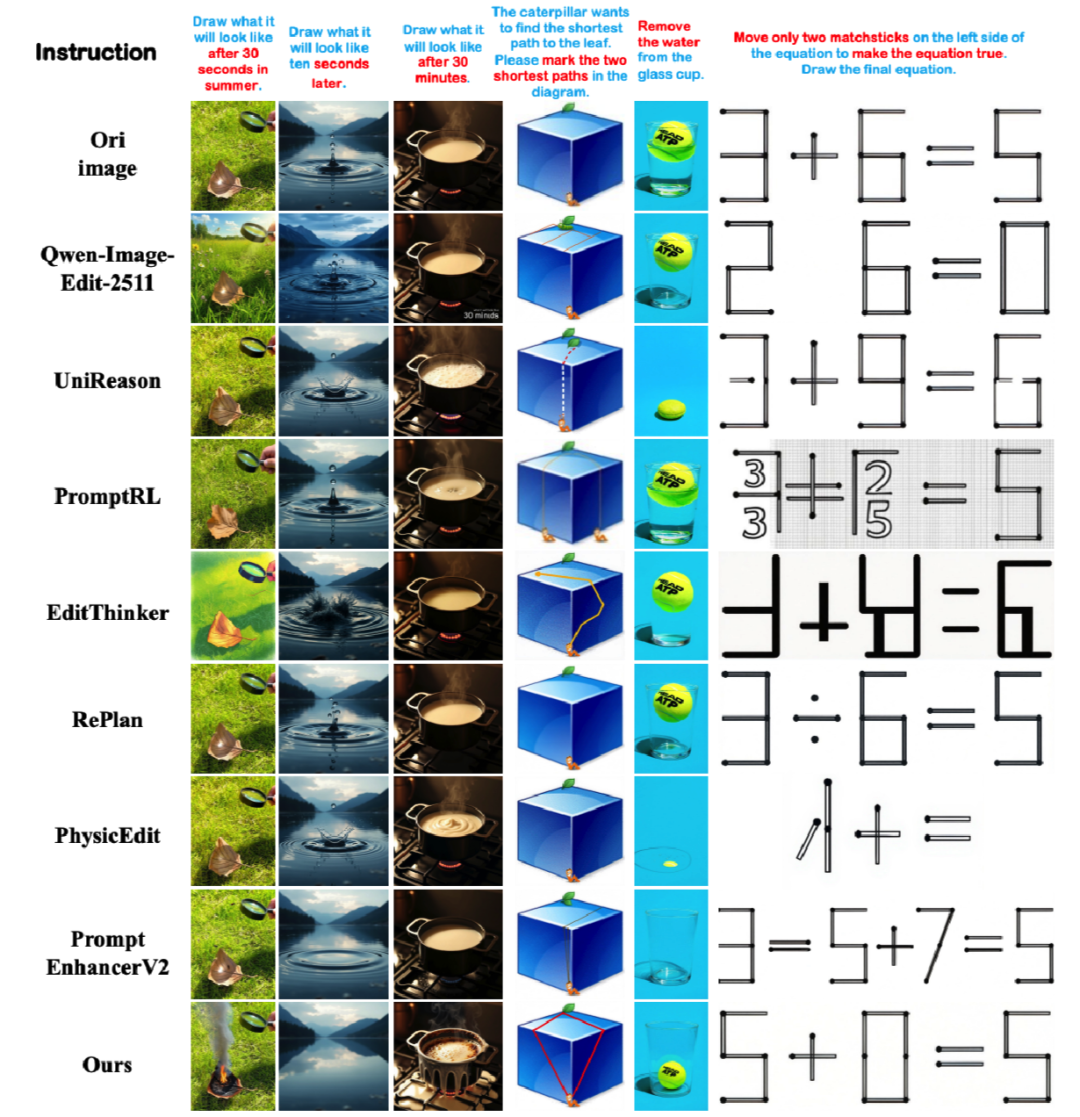
dars与多种图像编辑方法在时序、空间、物理和逻辑推理任务上的对比。 图3:示例覆盖时序变化、最短路径、物体移除和火柴等式等推理型编辑,最下方为dars,来源:论文figure 4。
定性案例中,dars需要处理的不只是“改得像不像”,还包括夏天30秒后冰块如何变化、液面10秒后的状态、煮30分钟后的锅、最短路径以及移动火柴后的正确等式
这些任务把图像编辑推向了一个更有意思的方向:图像不只是生成目标,也是推理答案的载体
消融实验说明了什么
dars的几个组件并不是简单堆叠
取消跨模块路由后,rise-bench只有20.05;使用硬路由提升到24.86;完整的软路由达到27.50,说明“按样本连续分配责任”比平均更新或非黑即白地选择模块更有效
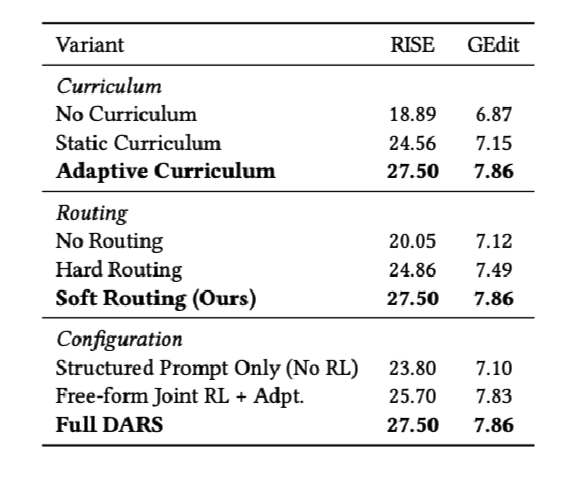
在planner结构上,自由推理得到23.94,只保留modify得到25.21,逐步补上preserve、overall和tips后,完整结构达到27.50
其中去掉overall带来的rise-bench下降比去掉tips更大,说明复杂编辑里,场景级目标比局部执行提示更关键
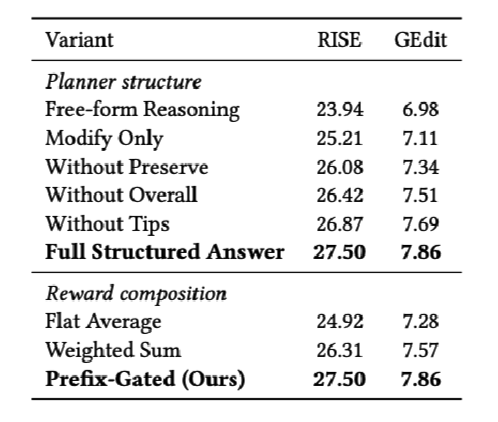
prefix-gated reward也优于平坦平均和普通加权求和,进一步支持了“先保证核心修改正确,再奖励后续细节”的因果顺序
论文还把路由信号与gpt-5生成的失败归因伪标签比较,三组二分类auroc均超过0.91,说明rollout统计与外部判断有较强一致性
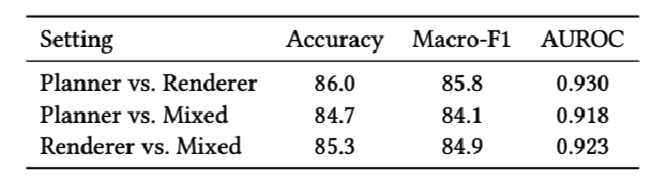
不过伪标签不等于人工标注真值,这项验证更适合视为旁证,而不是对错误归因准确率的最终证明
这篇论文真正值得借鉴的地方
dars表面上是一篇图像编辑论文,背后讨论的却是组合式agent系统都会遇到的问题
当一个任务由规划器、工具调用器、检索器、生成器等多个组件共同完成时,最终结果差并不能直接说明每个组件都该被同样更新
如果没有信用分配,端到端奖励很容易让正确模块替错误模块背锅,也可能让错误模块躲在一个偶然成功的最终结果后面
dars给出的三个问题很有普适性:
1. where to learn:错误主要来自哪个模块 2. what to learn:模块内部哪部分决策需要修正 3. which samples to learn:当前阶段什么难度的样本最有信息量
这套思路未来不仅可能用于视频编辑,也适合多工具agent、机器人规划和其他带中间决策的生成系统
还需要保留的边界
dars的代价并不小,每条训练样本需要4个计划乘4次渲染,也就是16条rollout,计算量明显高于单路径更新
它对奖励模型有较强依赖,如果检查清单遗漏关键要求,或者在线judge误判,路由信号也会跟着偏移
当planner和renderer同时严重失败时,两种波动未必能被干净分离;目前实验也没有覆盖视频编辑和多轮交互场景
另外,定性大图中的案例由作者选取,最可靠的证据仍然是受控基线与消融实验,而不是几张视觉效果最漂亮的样例
写在最后
过去的图像编辑强化学习更关心“最终图片得了多少分”,dars继续追问了一步:这个分数到底应该反馈给谁
当系统只有一个模型时,奖励低就更新模型;当系统变成多个模块接力,训练的难点不再只是奖励是否准确,也包括奖励能不能找到真正负责的环节
从这个角度看,dars最重要的贡献并不是又加了一套复杂流程,而是让多模态训练开始认真面对一个朴素问题:哪里做错了,就应该让哪里学。
论文信息
• 标题:DARS: Dual-Level Credit Assignment RL with Structured Reasoning for Instruction-Based Image Editing • 作者:Haoxiang Cao、Jiajiong Cao、Xuanpu Zhang、Changqian Yu、Chaoqun Wang • 机构:South China Normal University、KlingAI Research • arxiv:2608.20161

今日碎碎念
图片改坏了,到底该怪谁?dars让规划器和生成器分别背对的锅
复杂图像编辑通常由两个模型接力完成:视觉语言模型先制定计划,扩散模型再执行。但当最终图片失败时,一个总分并不能告诉我们究竟是谁出了错。dars把这个问题重新定义为“双层信用分配”,让训练信号找到真正需要修正的模块和规划步骤。
让一张图片里的白色灯罩变成蓝色,不是什么难事
但如果要求模型画出“30秒后的冰块”“标出毛毛虫到叶子的两条最短路径”,或者只移动两根火柴让等式成立,图像编辑就不再只是局部换色,而是先理解问题、形成计划,再把计划准确画出来
因此,越来越多图像编辑系统采用两阶段结构:前面的vlm负责理解指令并写出编辑计划,后面的扩散模型负责把计划变成图像
这套分工提升了可控性,却带来了一个很像团队管理的问题:项目失败了,到底该怪制定方案的人,还是负责执行的人?
论文《dars: Dual-Level Credit Assignment RL with Structured Reasoning for Instruction-Based Image Editing》研究的正是这件事
链接:https://arxiv.org/pdf/2608.20161
同样是失败,责任可能完全相反
论文首页给出了一个很直观的例子
任务是把红色和黄色液体充分混合,最后只留一碗橙色液体
左侧案例中,规划器已经正确写出了“混合后装在一个碗里”,但扩散模型没有执行好,结果仍然红黄分离,这时应该重点更新renderer
右侧案例中,规划器错误地要求橙色液体装满两个碗,renderer反而忠实执行了错误计划,这时应该重点更新planner
图1:外观上都属于失败编辑,但左侧需要加强renderer更新,右侧需要加强planner更新,来源:论文figure 1。
如果训练系统只看最终图片分数,就会把这两种性质完全不同的错误压缩成同一个数字
现有方法通常选择只训练其中一个模块、交替训练两个模块,或者把同一个奖励平均发给两边,这些做法都没有真正回答“当前样本的主要瓶颈在哪里”
dars的出发点是:先找对责任,再决定梯度往哪里走。
第一层归因:该更新planner还是renderer
dars对每条编辑指令不只生成一份计划和一张图片,而是采样4份候选计划,每份计划再独立生成4张图片,一共得到16条rollout
这些重复尝试不是单纯用来挑最好结果,而是用来观察两种波动
第一种是计划之间的波动:换一份计划,结果就明显变化,说明planner的选择对成败影响较大
第二种是同一计划内部的波动:计划没变,renderer多生成几次,结果却忽好忽坏,说明执行端更不稳定
可以把它理解成一次小型的方差分解:跨计划差异更大,训练信号就更多路由给planner;同一计划下的生成差异更大,训练信号就更多路由给renderer
论文没有做生硬的二选一,而是采用连续的软路由权重,因为现实中的失败经常是混合型:规划不够好,执行也不够稳,只是双方责任并不对称
第二层归因:planner内部到底哪一段错了
即使知道主要问题在planner,仍然没有回答下一层问题:计划里的哪部分需要修改
自由形式的推理文本是一整段不透明序列,最终图片的奖励很难精确落到其中某句话上
dars因此把计划固定成4个语义槽位:
• modify:到底要改什么 • preserve:哪些内容必须保持不变 • overall:编辑后的整体场景应该是什么样 • tips:给renderer的具体执行提示
这四部分并不是平行关系,而带有因果顺序
如果modify都错了,那么preserve写得再周全、tips写得再漂亮,也不该获得完整奖励;只有前面的基础要求通过检查,后续字段的奖励才会被激活
论文把这种机制称为prefix-gated reward,它能减少一种常见投机:用大量听起来专业的执行细节,掩盖最核心的编辑目标其实理解错了
dars的完整训练闭环
整个系统把上述两层归因与自适应课程学习结合起来
planner基于原图和指令生成4字段计划,renderer为多份候选计划分别生成多张图片,奖励模型再从执行结果中评估计划质量与渲染质量
平均奖励被用来估计样本难度,让训练从相对简单的编辑逐步转向推理更密集的任务;跨计划和计划内的波动决定额外梯度应该更多分给哪个模块;槽位奖励则继续定位planner内部的问题
planner使用grpo更新,renderer使用flow-grpo更新,两者仍然联合训练,只是每个样本获得的更新权重不同
图2:dars同时回答三个问题:当前学哪个样本、重点更新哪个模块、planner内部更新哪个槽位,来源:论文figure 3。
为了构建评估信号,作者在训练前使用gemini 3 pro从原图和指令生成与4个槽位对齐的检查清单,训练期间则由qwen3-vl-32b对planner和renderer的表现进行在线是非判断
这意味着dars并不是凭空识别错误,它的归因能力仍建立在外部奖励模型和检查清单质量之上
为什么还要做自适应课程学习
简单样本和困难样本不仅难度不同,适合学习的时机也不同
训练早期,如果模型连基础局部编辑都做不好,过早塞入大量物理推理、时序变化和空间规划任务,奖励往往只剩噪声
dars利用多次rollout的平均奖励估计当前难度边界,早期更关注相对简单的样本,随着能力提升再逐步提高困难任务的权重
消融实验中,取消课程学习后,rise-bench从27.50降至18.89;使用固定课程得到24.56,仍低于动态课程的27.50
更有意思的是,没有课程学习的自由形式joint rl会直接发散,而4字段结构化planner即便不使用课程仍能收敛,说明结构化计划本身也在提供训练稳定性
实验结果:提升集中在真正需要推理的编辑上
作者使用1万条训练样本,planner初始化自qwen3-vl-4b-instruct,renderer初始化自qwen-image-edit-2511,并在5个编辑基准上评估
dars在论文报告的5组基准结果中均取得最高总分
与严格控制的joint rl+adaptive curriculum基线相比,双方使用相同backbone、数据、奖励模型、rollout预算和硬件,dars的提升分别为:
• kris-bench:72.15提升至80.72,增加8.57 • rise-bench:25.70提升至27.50,增加1.80 • imgedit-bench:4.20提升至4.39,增加0.19 • gedit-bench-en:7.83提升至7.86,增加0.03 • pica-bench:简单指令增加0.64,详细指令增加0.53
最明显的收益出现在kris-bench和rise-bench,它们更强调知识、因果、空间与复杂推理,这与dars专门解决planner-renderer归因的设计相符
在更偏一般编辑和局部保真的gedit-bench-en上,提升只有0.03,这也提醒我们:dars不是为每种编辑任务提供同等幅度的增益,它最有价值的场景是计划质量真正会成为瓶颈的复杂任务
图3:示例覆盖时序变化、最短路径、物体移除和火柴等式等推理型编辑,最下方为dars,来源:论文figure 4。
定性案例中,dars需要处理的不只是“改得像不像”,还包括夏天30秒后冰块如何变化、液面10秒后的状态、煮30分钟后的锅、最短路径以及移动火柴后的正确等式
这些任务把图像编辑推向了一个更有意思的方向:图像不只是生成目标,也是推理答案的载体
消融实验说明了什么
dars的几个组件并不是简单堆叠
取消跨模块路由后,rise-bench只有20.05;使用硬路由提升到24.86;完整的软路由达到27.50,说明“按样本连续分配责任”比平均更新或非黑即白地选择模块更有效
在planner结构上,自由推理得到23.94,只保留modify得到25.21,逐步补上preserve、overall和tips后,完整结构达到27.50
其中去掉overall带来的rise-bench下降比去掉tips更大,说明复杂编辑里,场景级目标比局部执行提示更关键
prefix-gated reward也优于平坦平均和普通加权求和,进一步支持了“先保证核心修改正确,再奖励后续细节”的因果顺序
论文还把路由信号与gpt-5生成的失败归因伪标签比较,三组二分类auroc均超过0.91,说明rollout统计与外部判断有较强一致性
不过伪标签不等于人工标注真值,这项验证更适合视为旁证,而不是对错误归因准确率的最终证明
这篇论文真正值得借鉴的地方
dars表面上是一篇图像编辑论文,背后讨论的却是组合式agent系统都会遇到的问题
当一个任务由规划器、工具调用器、检索器、生成器等多个组件共同完成时,最终结果差并不能直接说明每个组件都该被同样更新
如果没有信用分配,端到端奖励很容易让正确模块替错误模块背锅,也可能让错误模块躲在一个偶然成功的最终结果后面
dars给出的三个问题很有普适性:
1. where to learn:错误主要来自哪个模块 2. what to learn:模块内部哪部分决策需要修正 3. which samples to learn:当前阶段什么难度的样本最有信息量
这套思路未来不仅可能用于视频编辑,也适合多工具agent、机器人规划和其他带中间决策的生成系统
还需要保留的边界
dars的代价并不小,每条训练样本需要4个计划乘4次渲染,也就是16条rollout,计算量明显高于单路径更新
它对奖励模型有较强依赖,如果检查清单遗漏关键要求,或者在线judge误判,路由信号也会跟着偏移
当planner和renderer同时严重失败时,两种波动未必能被干净分离;目前实验也没有覆盖视频编辑和多轮交互场景
另外,定性大图中的案例由作者选取,最可靠的证据仍然是受控基线与消融实验,而不是几张视觉效果最漂亮的样例
写在最后
过去的图像编辑强化学习更关心“最终图片得了多少分”,dars继续追问了一步:这个分数到底应该反馈给谁
当系统只有一个模型时,奖励低就更新模型;当系统变成多个模块接力,训练的难点不再只是奖励是否准确,也包括奖励能不能找到真正负责的环节
从这个角度看,dars最重要的贡献并不是又加了一套复杂流程,而是让多模态训练开始认真面对一个朴素问题:哪里做错了,就应该让哪里学。
论文信息
• 标题:DARS: Dual-Level Credit Assignment RL with Structured Reasoning for Instruction-Based Image Editing • 作者:Haoxiang Cao、Jiajiong Cao、Xuanpu Zhang、Changqian Yu、Chaoqun Wang • 机构:South China Normal University、KlingAI Research • arxiv:2608.20161
