


*来源:具身智能漫谈
*
文章链接:https://mp\.weixin\.qq\.com/s/Jc3Uiq94AwIQ3Om0tED2dA
【具身智能漫谈】
聚焦具身智能与机器人前沿研究,每日精选 arXiv 最新论文深入解读,涵盖视觉-语言-动作(VLA)模型、世界模型、机器人学习等热门方向,助力科研工作者把握领域脉搏。
1 — 行业痛点:动作库越大,算力账单越离谱
人形机器人要在人的环境里干活,第一关就是「全身控制」——走路、跳舞、蹲下、被推一把还能站住,这些都得会。目前最有效的路子是物理仿真里的动作模仿:让强化学习策略去追一段段参考动作。
问题是,动作库越大,策略越强,算力也越贵。现有系统大致分两派。
论文把根因说得很直白:参考动作各不相同,但它们共享同一具人形机器人的刚体动力学。而无模型强化学习(model-free RL)不会显式建模这个「共享结构」,只能一遍遍从带噪的仿真 rollout 里估计「这个动作会导致什么后果」。于是,想覆盖更多动作,就只能加算力。
在这个视角下,动作库的规模不是被算法卡住的,是被电费卡住的。
2 — 核心突破:把「环境」换成一个可微网络
SuperMimic 的思路是:既然所有动作共享同一具身体,那就把这具身体的动力学学成一个可微的神经网络,让策略梯度从网络里直接求出来,而不是从仿真器里采样估出来。
训练是一个三阶段交替的闭环,全程只有两个学习器(世界模型和策略)在一起进步,梯度从不穿过物理引擎。
收数据
拟合世界模型
改策略
训练闭环里有几个设计值得单独说。
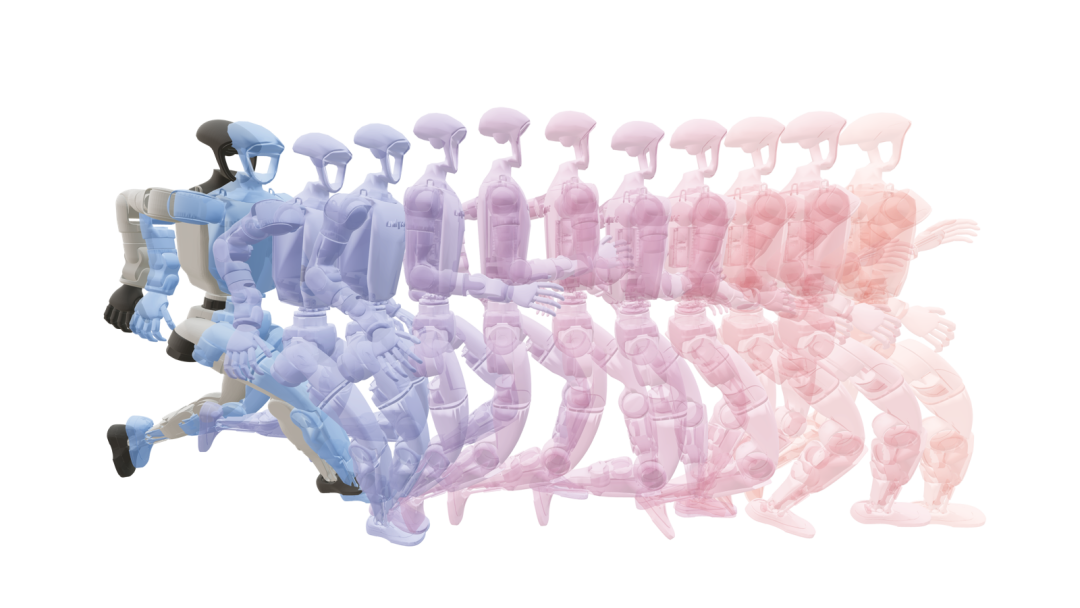
图:策略在世界模型的想象 rollout 中变强,右侧是 128 张卡与 1 张卡的算力对照
梯度方差为什么小。 近端策略优化(PPO)把动力学当黑盒,用「动作的对数概率梯度 × 优势」这种似然比方式估计策略梯度;BPTT 则是直接把回报对每个动作求导。论文的说法是:在短视界上,后者的梯度方差低得多。这也是它敢用 1 张卡硬碰 128 张卡的底气。
世界模型必须保持确定性。 仿真器的随机性来源是已知的(摩擦、标定偏移、躯干质心),所以模型以每回合的仿真上下文 ξ 为条件,只预测无噪观测,传感器噪声在模型外重新加回去。这样模型是确定可微的,梯度才干净。
终止信号要可微。 仿真器给的终止是 0/1 硬标签,一旦终止,回报就被切断,梯度传不回去。SuperMimic 让世界模型额外预测一个终止概率,把「存活权重」变成连续值,想象 rollout 里也能求导。
critic 补上想象视界之外的回报。 32 步之外怎么办?用一个同阶段训练的价值网络(critic)自举。这一步不是装饰——后面消融会看到,没有 critic 连 16 步的视界都训不动。
3 — 实验验证:3 个 GPU 小时对 21000 个 GPU 小时
所有成本都在 Lambda 的 NVIDIA H100(80GB SXM5)上实测,仿真器是 MuJoCo 的 GPU 版本 MuJoCo Warp。
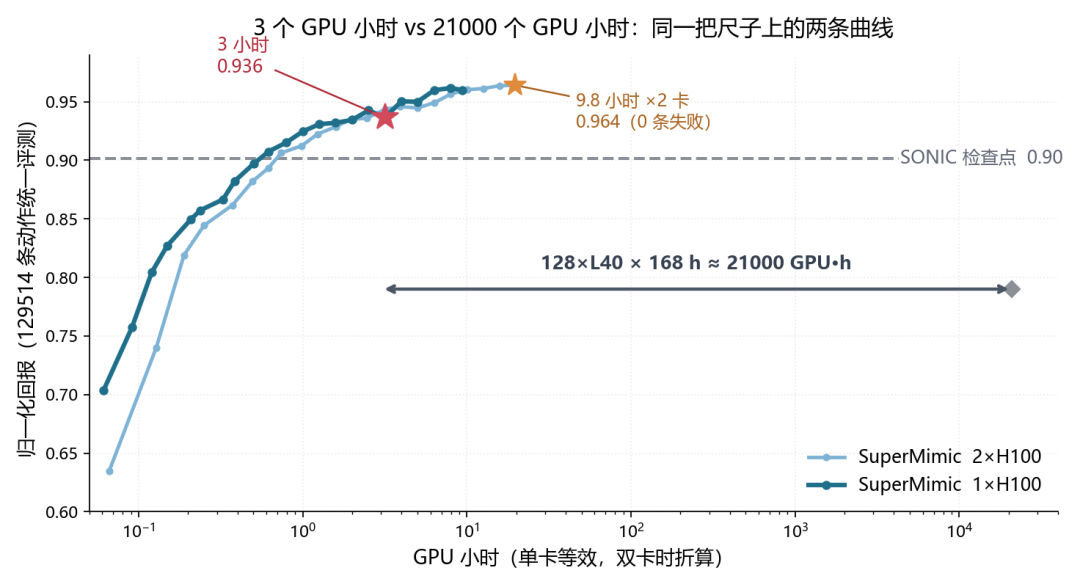
图:横轴为单卡等效 GPU 小时(对数),虚线为 SONIC 检查点 0.90
3.1 主结果:超过 SONIC 的检查点,只花了不到千分之一的算力
在 129514 条动作的统一评测集上,SuperMimic 在 1 张 H100 上跑到 3.164 个 GPU 小时时,归一化回报达到 0.936,已经越过 SONIC 已发布检查点的 0.90。
论文对「3 小时」这个口径很保守:从 3 小时起,每一个检查点在回报和失败动作数两项上都稳定压过 SONIC,且领先幅度不小于 SONIC 与最佳成绩之间差距的一半。换算下来,墙钟时间省 50 倍以上(实际约 56 倍),GPU 小时省 1000 倍以上(实际约 7200 倍)。
失败分布更能说明问题。SONIC 是整组整组地崩:44 个翻转动作全失败、22 个侧滚全失败、某支舞的 8 个动作全失败、24 个大跳里失败 15 个;它的 v1.1 检查点失败 239 条。而 SuperMimic 训练 3 小时后的 25 条失败集中在 5 个小动作组(共 195 条),没有任何一个动作组失败得比 SONIC 多。
3.2 作者自己先做了一遍「算力审计」
跨硬件、跨数据量的比较最容易耍花招,这篇论文主动把不利项摆了出来。
数据更少
硬件纸面并非全面占优
论文的结论是:2.3 倍的数据差、最多 5.5 倍的峰值算力差,解释不了 1000 倍的 GPU 小时差。
另外要说明,这套评测集的动作本身就是两个方法的训练动作,所以失败条数衡量的是「对训练动作覆盖得全不全」,而不是对新动作的泛化。
3.3 受控对比:加卡几乎没用,加模型有用
换成同一套动作、同一套观测、同一套奖励、同一套域随机化和同样大小的网络,只把「学习信号来自仿真器还是世界模型」这一个变量换掉,差距更直观。
在 LAFAN1 的 40 段动作(2.45 小时)上,PPO-Sim 用 8192 个并行环境(是 SuperMimic 的两倍),18 小时预算内始终够不到 0.82 的目标回报:1 张卡最终 0.60,4 张卡 0.70,8 张卡 0.72——从 4 卡到 8 卡几乎没涨。SuperMimic 在 1 张卡上 1.2 小时就到了 0.82。
在这组受控实验里,这就是「暴力加算力」的天花板:并行环境再多,梯度还是从采样里估的。
3.4 省算力的三个来源
论文把节省拆成三条可验证的性质。
一个模型摊销整个动作库。 动作数据从 1 小时涨到 264 小时(约 264 倍),世界模型的 8 步预测误差稳定在 0.007 到 0.011 之间;达到目标回报所需的 GPU 小时也只是从 0.539 涨到 1.892。因为每条动作都是同一具身体在动,新增片段提供的只是关于共享动力学的新证据,并不要求模型扩容。
想象比仿真快一个数量级以上。 在实际用的批量(2k 到 16k 并行环境)区间,世界模型的每秒步数比 MuJoCo Warp 快 10 倍以上:2048 个环境时 8.43e5 对 7.84e4(11 倍),16384 时 6.71e6 对 2.61e5(26 倍)。超出这个区间后差距继续拉大,64k 并行环境时到 62 倍(2.00e7 对 3.22e5)——那时 MuJoCo Warp 的吞吐已经压平了。
解析梯度比似然比更省样本。 这是一次纯粹的机制消融:让 PPO 也在世界模型的 rollout 上训练(PPO-WM),用四种批量配置里最好的那个(16k×32),SuperMimic 用大约 1/64 的想象步数就达到同样的最好回报(9.317e8 步对 5.956e10 步)。所以收益不只是「rollout 更快」,还包括「每一步更有信息量」。
3.5 消融:critic 决定了想象能有多短
想象视界 H 是个关键旋钮,视界越长,单次更新越贵。
没有 critic 时 H≤16 直接训不动;有 critic 后,H=16 的最终回报就能追平无 critic 的 H=32,而达标最快的配置是带 critic 的 H=32(0.88 小时)。视界从 64 抬到 128,达标时间涨了近 3 倍——H=128 已经是单张 H100 装得下的最长视界。
critic 影响的不只是速度,还有行为。在保持静态 T-pose 的同时承受 0.5 到 4 米每秒的推力:有 critic 的策略在 0.5 到 2.4 秒内稳住;无 critic 的策略在 0.5 米每秒就一直在踉跄,4 米每秒直接摔。原因是恢复平衡的奖励常常落在 32 步想象窗口之外,没有 critic 自举就「看不见」它。
3.6 真机:同一套策略,四个动作,不做逐动作调参
一个通用的动作追踪器直接部署到 Unitree G1 上,没有针对每个动作单独调参。四个动作覆盖了三类难度:带跳跃的行走、躯干和四肢都贴地的侧滚,以及 90 度和原地 360 度翻转。
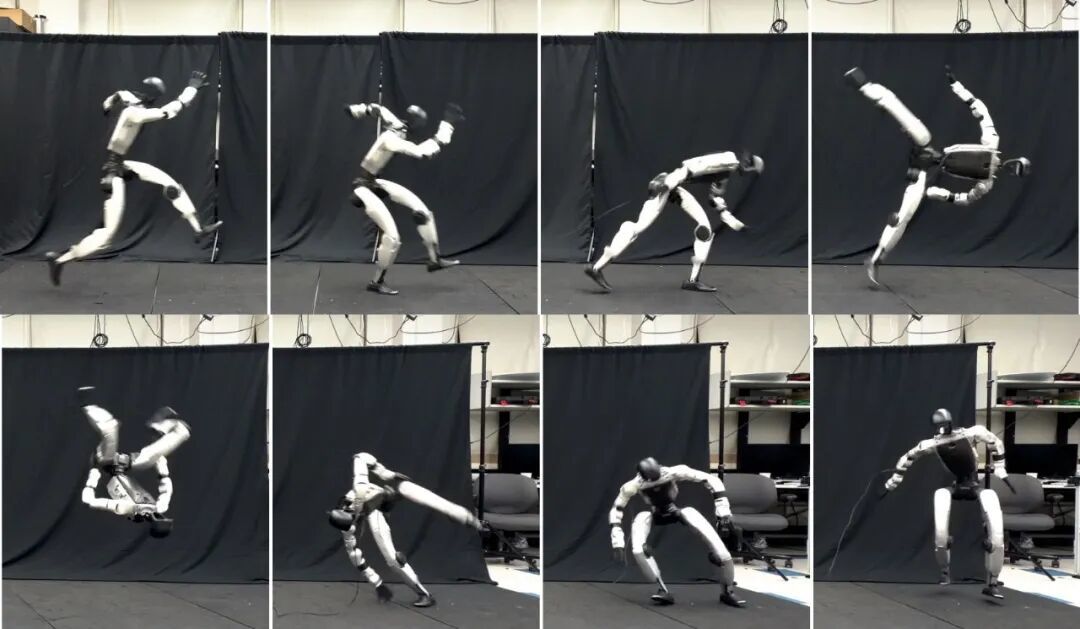
图:带跳跃的行走,相邻帧间隔 0.2 秒
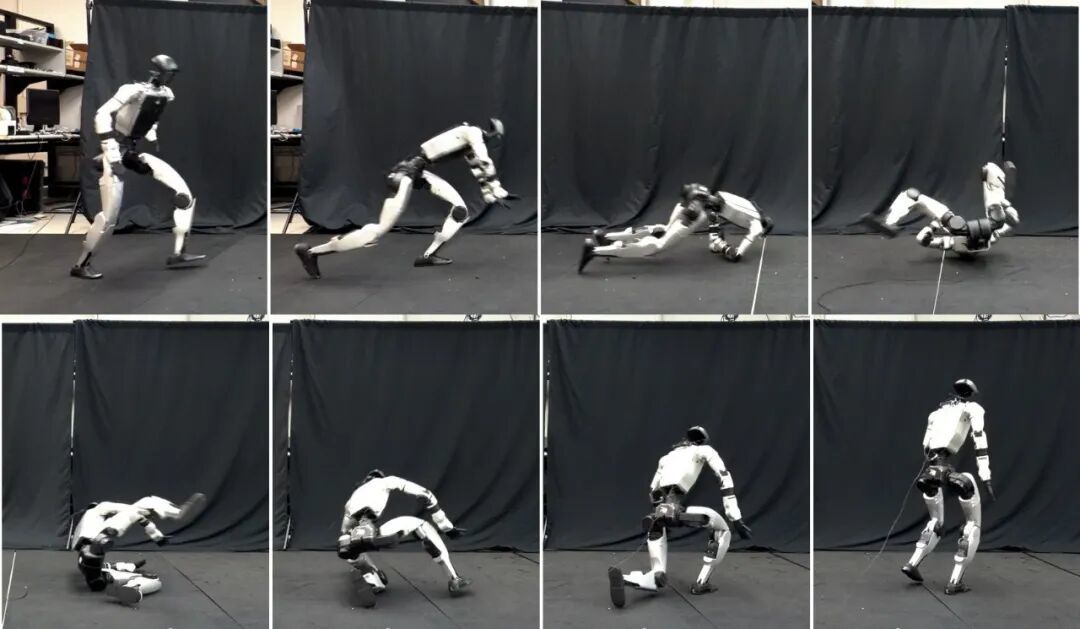
图:躯干与四肢接触地面的侧滚,相邻帧间隔 0.3 秒
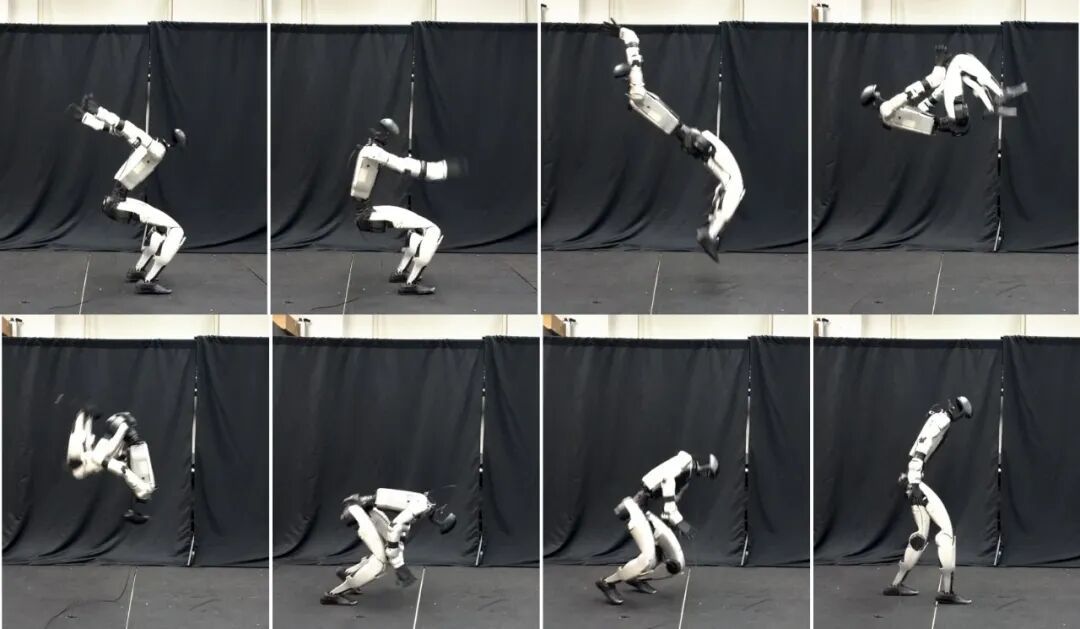
图:90 度翻转,相邻帧间隔 0.2 秒
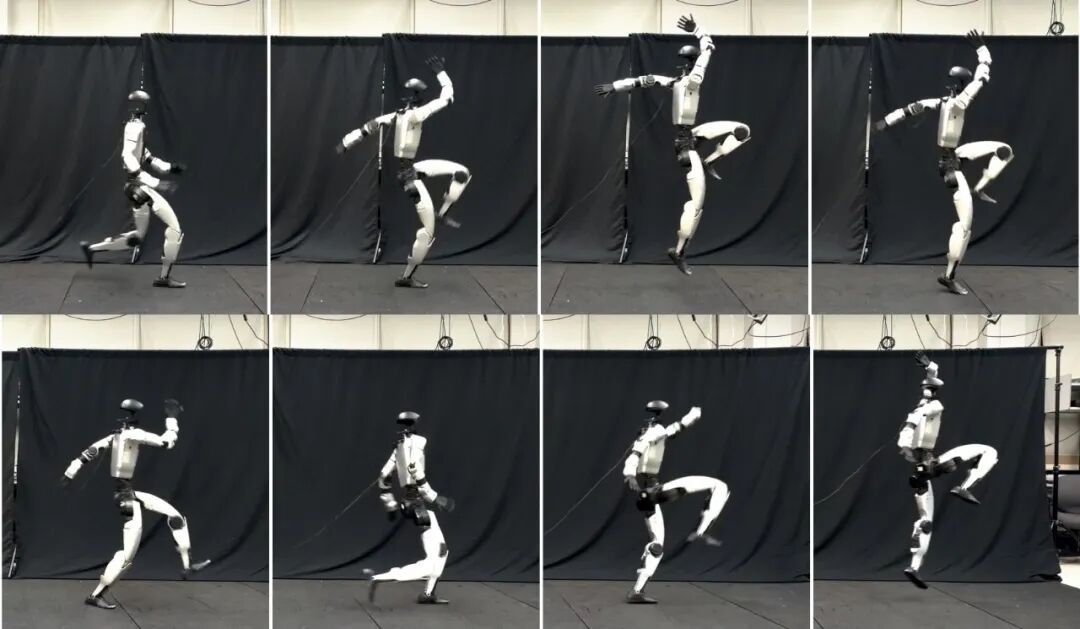
图:原地 360 度翻转,相邻帧间隔 0.2 秒
3.7 附带发现:同一个世界模型还能训下游接口
一个初步实验:速度编码器不靠蒸馏,而是直接用接口自己的任务奖励、通过同一个世界模型训练。在覆盖速度空间的 672 条阶跃响应上,RL 训练的速度编码器有 650 条稳态误差更低,蒸馏基线只有 15 条更好;至于摔倒,只有蒸馏基线摔倒过,共 7 次,全在几乎没有动作库数据的快速转向指令上。
4 — 局限与未来
论文自己承认的短板有三条。
第一、三条尤其值得再往前推一步。如果这个世界模型真能吃真机数据,它就不只是「便宜的仿真器」,而是一个能持续自我标注的动力学先验——那时候人形机器人的瓶颈才会从算力转到别的地方。而地形与交互一旦接上,世界模型要建模的就不只是「身体怎么动」,还有「身体碰到世界会怎样」,那才是真正难的部分。
论文与资源
— 完 —
原文链接: https://www.leiphone.com/category/private/par2CAtnKvORrFa7.html
