


来源:工控路
文章链接:https://mp\.weixin\.qq\.com/s/aPPIgLr\-ZHibah\_Atz47Sw
3 小时,1 张 H100。对面是 168 小时,128 张 L40。这组数字是真的,但它不是全部。
01两份账,56 倍和 7200 倍
前者是 UC Berkeley 这篇 CoRL 2026 Oral(arXiv:2610.28480)。后者是 SONIC,人形全身跟踪的公开基线,发在 Science Robotics 今年第 117 期,128 张 L40 连跑 7 天,约 21,000 GPU 小时。SuperMimic 这边约 3 GPU 小时。这里比的对手不是重新训一遍的 SONIC,是它公开释放的那个 checkpoint。
论文摘要只写"超过 1000 倍"。脚注把两个数拆开了:墙钟约 56 倍,GPU 小时约 7200 倍。
差的这一截全在卡数上。GPU 小时按卡数乘,墙钟不乘。引用时这两个数不能混着用:墙钟 56 倍讲的是"这套设备要占多久",GPU 小时 7200 倍讲的是"折合多少机器时"。采购看后者,排产看前者。
摘要选 1000 这个保守值有道理。7200 是拿 21,000 除 3 得来的理想值,只要 3 小时那个口径稍松,倍数就往下掉。写 1000 留了七倍余量。
官方自己列了两个混淆项,这是全文最诚实的一段。数据量差 2.3 倍。SuperMimic 用 264.56 小时动作,是 BONES-SEED 里 SONIC 611 小时数据的公开子集。峰值算力也不对等:H100 的 fp32 是 L40 的 0.74 倍,张量核是 5.5 倍。两次运行各自吃到多少峰值,论文写"未知"。
2.3 乘 5.5 等于 12.65。离 1000 还差两个数量级。剩下那截只能落在"算的东西不一样"上,堆硬件堆不出来。
换个算法更直白。按张量核峰值把 H100 折成 L40,7200 除以 5.5 约 1300 倍,余量确实不厚。两种算法都指向同一件事:这个差距不是卡的型号解释得了的。
3 小时的口径也要看清。它含完整训练循环,采数据、拟合世界模型、更新策略都算在内。checkpoint 的评测时间不计入,那是训练完单独跑的。
图 1:一边是一张卡跑 3 小时,一边是 128 张卡跑 168 小时,折合 GPU 小时差约三个数量级
02梯度不从仿真器走
这篇跟"可微仿真器"是两回事。它不对 MuJoCo Warp 求导,而是先记录仿真里的转移,再拟一个世界模型(world model),梯度从学到的模型上走。
绕这一步换来的是兼容性。接触是非光滑的,真去对刚体仿真器求导,又贵又不稳。学一个替代品,仿真器只当数据源。官方 FAQ 的说法很直接:接触非光滑的仿真器可以直接用。
世界模型由动力学 f_ω 加三个头组成。头分别是奖励、观测、终止,每个头可以学,也可以解析算。动力学是三层 MLP(多层感知机),宽度 2048。输入是当前状态、动作,以及每回合的仿真上下文 ξ——摩擦系数、关节标定偏移、躯干质心偏移三项。
拟合用 k=8 的自回归窗口。从记录的状态 s_0 起步,按记录的动作往前推 8 步,损失是状态、奖励、观测、终止四项之和。窗口短是有意的:它只需要教会模型自己纠错,不需要它一次预测很远。
策略那一步固定 ω,在想象 rollout(在世界模型里向前推演)上做 H=32 步的 BPTT(沿时间反向传播),第 32 步以后的回报交给 critic(价值网络)V_ψ 估。这是 SHAC 一系的做法,差别在于它把硬终止换成了生存权重,critic 也没有指数滑动平均的目标网络。
省在哪一步,值得说细一点。PPO(近端策略优化)走的是采样路线。跑一批动作,用回报给动作打分,再用似然比把打分变成梯度。这个估计方差大,要靠海量样本把噪声压下去。BPTT 直接对动作求导,短视野下一阶梯度的方差低得多,同样的信息量需要的样本少。
论文用一个干净对照把"快"和"梯度好"分开了。同等回报下,它比"在世界模型上跑 PPO"(PPO-WM)少约 64 倍想象步。这两边用的是同一个世界模型,rollout 速度一样。如果收益只来自推演快,PPO-WM 该同比例受益,实测没有。差额只能记在梯度形式上。
rollout 快也是真的。实用批量(2k–16k 环境)下比 MuJoCo Warp 快 10 倍以上。64k 环境时到 62 倍,那里 MuJoCo Warp 的曲线已经压平。
工程参数在这里。每卡 4096 个并行环境,回放池每环境 1000 步。每次更新 4096 条想象 rollout,训练 320,000 次迭代。控制频率 50 Hz,每步拆 4 个 5 ms 子步。动作是 29 维关节设定值,编码器输出 32 维隐变量再过 tanh。
0340 条 clip 的单卡 1.2 小时
真正能当对照的是 LAFAN1 那组。40 条 G1 retarget 动作,2.45 小时素材。两边共用同一套动作、观测、奖励、终止条件、域随机化范围、网络宽度和评测协议。
SuperMimic 单卡 1.2 小时到归一化回报 0.82。
PPO-Sim 在 18 小时预算内没摸到 0.82。它的最终回报是单卡 0.60、4 卡 0.70、8 卡 0.72。PPO-Sim 每卡还开了 8192 个并行环境,是 SuperMimic 的两倍——并行度占优,照样输。
4 卡到 8 卡涨 0.02,这一截最能说明问题。若瓶颈是采样吞吐,加卡就该近似线性见效;斜率压平意味着采样量已经饱和。卡住的是梯度从哪来。靠堆卡在这条路上没有回报,这是本文给工程判断的第一条。
0.82 是论文自己设的目标线,不是行业标准。40 条 clip 的样本量也撑不起"能省多少倍"的普适结论。它能撑住的只有一句:同一份预算、同一套配方,学得更快。
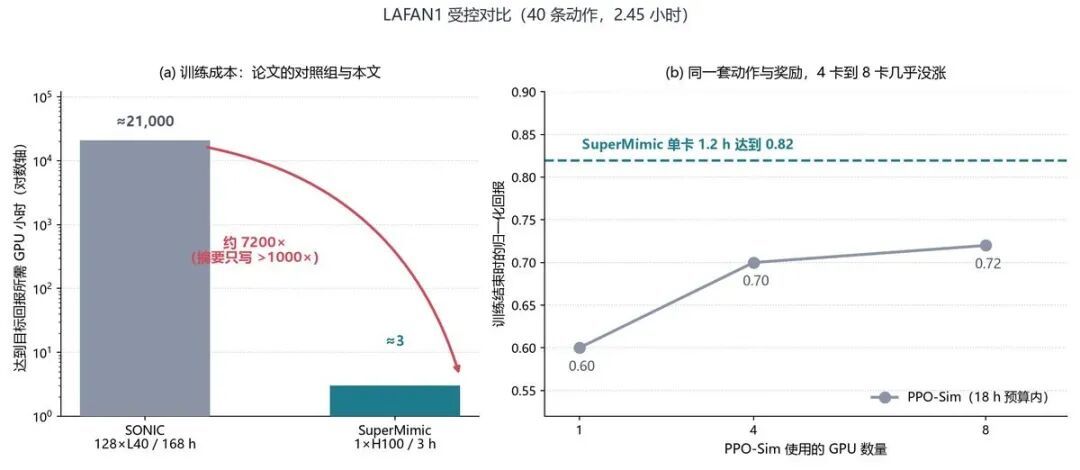
图 2:左图是 GPU 小时的对数轴对比,右图是 PPO-Sim 从 1 卡加到 8 卡的最终回报,斜率已经压平
04critic 撑住的是视野之外
无 critic 时,H≤16 训练直接失败。加上 critic,H=16 等效于无 critic 的 H=32,H=32 最快到 0.82。H 从 64 抬到 128,到 0.82 的时间接近三倍,最终回报还降。H=128 已经是单张 H100 放得下的最长视野。
论文没给"预测误差随视野步数变化"的曲线,只有 8 步误差随数据量变化的曲线。所以视野拉长为什么反而更慢,论文没解释。一个合理的解释是反传路径变长,第 100 步那段的模型误差被一并传回策略,抵消了长视野带来的信息。论文没给这条曲线,所以这句是推断。
推扰那组数更能说明问题。测试办法是让机器人在仿真里保持静态 T-pose,再施加 0.5–4 m/s 的速度推。有 critic 的策略 0.5–2.4 秒内稳住;无 critic 的一直趔趄,4 m/s 直接倒。两组策略在名义跟踪回报上差不多。
推扰这组数比 25/129,514 更能说明策略质量。前者测的是被推一下还能不能站住,后者测的是照着参考动得像不像。上机之后先遇到的,是前者。论文把它放在 §4.3,我建议读的时候先看这一段,再看 benchmark。
0525/129,514 的分母是什么
Appendix F.1 写得直白:分母是同一个过滤后的 BONES-SEED 训练集 benchmark,129,514 条,每条从第一帧播一次。没有 held-out(留出集),没有泛化测试。
数据从 142,220 条过滤到 129,514 条,过两道关。名称过滤砍掉 12,553 条,靠 clip 名字里的关键词,比如 stair、ladder、box、chair。可行性过滤再砍 153 条,判据三条,都靠前向运动学算:最高身体连杆高于 0.20 米并持续 0.6 秒即出局;穿地深于 0.12 米出局;双脚同时离地超过 0.02 米并持续 0.5 秒也出局。
评测设置很干净:脚摩擦固定 1.0,无域随机化,无观测噪声,确定性物理。
裁判口径是这组数字最该看的地方。失败与否按 SuperMimic 自己的训练终止条件判:骨盆高度偏离参考超过 0.25 米,或倾角误差超过 0.8(约 78 度)。论文在附录里明写一句"Unlike BeyondMimic, we do not terminate on end-effector deviation"——它不管手脚位置跟参考差多少。
也就是说,这 129,514 条里算"通过"的动作,含义是没倒,不是动作跟得像。手脚跟不上参考、只保持站姿,在这把尺子下也不算失败。SONIC 自己的判据反过来,只看根和末端的高度偏差超 0.25 米,不含姿态项。两把尺子抓的东西不一样,而这一轮统一用 SuperMimic 那把。按这把尺子,SONIC 公开的 checkpoint 挂 179 条,它的 v1.1 挂 239 条。正文引的是 179。挑好版本比,这个选择对 SONIC 已经算客气。
种子方差没报。论文的说法是"跑了几个随机种子,训练很稳",理由是跟踪任务的奖励每步都稠密,图里因此没有误差棒。
这不是造假,25 和 179 都是跑出来的。但它是拟合能力的上界,不是泛化的证据。训练过的动作、无扰动的物理、不含末端偏差的终止条件,三个条件叠在一起,读数只能往"覆盖得全不全"上解释。
分组看更清楚:
▪︎ 侧滚 22 条,SONIC 全挂,3 小时剩 2 条,9.8 小时清零
▪︎ 空翻 44 条,SONIC 全挂,3 小时剩 1 条,9.8 小时清零
▪︎ 交叉腿 10 条,从 9 条降到 0
▪︎ 躺卧与起身 99 条,28 条降到 8 条再降到 0
▪︎ 立定跳远 24 条,15 条直接清零
▪︎ 舞蹈 8 条,SONIC 全挂,3 小时就清零
▪︎ 其余 129,307 条,从 53 条到 14 条到 0
失败集中在硬动作上,这个分布合理。它同时说明另一件事:这些硬动作在训练集里出现过,模型见过。论文自己也没回避,benchmark 上的动作对两边都是训练动作,计数测的是覆盖程度。
图 3:原始 142,220 条动作经名称与可行性两道过滤后剩 129,514 条,全部用作评测分母
06真机四条动作
§4.4 只有一个通用跟踪器,不做逐动作调参,上真机 Unitree G1,跑 4 条:单脚跳测移动,侧滚测躯干四肢贴地的接触密集动作,90 度空翻和原地 360 度空翻测爆发。局限章节自认两条:世界模型只吃仿真数据;只训练平地,地形与物体交互列为后续工作。
129,514 和 4 差两个数量级。这两组证据不在一个档位上:仿真那边证明能覆盖,真机这边只证明这四条能跑。做工程估算,要按 4 条那一侧的方差算风险,不能拿 25/129,514 的成功率去推产线表现。
还有一处没写。论文没给真机试跑的总次数和失败次数。四条动作是挑过的,覆盖面合理,但都属于成功展示。
图 4:真机上跑的是单脚跳、侧滚、90 度空翻、原地 360 度空翻这四条,平地,无物体交互
07官方零仓库,社区四十五个
项目页 supermimic.github.io 上只有论文 PDF 和 demo 视频。没有 GitHub 链接,没有代码,没有许可证声明。
GitHub 上有个 supermimic 账号,建于 2026-10-10。公开仓库 0 个(2026-10-25 查)。但搜 "supermimic" 有 45 个仓库,全部建在 10-21 之后。论文 10-20 挂上 arXiv,第二天社区就动手了。
星数最高的是 zita-ch/supermimic_vibed,485 星、44 fork、MIT。建于 10-21 17:29,末次提交 20:39,前后不到 3 小时。README 自述 "speed-vibecoded in 1 hour with an AI coding assistant",作者自己补了一句 "code is too much slop"。他叫 Chong Zhang,在 ETH Zurich,声明不挂在任何实验室组织下。这个仓库复现的是 Fig.4a 那组受控对比:单张 RTX PRO 6000 跑 1.47 小时,评测回报 0.829,40 条全过。
第二梯队两个。CuboiLeo/SuperMimic-Reproduced 是 206 星、19 fork、MIT,基于 mjlab 加 MuJoCo Warp。Motphys/Uni-SuperMimic 是 117 星、8 fork、Apache-2.0,在 UniLab 上独立复现,支持 mjwarp、MuJoCo、Motrix 三个后端。
两个小仓库更值得读。JackMin7/supermimic_whole_body_tracking,19 星、MIT,任务还是同一个静态站立,MBRL 对原生 PPO(BeyondMimic 代码基)。两边各训 1 小时、256 环境、seed=42,关掉推扰、域随机化、观测噪声。20 秒站立成功 32/32 对 12/32,平均维持 20.00 秒对 9.63 秒,关节 RMSE 0.144 对 0.415 rad。作者自己写明:单种子、共享 GPU、无扰动、32 个副本不是独立种子,不据此宣称训练加速或真机效果。
btx0424/rethinking-supermimic,20 星,无许可证。README 里一张对照表,列出论文未指定的 12 个实现选择,逐条给出自己和 vibed 各填了什么。位置包括动力学状态含不含坐标、MLP 用什么激活和归一化。还有世界模型损失用不用名义尺度、goal 编码含不含当前帧与坐标系。critic 吃什么、关节偏置加到编码器偏置还是 PD 目标、回合边界怎么算、策略何时开始学,也都空着。同一处选择,两个复现给了不同答案——vibed 关掉自碰撞,rethinking 保留。
许可证这件事得说清。官方无任何许可,默认保留全部权利。第三方复现是 MIT、Apache-2.0、无许可混着来。想商用别指望论文,能参考的只有 MIT 那几个,它们各自"从论文猜"的部分还不一样。
45 个仓库、一小时 AI 生成、485 星,这个信号指向论文写得不够细,不是方法简单。12 个未指定选择意味着每个复现都在替作者做决定,包括那些会影响结果的。
同一批作者的前作 BeyondMimic 也发在 Science Robotics 11(117)。这篇是同一条路线上的降算力版本,降算力做得干净,把实现细节写清楚这件事没做完。
08想复现的三步
选仓库。要贴着论文数字走,用 zita-ch/supermimic_vibed,MIT,有 0/40 的实测,对得上 Fig.4a。要改结构、换后端,用 CuboiLeo 那个 206 星的 mjlab 版本。
盯三个数。单卡到 0.82 的墙钟小时,论文 1.2,vibed 1.47。40 条 clip 的失败数。8 步预测误差,论文在数据从 1 小时涨到 264 小时的过程中把它稳在 0.007–0.011;这个数只算状态一项,按预设的名义误差归一化,不是物理单位。它是世界模型有没有拟对的早期信号,它一飘,前两个数不用看。
认清边界。平地、无物体交互、只有仿真数据,三条都不在论文覆盖范围内。要上地形、要抓东西、要用真机自采数据补模型,得先自己补实验。
观察节点留给官方仓库。等代码放出来,看它填那 12 个选择时跟社区哪个版本一致。不一致,说明这些选择真的影响结果,那时再谈复现难度。
09来源清单
▪︎ SuperMimic: Scaling Humanoid Whole-Body Control with One Differentiable World Model,arXiv:2610.28480v1,2026-10-20,CoRL 2026 Oral,UC Berkeley
▪︎ 项目页 https://supermimic\.github\.io(2026\-10\-25 查:无代码、无许可证、仅论文与 demo)
▪︎ SONIC,Science Robotics 11(117):eaed4592, 2026(论文引 [1],128 卡 L40、168 小时、约 21,000 GPU 小时)
▪︎ BeyondMimic,Science Robotics 11(117):eadx8924, 2026(论文引 [3],跟踪奖励与 PPO 超参来源)
▪︎ BONES-SEED 动作数据集,huggingface.co/datasets/bones-studio/seed(原始 142,220 条 G1 retarget)
▪︎ LAFAN1,Harvey et al.,ACM TOG 39(4):60, 2020(40 条 clip、2.45 小时)
▪︎ GitHub 检索 "supermimic",45 个仓库,全部创建于 2026-10-21 之后
▪︎ zita-ch/supermimic_vibed,485★/44 fork/MIT,RTX PRO 6000 1.47 h、回报 0.829、0/40 失败
▪︎ CuboiLeo/SuperMimic-Reproduced,206★/19 fork/MIT,mjlab + MuJoCo Warp
▪︎ Motphys/Uni-SuperMimic,117★/8 fork/Apache-2.0,UniLab,支持 mjwarp/MuJoCo/Motrix
▪︎ JackMin7/supermimic_whole_body_tracking,19★/MIT,MBRL 对 PPO 一小时对照,作者声明单种子
▪︎ btx0424/rethinking-supermimic,20★/无许可证,列出论文 12 个未指定的实现选择
原文链接: https://www.leiphone.com/category/private/mata1x6tcrip8fAr.html
