


来源:调研纪要更新
文章链接:https://mp\.weixin\.qq\.com/s/sryJ\_WwnWRx9GpzElA\_DrA
本文内容基于《全球机器人行业:具身智能的 “ChatGPT 时刻” 渐行渐近》(英文标题:Global Robotics: The ChatGPT moment comes into view)整理,报告发布机构:野村证券(Nomura),发布时间:2026 年 10 月 23 日。本文仅作产业信息交流与学术研究参考,不构成任何投资建议。文中所有观点均来自原报告,不代表本公众号立场。市场有风险,投资需谨慎。
具身智能的 ChatGPT 时刻 真的近了?
野村最新的全球机器人产业研报抛出了一个很明确的判断 —— 机器人正在完整复刻大语言模型的发展路径,它的 ChatGPT 时刻,比行业普遍预期的要来得更早。今年 12 月到明年 1 月的新一轮模型发布,会是第一个关键催化节点,而最终的突破,大概率出自头部 AI 实验室和特斯拉之手。
模型路线 复刻 LLM 的三级跳
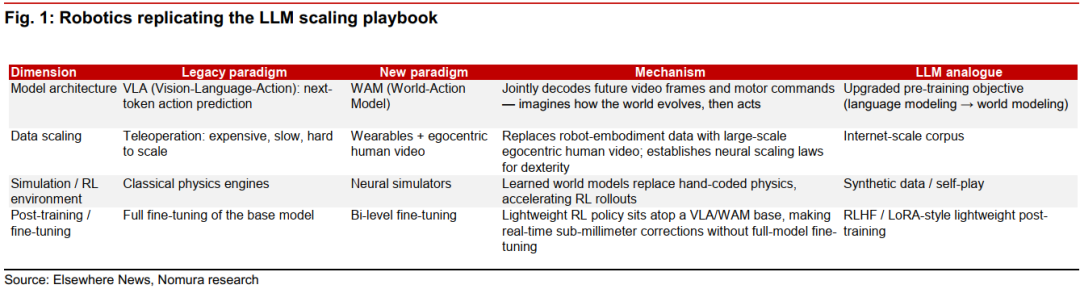
英伟达的一位科学家提出过一个观点,机器人训练会经历和大语言模型完全一样的三个阶段:先从海量数据里做广泛的通用学习,再针对特定任务做微调,最后通过强化学习在试错里持续迭代。野村对照这个框架测算,现在的机器人产业,大概处在 2012 年 AlexNet 时刻的 AI 行业,也就是深度学习刚证明自身价值的节点,还没摸到 GPT-2 的水平。下一批集中发布的新模型,大概率能摸到 GPT-2 的门槛,有明显潜力但还没法直接量产落地。
行业内对这个节奏的判断偏差不小。宇树创始人王兴兴 10 月 22 日公开表态,物理 AI 已经显现早期突破迹象,大概 1 到 3 年内会有质变,而且几乎所有人,包括他自己,都还在低估 AI 的进化速度。OpenAI 的奥特曼则相对保守,他对《财富》杂志说,2027 年会拿出一个 “像样的” OpenAI 机器人演示,真正走上街头还要再等几年。
GPT-3 式的少样本学习能力,现在已经在实验室里露出了苗头。以前教机器人一个新任务要几十上百次演示,现在一两次就够。野村统计了三家最新的进展:Generalist 的 GEN-1.5 模型,看一段 3 到 12 秒的演示就能学习新任务,十项测试不加额外训练的成功率是 59%,补五分钟数据之后能冲到 83%;Skild AI 在 8 月底发布的 S1,能通过观看人类操作视频学会最长十分钟的任务,比如冲咖啡,只是没有公开具体成功率;蚂蚁集团旗下的 Robbyant,在 8 月的论文里提到它的 Zero-WAM 模型,在七个从未见过的仿真任务里成功率 47%,比之前同级别最好的模型高出 29.5 个百分点。
不过话又说回来,这些结果全部来自实验室或者仿真环境。Skild 的 CEO 自己也承认,S1 还没达到能进家庭的程度,机器人行业还没有迎来真正的 ChatGPT 时刻。
目前三条技术路线在争夺机器人 “大脑” 的主导权,成熟度各不相同。VLA 也就是视觉 - 语言 - 动作模型,逻辑是看场景、接指令、输出运动路径,交给下层控制器执行,现在端侧部署的 VLA 参数在 20 到 70 亿,对应的芯片加存储成本大概 3 万到 4 万人民币。世界模型的思路更进一步,要预测机器人做出动作之后物理世界会发生什么变化,按照李飞飞参与创办的 World Labs 的框架,它分成渲染器、物理模拟器、规划器三层,Sora 这类视频生成模型就处在渲染器的位置。第三条路线是仿真环境里的强化学习,最典型的就是宇树的行走机器人,纯在仿真里练出来的技能,直接就能迁移到真机上。
英伟达那边的判断是,π0、GR00T 这类早期 VLA 模型,把太多算力花在了语言理解上,知道物体是什么,但不知道物体怎么运动。他们的 WAM 路线用视频生成当物理引擎,逐帧预测的过程中自然就学会了重力、浮力、光影变化这些规律,一步同时算出后续画面和机器人该做的动作,遇到新场景不用额外训练。Dream Dojo 的通用基础世界模型走得更远,直接用视频模型替换物理引擎,机器人能同时在无数个仿真世界里练习。
但端侧的算力约束决定了,小模型才是真机的首选。野村的行业调研显示,World Labs 的 Atlas 世界模型参数在 1000 到 2000 亿,能生成完整视频的世界模型,运行算力是 VLA 的 3 到 10 倍,就算是做了内部压缩的轻量化版本,也要高出 30% 到 100%。所以至少到 2027 年,世界模型都会放在云端做训练和生成数据,真机上只跑轻量化的 VLA 和强化学习模型。
数据 真正的卡脖子项
模型路线再清晰,没有数据都是空谈。这是现在机器人行业最大的瓶颈,没有之一。大语言模型可以吃整个互联网的文本语料,机器人没有对等的现成数据。传统的遥操作数据采集,就是人远程操控机器人录数据,成本高、速度慢,单套设备能录的体量非常有限。
行业里普遍有个模糊的共识,“涌现时刻” 的阈值大概是 100 万小时的有效数据,差不多是一个人一生的操作时长。现在全行业统一格式的可用数据,大概只有 10 万小时。头部公司手里的高质量数据也就几十万小时,特斯拉 Optimus 刚过 50 万小时。长期来看训练启动至少需要 1000 万小时,远期要上亿小时,而现在全行业存量也就几百万小时,这里面统计口径还不一样,有的把所有录过的都算进去,真正严格可用的少得多。
数据质量的影响比数量还大。宇树那边的实际情况是,每录四个小时大概只有一小时能用,四比一的转化率。现在行业真正的竞争点,是谁能用最低的成本,最快把可用数据的规模做上去。
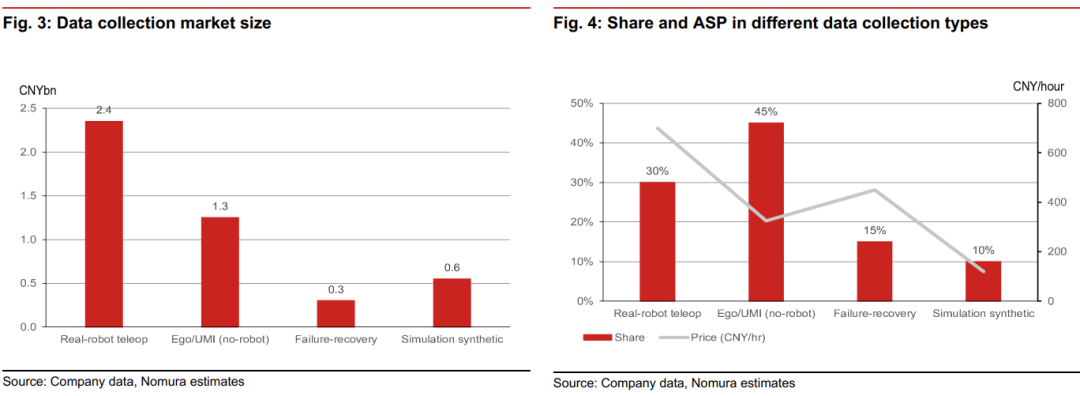
目前主流的四种数据采集方式,核心权衡点就是每小时成本和跨机型复用性。真人操控实体机器人的遥操作最贵,野村调研的区间是每小时 500 到 1000 元,中枢在 700 元,最大的问题是数据只能对应特定的机器人构型,腿式换轮式、两指换三指,数据基本就作废了。UMI 也就是通用操作界面,用人戴手持捕捉器录数据,每小时 100 到 300 元,但会干扰人的正常工作,基本都是小批量定制订单。Ego 第一人称视频,就是拍人日常做事的主观视角,每小时 300 到 350 元,最大的优势是跨代可用,机器人迭代多少代都能用。仿真最便宜,每小时大概 120 元,但涉及真实世界感知的任务里,仿真数据占比最多不超过 20%。
野村测算,2026 年中国机器人数据采集市场规模大概 40 到 50 亿人民币。按金额算,真人遥操作占比最高,大概 24 亿;Ego 视频加 UMI 大概 13 亿;仿真 6 亿;故障恢复数据 3 亿。按采集小时数算,Ego 和 UMI 占 45%,遥操作 30%,故障恢复 15%,仿真 10%。未来 12 到 24 个月价格还会持续下降,国内二十多个城市级数据工厂加上海外众包都会陆续起量。
现在行业正在快速形成共识,用人类第一人称视频做主要预训练数据。这个趋势一旦确定,大模型时代的缩放定律就会完整复用到机器人领域,谁的数据管线最强、算力最多,谁就能占领先机。英伟达的 EgoScale 就是这个思路,先用 21000 多小时的日常第一人称视频做预训练,再用少量遥操作和动捕数据微调。手部操作领域已经验证过,训练算力投入越多,性能提升越稳定,和当年大模型的增长曲线几乎一模一样。
真正炸场的是今年 CoRL 上的 SuperMimic 论文,它把训练成本直接打下来三个数量级。以前人形机器人的全身控制只有两条路,要么给每个动作单独训练专家模型再合并,精度损失很大;要么用海量算力硬训一个全局策略,成本极高。SuperMimic 换了个思路,训练一个模型专门学习机器人全身在所有运动下的规律,同时把控制器放在这个模型内部一起训,控制器直接从模型预测的短序列里学习,不用一步步试错。
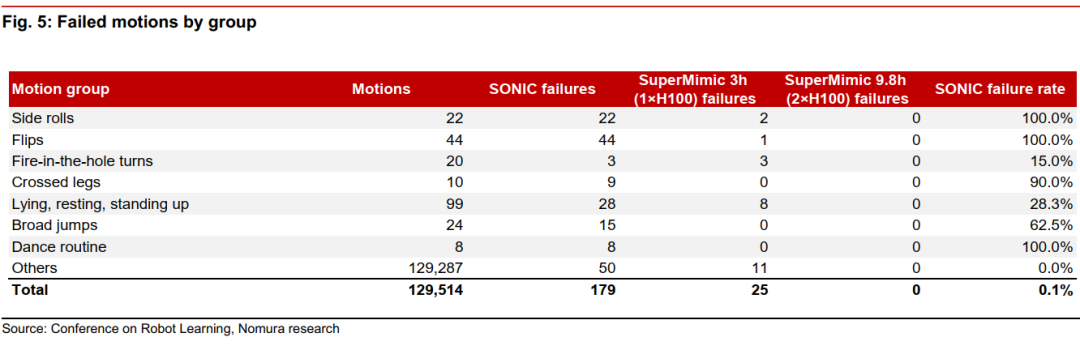
结果是单 GPU 训练 3 小时,效果就超过了 128 张 GPU 训练 7 天的基线方法,算力消耗减少了 1000 倍以上。在 129514 个测试动作里,老方法失败 179 次,SuperMimic 训练 3 小时失败 25 次,用两张 GPU 训练 9.8 小时之后,做到了零失败。这个控制器已经在宇树 G1 人形机器人上验证过,空翻、侧滚、舞蹈这类大跨度动作都能稳定运行,运动数据从 1 小时扩展到 264 小时,精度没有衰减。
这个算力下降的幅度,说实话我第一次看到的时候也愣了一下。它等于把全身控制的训练门槛直接拉低了一个量级,以前烧不起算力的团队也能做了。但反过来,算力不再是绝对瓶颈之后,真实场景数据的权重会变得更高,谁能先把机器人大规模铺到真实场景里跑数据,谁才能真正拉开差距。
硬件 从灵巧手开始的标准化
模型能力上来之后,最先受益的硬件就是灵巧手。以前机器人大多用简单夹爪,不是不想做五指手,是训练数据不够,再精密的机械也练不出对应的智能。基础模型变强之后,在两指、三指夹爪上学到的技能,可以迁移到五指手上,量起来之后单价就能往下走,形成正向循环。
野村预计 2026 年灵巧手出货量同比增长 80% 到 120%,增长主力就是高自由度多关节的五指手。今年工厂场景里,30% 到 50% 的传统夹爪会被替换掉。甚至专门做手部任务数据的创业公司,收入都比预期高很多。
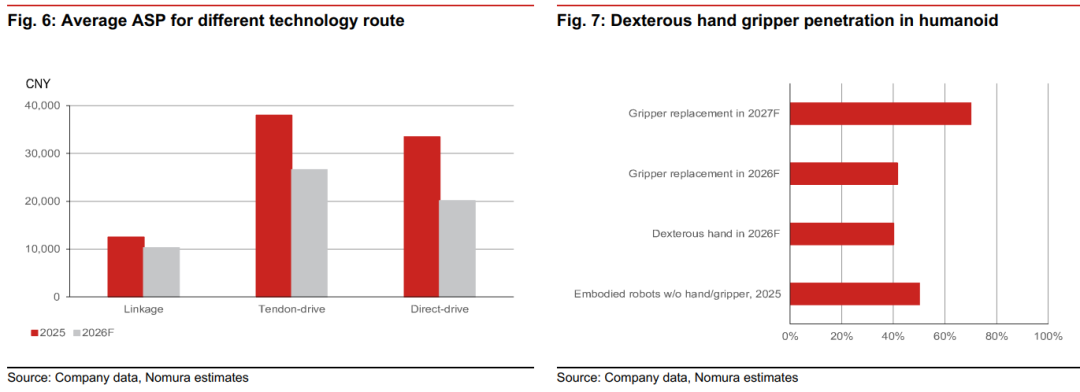
手部的变化只是开始,后面会蔓延到整个人形机器人。野村判断,等模型路线彻底定下来,人形机器人的设计会快速收敛到少数几种标准形态,也就是所谓的 “iPhone 时刻”。到那个阶段,最难的事情就不再是设计新机型,而是每一台都能用同样的方式造出来,保证不同个体的运动特性一致。
这件事的重要性怎么说都不为过。人形机器人有 20 多个关节,只要每台的行为有细微差别,在一台机器人上训练好的控制策略,换到另一台可能就失效了。做过硬件量产的人都懂,一致性这个东西说起来简单,做起来要人命。所以最终能跑出来的玩家,一定是迭代速度快、成本控制严的,比如宇树这类整机厂、车企,还有核心零部件供应商。
野村测算了量产成本的合理区间,1.7 米规格的人形机器人,大规模量产后成本在 15 万到 20 万人民币;1.3 米的小型款在 3 万到 4 万。整机物料成本里占比最高的是执行器,也就是每个关节的电机加减速器组件,占比在 50% 到 75%。
以宇树为例,人形机器人的 BOM 里 80% 到 90% 是自研设计,真正自主生产的大概 50%,第三方模块占 10% 到 15%,比如激光雷达用大疆 Livox,深度相机用 RealSense、奥比中光,灵巧手用 Sharpa。基础版本里美国元器件占 BOM 的 2% 到 8%,教育版因为搭载英伟达的芯片,占比会到 10% 到 20%。
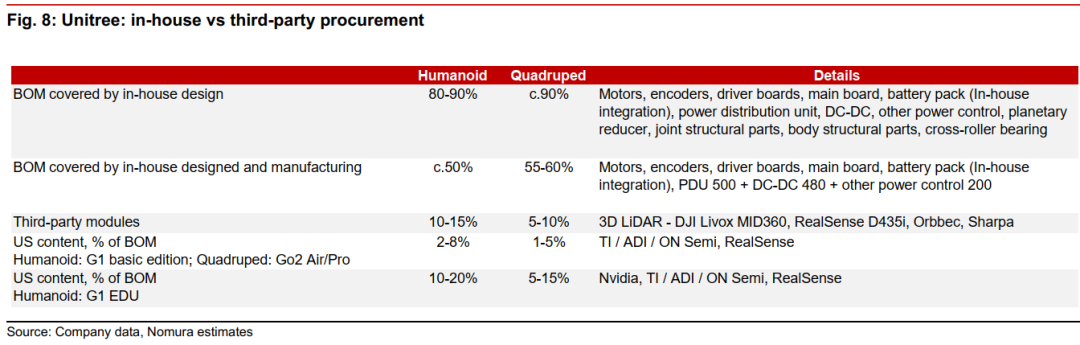
宇树现在的思路很明确,销量起来之后会提高外采比例,既能压成本又能保良率,这个路数和当年消费电子巨头的玩法是一致的。自研不是目的,能根据量能灵活切换自制和外采的比例,才是成本控制的核心。
野村也提出了硬件发展的三种可能场景,三者不是互斥关系,可以并行发生。第一种是头部 AI 实验室率先突破物理 AI,机器人走安卓手机的路线,大脑是统一平台,身体变成标准化硬件,DeepSeek 和字节已经在找供应商定制专用硬件,AI 公司大概率会采购第三方机器人,不会自己下场造。第二种是特斯拉的全栈模式跑通,价值集中在特斯拉的核心供应商和稀缺零部件厂商。第三种是全行业形成统一标准,通用零部件厂商整体受益,这个过程会从灵巧手开始,逐步扩散到其他核心部件。
怎么才算真的到了 ChatGPT 时刻
野村提了五个判断标准,用来衡量机器人是不是真的迎来了 ChatGPT 时刻。从调研数据看,现在全行业五项全不达标。
第一项是无人值守工作时长。现在最好的机器人也就连续跑几个小时不出错,而工厂场景的基本要求是连续跑一周不用人介入。第二项是精细手部作业能力,谷歌 Gemini Robotics 2 搭配 Apollo 2 机器人和 Sharpa Wave 手,系垃圾袋的成功率是 44%,把垃圾扫进簸箕的成功率是 32%。第三项是模型适配新机体的速度,谷歌的模型适配新机器要 7 到 8 小时,国内速度快的团队也要两周左右。第四项是学习新任务需要的演示次数,实验室里已经能做到一两次,但真实场景还差得远。第五项是工厂环境下的作业精度,现在行业平均大概 60%,工业量产要求 98% 以上,野村估计要 3 到 5 年才能补上这个缺口。
这五项里,野村认为第一项和第五项最重要。只有无人值守时长和作业精度达标了,客户才会从运营预算里掏钱买机器人,而不是只拿试验预算做试点。这才是行业真正爆发的标志。
接下来的催化节点
野村列了四个明确的催化剂,分别是 OpenAI 的物理 AI 模型、字节跳动和深度求索的新模型、OpenAI 人形机器人演示,以及大概率 2027 年推出的 GPT-7。
王兴兴也持类似的观点,他认为明年的 GPT-7 大概率能突破现在具身 AI 的核心瓶颈,宇树已经用 GPT-6 在自己的机器人上做过测试,效果非常好。
除了 AI 实验室,特斯拉是另一个极有可能做出突破的玩家。它有实验室没有的优势:完整的数据闭环和真实落地场景。野村的调研显示,特斯拉已经跑通了全链路,从仿真、世界模型到数据清洗、数据平台再到工厂测试,传感器和数据格式都已经定型。工厂里的常规重复性工作,特斯拉机器人能做到 97% 的无人值守率,从检查屏幕、取用工具到定点作业、自动充电都能完成。更关键的是,它还能用几百万台汽车的路拍视频训练通用世界模型,不只是机器人本身的数据。
实验室和特斯拉其实是互补关系。实验室有通用模型和顶尖人才,特斯拉有闭环数据和落地场景。不管哪边先突破,最终的赢家一定是同时具备算力、数据闭环、落地机器人群体的玩家,纯做机器人大脑的创业公司,会处在相对不利的位置。
当然也有两个明确的不确定性因素。一是产品一致性差的机器人整机厂,如果过度依赖客户帮忙采集数据,后续需求可能出现波动。二是机器人大脑创业公司的商业模式,可能会随着大模型公司的进场发生变化。
你觉得具身智能的第一个大规模落地场景,会先出现在 3C 工厂还是物流仓储?
#野村#具身智能#人形机器人#VLA模型#世界模型#机器人训练数据#灵巧手#AI物理智能
原文链接: https://www.leiphone.com/category/private/KGZF3H4EtTs3nUDb.html
