


*来源:AI in MICLab
*
文章链接:https://mp\.weixin\.qq\.com/s/WlptwEMdR15D5h0BHYFHpA
**
**
Author:Jialei Chen(2025级博士), Kai Wang, Kang Chen, Shuaihang Chen, Feng Gao, Wenhao Tang, Zhiyuan Li, Weilin Liu, Zhuyu Yao, Boxun Li, Yuanbo Xu(通讯作者), Chao Yu(通讯作者)
arXiv:https://arxiv\.org/abs/2606\.15768
项目主页:https://rlinf\.github\.io/LaWAM/
代码仓库:https://github\.com/RLinf/LaWAM
模型合集:https://huggingface\.co/collections/jialei02/lawam\-checkpoints
概述
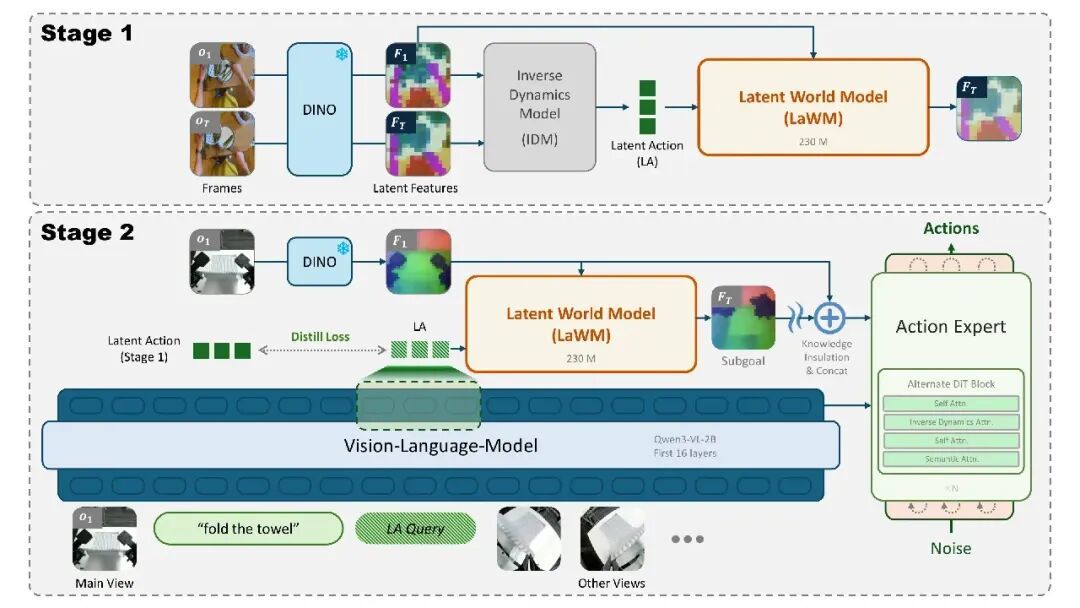
近年来,World-Action Models (WAMs) 试图通过预测未来观测来增强机器人策略:先想象未来,再生成动作。这个方向很自然,也很有潜力。但现有很多 WAM 依赖像素级未来视频生成,在机器人控制中会带来两个直接问题:慢:视频生成通常是迭代式的,推理延迟高;重:模型需要花大量容量重建纹理、背景和外观细节,而这些并不总是动作决策真正需要的动态信息。LaWAM 将未来预测压缩成动作相关的 latent visual subgoal。这些子目标不是给人观看的未来画面,而是给策略使用的动态线索:它们把任务意图、当前视觉状态和可能的状态变化连接起来,引导 action expert 更快生成下一段动作,将未来预测从像素空间搬到视觉潜空间中,通过紧凑的 latent visual subgoal 为机器人策略提供动态感知能力。
LaWAM 模型框架图
作者介绍
本文第一作者陈佳磊是吉林大学计算机科学与技术学院与北京中关村学院 2025 级联合培养博士生,在吉林大学徐原博教授和清华大学于超教授共同指导下完成。
方法核心:把 LAM decoder 变成 Latent World Model
LaWAM 的关键模块是 Latent World Model (LaWM)。
论文中,LaWM 来自对 Latent Action Model (LAM) 的重新理解。LAM 通常包含两部分:
先前许多 latent-action VLA 方法更关注 latent action 本身:它们希望把 latent action 当作一种跨本体、跨机器人平台的通用 action 接口。这个想法很有吸引力,因为 latent action 的确可以从不同 embodiment 的视觉转移中抽象出某种共享的“动作意图”。
但这种通用性也带来一个问题:
不同机器人有不同的关节结构、末端执行器、控制频率、动作空间和动力学约束。一个跨本体共享的 latent action 很难被简单、稳定地映射成某个具体机器人的底层真实 action。换句话说,latent action 可以表达“抽象转移”,但它并不天然等价于“这个机器人下一步该执行的动作”。如果直接把 latent action 当作本体特定 action 的代理,最终会影响动作预测精度。
LaWAM 因此做了一个重要转变:
具体来说,LaWAM 不丢弃 LAM decoder,而是把它保留下来,作为一个真正的 latent-action-conditioned world model。给定当前视觉特征和策略预测的 latent action,LaWM 会把抽象转移展开成当前任务情境下的未来视觉特征,也就是 latent visual subgoal。
这个 subgoal 再被送入 action expert,帮助 policy 获得 dynamics-aware 的动作生成能力。也就是说,LaWAM 不是试图把 latent action 直接翻译成真实动作,而是先让 world model 将 latent action 落地为具体场景中的未来子目标,再由 action expert 生成本体相关的动作 chunk。
两阶段训练:先学动态,再把动态注入策略
Stage 1:学习 Latent World Model
第一阶段使用视觉转移数据训练 LaWM。给定当前观测和目标时刻观测,模型先通过冻结视觉编码器得到视觉特征,再由 inverse-dynamics encoder 推断 latent action,最后由 decoder 预测未来潜在特征。
这个阶段的目标是让 LaWM 学会:
论文中 LaWM 预训练使用了约 3,000 小时机器人视频 和 1,500 小时 egocentric human videos。人类第一视角视频不直接用于策略集成,而是帮助 LaWM 学到更广泛的动态先验。
Stage 2:训练 Latent World Action Model
第二阶段将 LaWM 接入 VLA 策略。部署时没有真实未来观测,所以策略需要先从当前观测和语言指令中预测 latent action,再交给 LaWM 解码出 latent visual subgoal。
随后,action expert 在当前语义上下文和 latent future subgoal 的共同条件下生成动作 chunk。
论文中这一阶段结合了:
这让 LaWAM 不只是“加了一个未来 token”,而是建立了从动态预测到动作生成的完整接口。
为什么它快:一次 latent prediction,而不是反复生成视频
LaWAM 的效率来自一个关键设计:
在 LIBERO 上,LaWAM 的模型大小为 2.3B,action-chunk 推理延迟为 187ms。对比若干像素空间 WAM:
这意味着 LaWAM 保留了世界模型带来的未来条件能力,但摆脱了像素级视频生成的高昂代价。
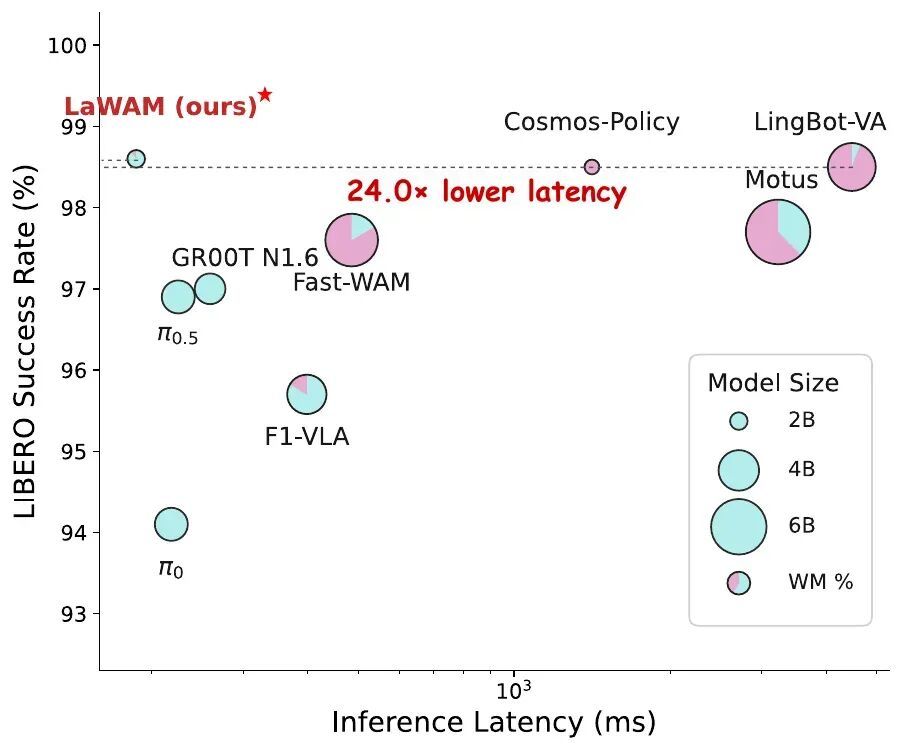
图:LIBERO 上的 latency-success trade-off。LaWAM 在保持高成功率的同时显著降低 action-chunk 推理延迟。
实验亮点一:LIBERO 上兼具高成功率和低延迟
在 LIBERO benchmark 上,LaWAM 在四个标准 suite 上取得 98.6% 平均成功率,优于或匹配强 VLA、latent-action 和 WAM baselines。
更重要的是,LaWAM 的优势并不只是成功率,而是成功率与延迟之间的平衡。
像素空间 WAM 可以通过强大的视频模型获得未来预测能力,但代价是更高延迟和更大世界模型模块。LaWAM 则通过 latent subgoal 将未来预测压缩到策略真正需要的空间中,使机器人在保持高成功率的同时更快行动。
这对于真实机器人尤其关键:机器人控制不是离线生成任务,环境会在等待中继续变化。延迟越高,策略基于的视觉状态越容易过时。
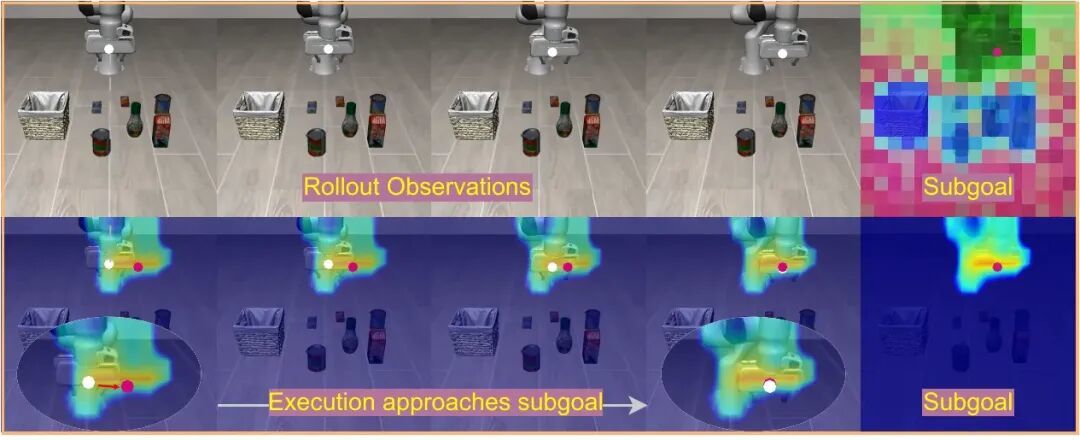
图:LIBERO chunk-level 可视化。预测出的 latent subgoal 通过 heatmap 体现出动作将要接近的区域,执行轨迹逐步朝 subgoal 推进。
实验亮点二:RoboTwin 上验证复杂双臂操作能力
RoboTwin 2.0 覆盖 50 个双臂操作任务,是检验机器人策略是否能扩展到复杂 bimanual manipulation 的重要场景。
LaWAM 在 RoboTwin 上取得:
这说明 latent subgoal prediction 不只是适用于单臂、短程任务,也能够扩展到更复杂的双臂协同控制场景。
论文结果还显示,LaWAM 在 clean scenes 上达到最优平均表现,在 randomized scenes 中也保持强竞争力。这说明 latent future interface 在场景扰动下仍然能提供有效的动态条件信息。
实验亮点三:真实机器人上跨任务、跨平台迁移
LaWAM 进一步在真实机器人上评估了三类任务:
实验覆盖两个机器人平台:
真实机器人结果如下:
LaWAM 在三个任务上都取得最高成功率。尤其在 towel folding 中,任务要求机器人持续响应布料运动;高延迟策略可能在生成动作时错过当前布料状态,导致动作基于过时观测。LaWAM 的低延迟 latent prediction 在这类动态任务上体现出明显价值。
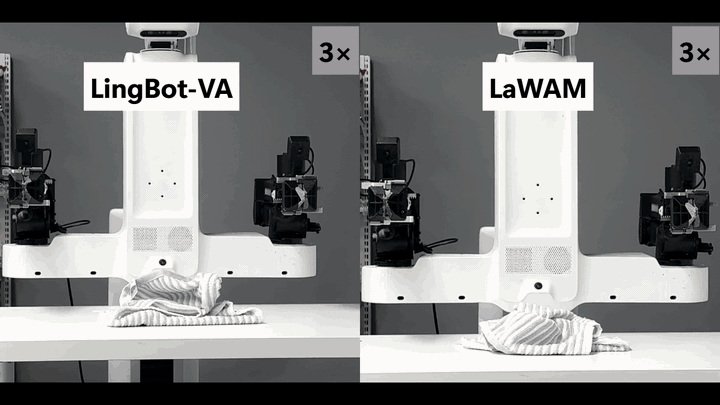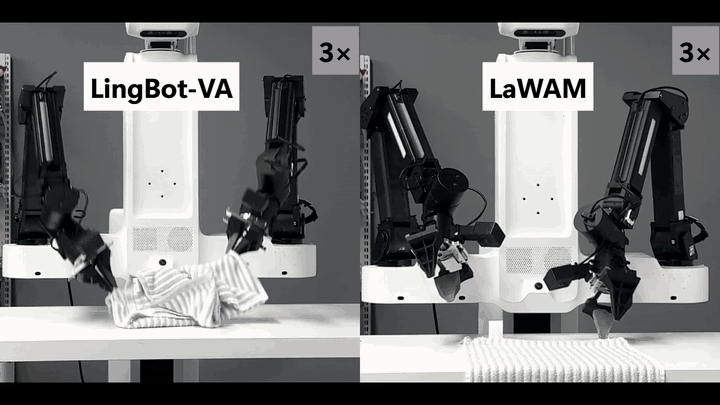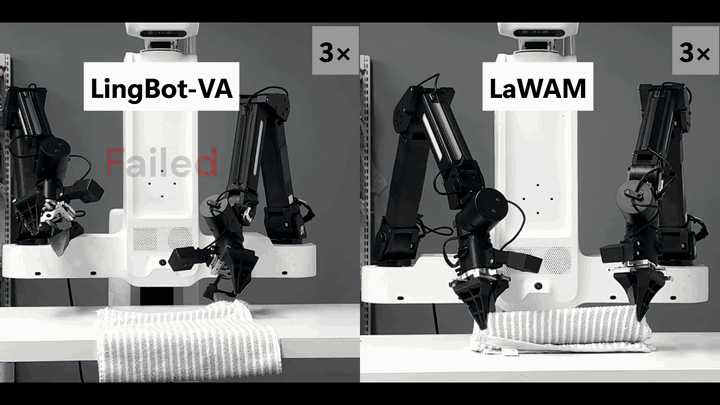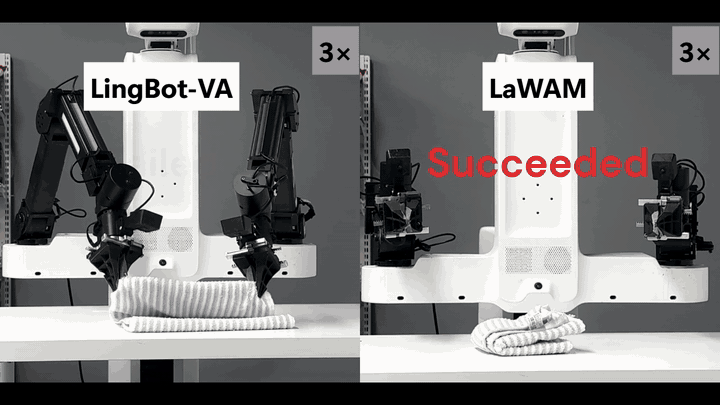
这组对比更直观地展示了 LaWAM 的优势:当对比方法(baseline)依赖像素级未来视频时,系统需要先花时间生成可视化未来,再把它用于动作决策;LaWAM 则跳过完整 future video,直接在潜在空间中预测对动作有用的 future feature。对折叠毛巾这类动态任务来说,少等一段生成时间,就意味着策略能更及时地响应布料当前状态。
因此,LaWAM 的优势不只是“预测未来”,而是以更适合机器人控制的形式预测未来:不生成给人看的视频,而生成给策略用的子目标。
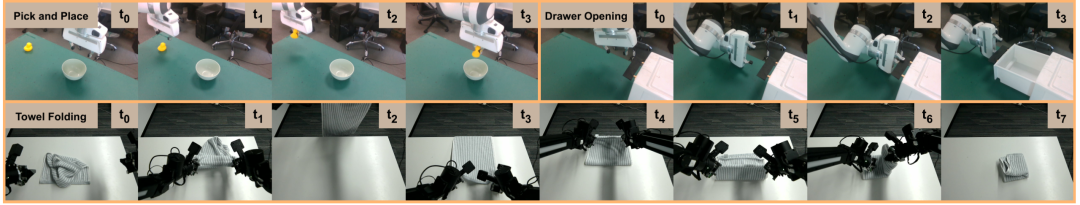
图:LaWAM 在真实机器人任务中的 representative rollouts,覆盖 pick-and-place、drawer opening 和 towel folding。
真实机器人推理可视化
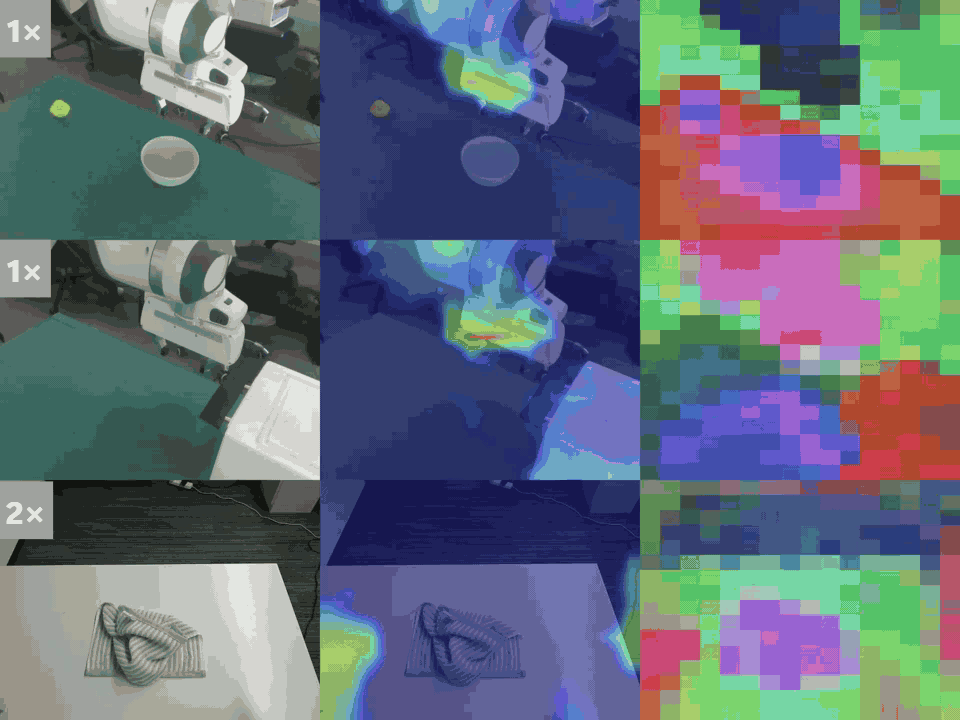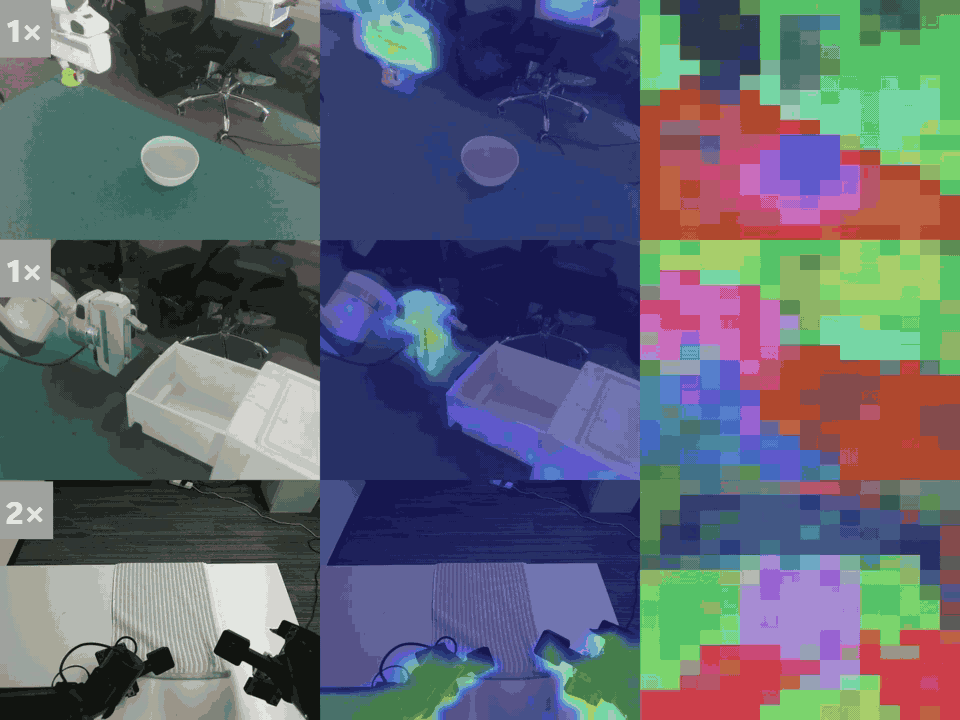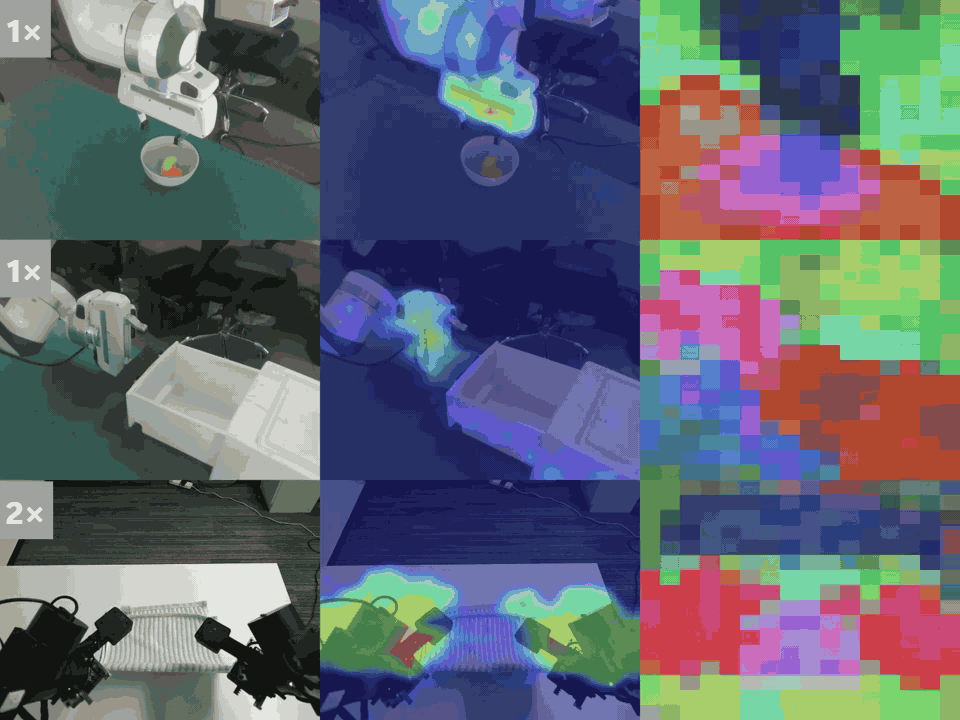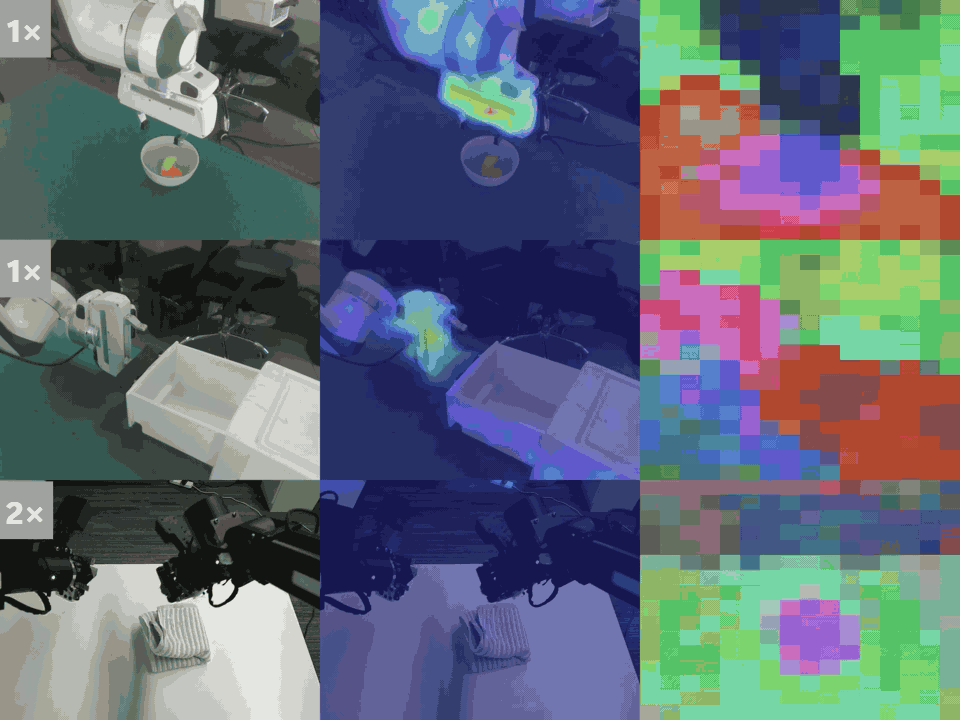
动图展示了 RGB execution、subgoal heatmaps 与 latent PCA 的对应关系:LaWAM 并不生成像素级 future video,而是把 future dynamics 编码成可被 action expert 使用的 latent visual subgoal。
可解释的 latent dynamics:同一个 latent action,在不同场景中落地
论文还分析了 LaWM 是否真正学习到了动态,而不是只提供一个辅助特征。
通过 open-loop rollout 可视化,论文展示了一个有意思的现象:将同一段 latent action trajectory 应用到不同初始观测、不同环境甚至不同 embodiment 中,LaWM 会生成 coherent 但 context-specific 的 latent changes。
如下图所示,LaWM 可以跨本体地做 rollout:同一段 latent action 不只可以作用于源视频中的机器人,也可以迁移到不同机器人、不同视角和不同场景中。尤其是图中的 (d)、(e) 场景来自此前未见过的 pi.website 截图,LaWM 仍然能够生成有结构的 latent rollout。
这说明了两件事。
第一,潜在空间中训练出的 LaWM 具有很强的跨场景、跨本体泛化性。它不是简单记忆某个机器人或某个背景,而是能把抽象转移放回当前视觉状态中进行 grounding。
第二,这也反过来说明 latent action 本身具有明显的本体无关性。它更像是一种跨 embodiment 的抽象动作意图,而不是可以直接和底层 action 对齐的控制量。因此,如果把 latent action 直接当成真实 action 的替代品,就会遇到本体结构差异带来的映射困难。
这也是 LaWAM 相比“只使用 latent action token”的重要区别:latent action 本身还不够,关键在于 LaWM 将其展开成 spatially structured latent visual subgoal。在 LaWAM 中,latent action 连接的是推理专家和 world model;真正赋予 policy dynamics-aware 能力的,是 LaWM 在具体任务情境下生成的 latent subgoal。
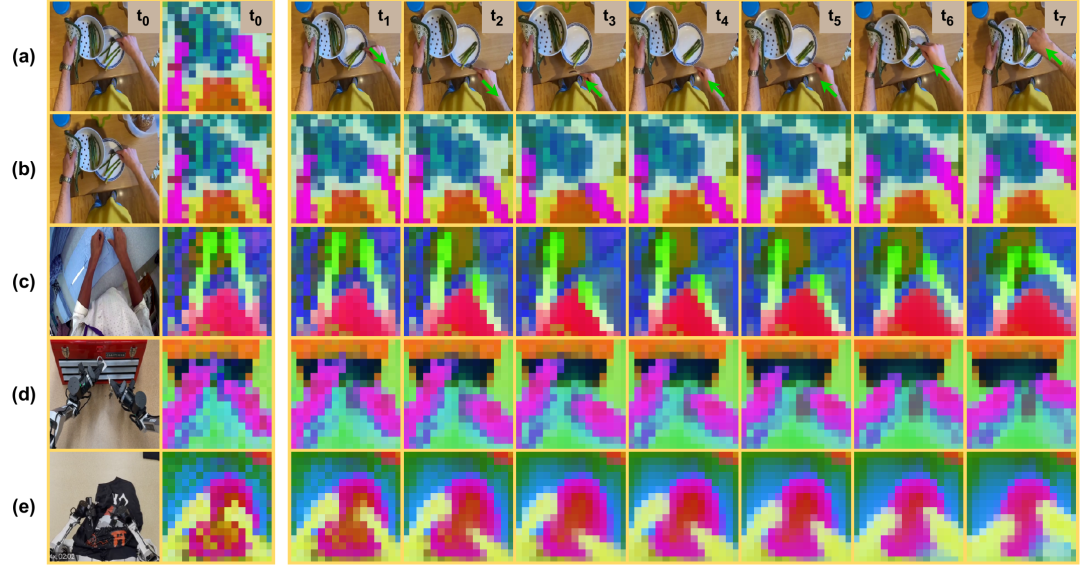
图:同一 latent action trajectory 在不同 embodiment 和场景下生成 context-specific latent rollouts。其中 (d)、(e) 使用来自 pi.website 的未见场景,展示了 LaWM 的跨场景泛化能力,也揭示了 latent action 的本体无关性。
消融实验:LaWM 是性能提升的核心来源
论文在 LIBERO 上进行了 component ablation。结果显示,当逐步削弱 LaWAM 的 latent future interface 时,性能会下降。
其中,移除 LaWM 会造成最大性能下降,尤其在 LIBERO-Long 上更明显。这表明显式的 latent subgoal conditioning 是 LaWAM 获益的关键来源。
此外,移除 latent-action distillation 也会显著影响性能,说明策略需要从 LAM posterior 中获得直接监督,才能稳定地驱动 LaWM。
这些结果共同说明:LaWAM 的提升不是来自单一 trick,而是来自一个完整的:
LaWAM 带来的启发
LaWAM 的意义不只是提出了一个新模型,更重要的是给出了一个关于机器人世界模型的 high-level 判断:
对机器人控制而言,未来表示应当满足三个条件:
LaWAM 的 latent visual subgoal 正是在这三个条件之间做折中:它不是给人观看的未来视频,而是给策略使用的未来线索。
结语:机器人需要怎样的“想象力”?
对机器人来说,想象未来不一定意味着生成一段完整视频。
真正重要的是:未来预测能否在正确的时间、以正确的形式进入动作生成。
LaWAM 给出的答案是:
当世界模型不再忙于重建每个像素,而是专注于 action-relevant dynamics,它就可以真正服务于机器人控制。
LaWAM 让机器人不必“画出未来”,也能朝着未来行动。 我们希望 LaWAM 能为高效世界模型、VLA 策略、latent dynamics modeling 和真实机器人迁移研究提供一个清晰、可复现、可扩展的起点。
欢迎大家阅读论文、访问项目主页、试用代码与模型,也欢迎关注我们后续在 latent dynamics modeling 方向的更多探索。
BibTeX
会议介绍
The 10th Annual Conference on Robot Learning(CoRL 2026)是机器人学与机器学习交叉领域最具影响力的顶级国际学术会议之一,将于 2026 年 11 月 9 日至 12 日在美国德克萨斯州奥斯汀举行。
CoRL 聚焦于机器人学与人工智能的前沿交叉研究,是具身智能与机器人学习领域的公认旗舰会议,代表了全球机器人学习领域的最高研究水平与未来发展方向。 
原文链接: https://www.leiphone.com/category/private/i3uNOswPH8AJk5Z7.html
