


来源:无人机具身智能
文章链接:https://mp\.weixin\.qq\.com/s/dKaaGbZK2o0j23g9GKfoeA
论文| PathPainter: Transferring the Generalization Ability of Image Generation Models to Embodied Navigation
作者 | Yijin Wang*、Yuru Tian*、Xijie Huang*(共同一作)、Yuze Wu†、Fei Gao† 等 · 浙江大学 · Differential Robotics · 北航
出处 | CoRL 2026(Austin)· arXiv:2605.07496
285 m
90%
0.852 m
0.766
四足真机长距离导航
10 次连续实验成功率
跨视角定位平均误差
域外路径规划成功率
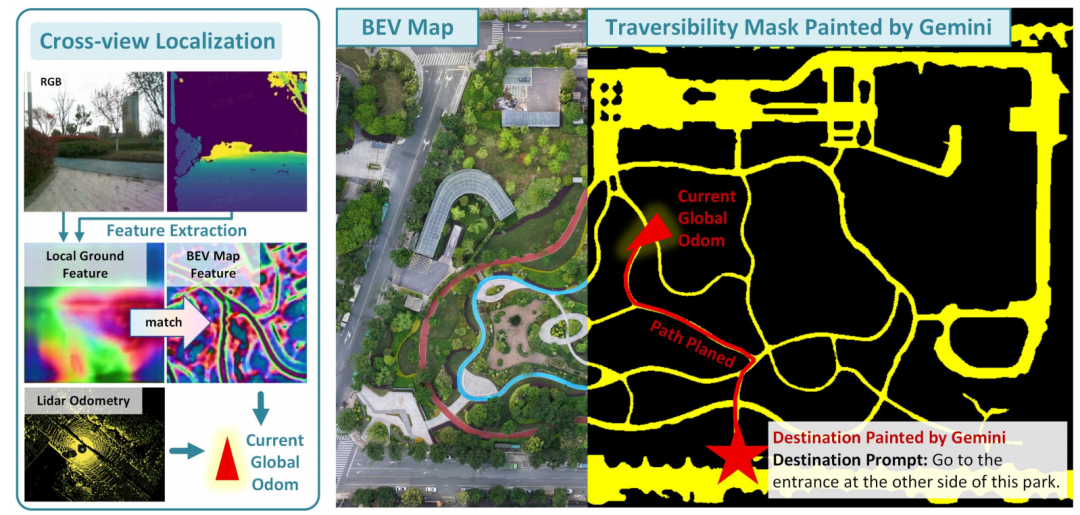
图 1|系统总览:跨视角定位对齐里程计,图像生成模型在 BEV 图上画出目标与可通行区域,A* 在其上搜路(图源:论文原文 Figure 1)
00 导语:换一个问题问
导航研究的惯常剧本是:为这个任务收集数据、训练一个策略或分割网络,然后在封闭测试集上刷分。浙江大学高飞、吴禹泽团队这篇文章换了一个问法——导航能不能直接变成一道"画图题"?训练都不用训:给现成的图像生成模型一张航拍俯视图、当前位置和一个自然语言指令,让它把"哪里能走"直接画在地图上,再用最经典的 A* 搜一条路出来。
生成模型见过海量"从空中看城市"的图像,对路网拓扑、开阔区域、障碍布局的先验远超任何一个导航专用数据集。这篇文章把这种泛化能力整个搬了过来:在三个数据集的零样本可通行性对比中,生成模型路线在分布外场景把专门的路网提取模型远远甩开;真机上,一台四足机器人只靠普通局部规划器,在 GPS 不可靠的公园里连续 10 次自主完成 285 米长距离导航,成功 9 次。
一句话读懂
与其教模型理解世界,不如把"理解"外包给已经理解世界的模型——机器人只负责把画好的地图走完。
01 速览:两层架构,一个大胆的重构
高层 · 生成
生成模型画目标 + 可通行掩码
→
中层 · 搜索
A* 在掩码上搜全局路径
→
低层 · 执行
跨视角定位 + 局部规划器
整个系统分两层。高层是本文的核心贡献:把"听懂指令 → 找到目的地 → 判断哪里能走"全部重构成图像到图像的生成任务,由现成的图像生成模型(论文最终选用 Gemini)完成。低层是务实的工程组合:跨视角定位把机器人里程计对齐到 BEV 地图,LiDAR 里程计加轻量局部规划器负责实时避障与轨迹跟踪。高层负责"想",低层负责"走",互不拖累。
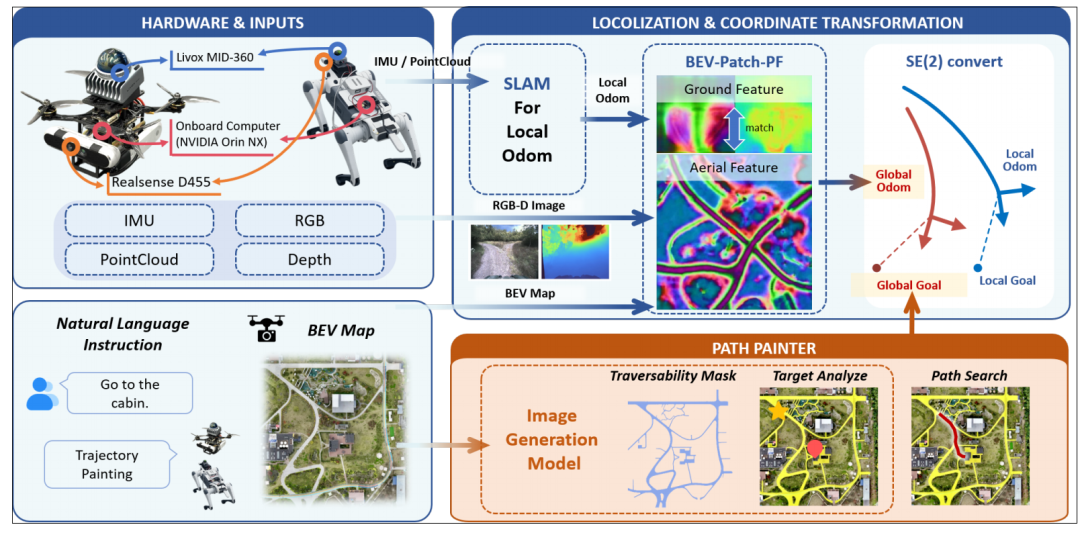
图 2|导航系统流程(图源:论文原文 Figure 2)
02 背景:航拍先验好用,但有两道坎
俯视图(BEV)天然带着全局信息:路的走向、哪片开阔、目标和参照物的空间关系。所以空地协同导航、卫星图导航这些方向都在用它。但现有系统过两道坎都不轻松。
第一道坎:怎么把航拍观测变成可执行的先验。常见做法把 BEV 图压缩成语义图、拓扑图或类别级表示——紧凑了,但路面边界、通道宽度、开阔区的连续性这些导航真正需要的几何细节也丢了。更麻烦的是可通行性往往靠人定的语义类别近似(基本就等于"是路就行"),而开放户外里能走的远不止路:人行道、林间小径、广场、沙滩……路为中心的先验在结构化场景够用,一到开放环境就漏。
第二道坎:执行时怎么靠得住。激光里程计(FAST-LIO2 这类)频率高、短时准,但没有全局位姿,长距离必然漂移——论文实测 285 米路线上纯激光里程计的平均误差达到 24.1 米;GPS 又常常不可靠。全局路径画得再好,机器人不知道自己在地图的哪儿,一切白搭。
03 核心方法:把规划变成"画画"
PathPainter 的做法是:在 BEV 图上用绿色五角星标出机器人当前位置,连同自然语言指令一起喂给图像生成模型,让它做两件事——推断目标位置并画上标记;把可通行区域涂成黄色掩码。掩码不只覆盖看得见的路:被树冠遮挡但语义上连续的路要接上,人踩出来的小径要认出来,广场、斑马线、人行桥统统算能走。这一步的本质,是把原始视觉输入映射成一张"可导航空间"的表示。
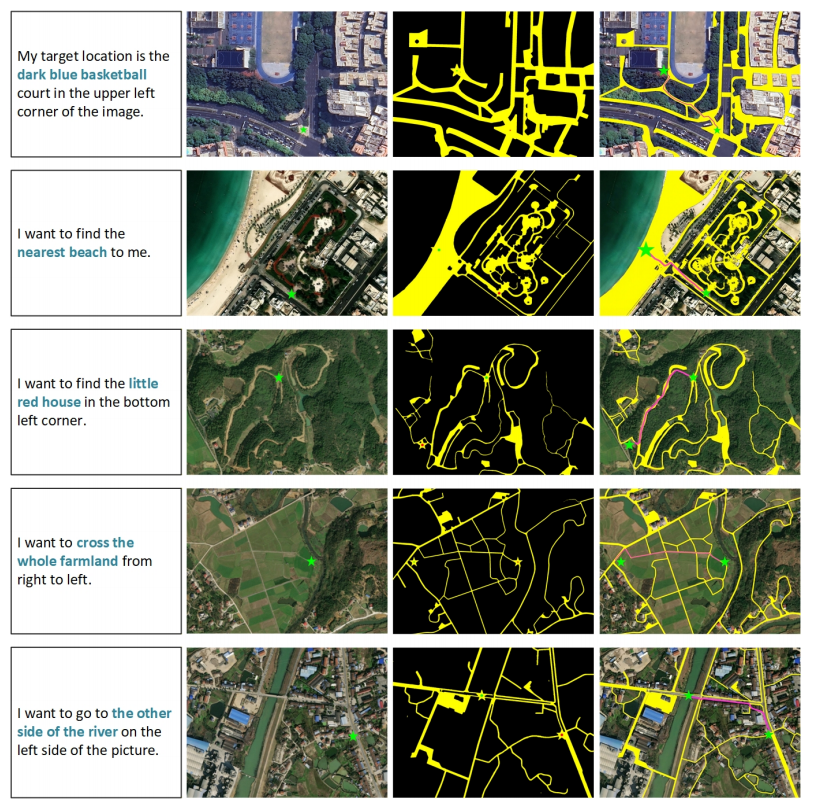
图 3|PathPainter 工作流:指令 → 标当前位置的原图 → 生成的可通行掩码 → 叠加目标与 A* 路径的最终结果(图源:论文原文 Figure 3)
拿到掩码后就是熟悉的 A*,外加一个小技巧:加一项边界距离惩罚,让路径偏向离可通行区边界远的地方,自然贴着路中心走。
名词小课堂:BEV(鸟瞰图)
从空中或卫星视角俯拍的、经过正射校正的平面图像,像素处处等比例、可以直接当"地图"用。它给机器人提供了地面视角永远看不到的全局结构——路的拓扑、障碍的布局、目的地的方位。
04 关键工程:给生成模型的幻觉上一道锁
生成模型会画,也会瞎画——编出一条不存在的路。论文的防线利用了一个巧妙的约束:prompt 要求掩码叠加在原图上输出,于是所有"非掩码"像素都应该和原图一致。逐像素比较 RGB 欧氏距离,平均超过 50 就判定幻觉、触发重新生成。
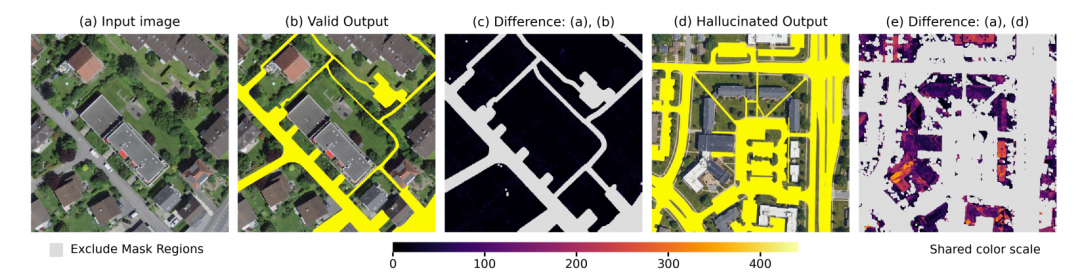
图 4|幻觉检测:(a) 输入 (b) 合格输出 (c) 像素差;(d) 幻觉输出 (e) 其像素差——差异一目了然(图源:论文原文 Figure 4)
在评测基准上,这道防线 100% 检出全部幻觉,14 个严重幻觉案例全部在 2 次重生成内修复。还有一层兜底:如果 A* 在掩码上根本搜不出路,系统并发重生成 5 个掩码,取第一个可行的;全部失败才判定"当前理解下不可达"。
05 执行层:1 Hz 修漂移,10 Hz 走路
真实系统里,跨视角定位模块用 BEV-Patch-PF 把机器人本地特征与 BEV 图匹配,输出全局里程计——但机载算力只够 1 Hz,于是它只干一件事:周期性地修正漂移、更新局部目标。
高频部分全部交给经典管线:FAST-LIO2 以 200 Hz 融合激光与 IMU,局部规划器以 10 Hz 实时避障和跟踪。平台是四旋翼无人机(锁定 1 米高度)与四足机器人,各配 RealSense D455 + Livox Mid-360 + Orin NX(16 GB);BEV 底图来自一架大疆 Neo 高空航拍,经 WebODM 拼成带尺度信息的正射影像。
名词小课堂:跨视角定位
机器人低头看到的地面画面和俯视地图长得完全不一样,怎么知道自己在地图的哪儿?跨视角定位把地面 RGB-D 重建出的局部特征,与 BEV 图的特征嵌入做匹配,恢复机器人在地图坐标系下的位姿——相当于"不靠 GPS 的自报家门"。
06 基准:零样本对比,生成模型赢在"域外"
先看可通行性的基本功。在 DeepGlobe、UAVid、VDD 三个航拍数据集上做零样本可见路分割,所有方法不训练、不微调、不人工修:
方法
DeepGlobe IoU / F1
UAVid IoU / F1
VDD IoU / F1
耗时 (s)
GPT(图像生成)
0.373 / 0.544
0.501 / 0.667
0.392 / 0.563
70.69
Gemini(图像生成)
0.484 / 0.652
0.698 / 0.822
0.607 / 0.755
30.10
SAM 3.1(分割)
0.367 / 0.536
0.698 / 0.822
0.666 / 0.800
0.17
Text2Seg(分割)
0.040 / 0.077
0.363 / 0.533
0.210 / 0.347
0.46
格局很清楚:生成模型召回高(Gemini 在 UAVid 上召回 0.834,几乎不漏路),SAM 3.1 精度高、快三个量级但保守——只标看得见的像素,被树冠挡住的路面全丢。而导航要的恰恰是"连通"。
再看真正要紧的下游路径规划。在 2048×2048 的航拍图上每张随机采样 1,000 组起终点,所有方法输出统一转成二值可通行掩码、交给同一个 A*:
方法
域内 成功 / 有效 / 长度比
域外 成功 / 有效 / 长度比
耗时 (s)
Gemini(先验 + 搜索)
0.902 / 0.932 / 1.007
0.766 / 0.904 / 1.071
61.60
Gemini-Direct(直接画路)
0.280 / 0.910 / 1.242
0.293 / 0.828 / 1.038
86.58
SAMRoad
0.853 / 0.994 / 1.095
0.339 / 0.975 / 1.164
9.34
RNGDet++
0.972 / 0.969 / 1.005
0.252 / 0.949 / 1.148
39.95
SAM 3.1
0.018 / 0.016 / 0.829
0.042 / 0.040 / 0.887
0.27
这组数字是全文最有说服力的一张表。专门的路网提取模型域内极强——RNGDet++ 成功率 0.972,换到分布外的 Global-Scale 数据立刻崩到 0.252,掩码碎成几段,A* 根本搜不过去。生成模型域内略逊(0.902),域外却稳稳保持 0.766——泛化能力是买来的,不是练出来的。它偶尔会走"图上没标但看起来是路"的区域,有效率高折让,但保住了连通性。
另一个关键消融是 Gemini-Direct:让模型跳过掩码、直接画出从起点到终点的路。成功率立刻从 0.902 掉到 0.280——模型爱抄近道,直接横穿不可通行区域。结论:先画"哪里都能走"的完整先验、再交给 A* 搜索,远比让它一次画完路径可靠。
07 真机:285 米,十次连续,九次成功
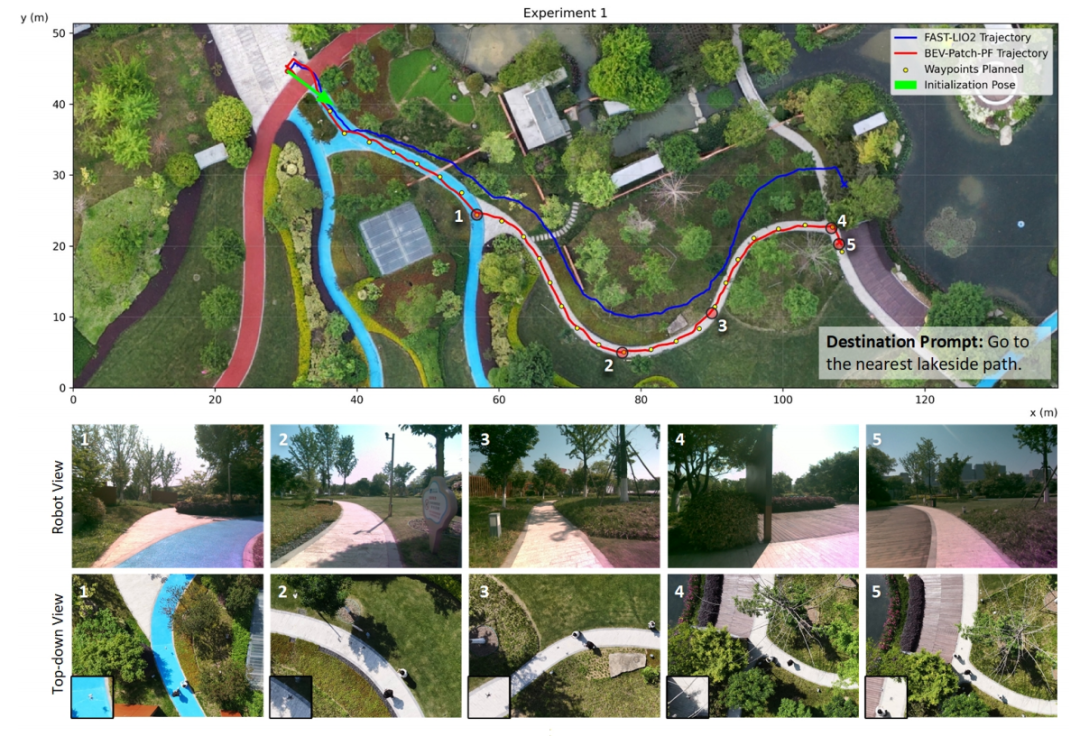
图 5|实验一:无人机在商业地图上没有标注步道的城市公园导航——FAST-LIO2 单独用会漂,跨视角定位持续纠偏(图源:论文原文 Figure 7)
三个真机实验各有看点。实验一选在商业地图里根本没有步道标注的城市公园——必须在线理解环境。实验二最漂亮:树冠把路遮得严严实实,生成模型凭全局上下文推断出被遮挡的连续道路;甚至把一条人踩出来的小径也认了出来并纳入规划。实验三在城市路口,规划出的轨迹避开了车行道,体现出对交通语义的感知。
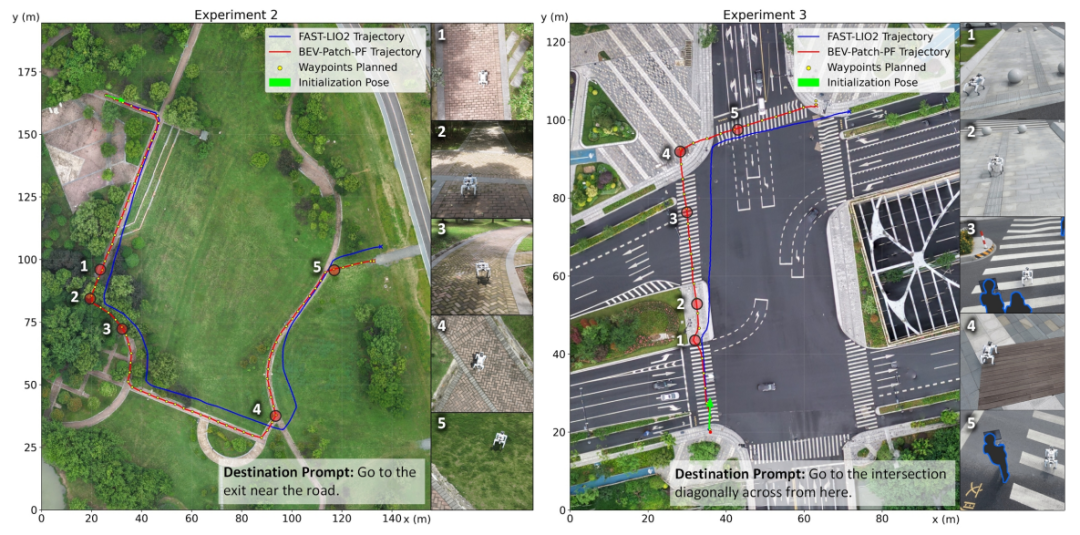
图 6|实验二 / 三:四足机器人在公园(树冠遮挡路段)与城市街区(路口)的长距离导航(图源:论文原文 Figure 8)
90%
0.901 m
0.852 m
24.132 m
10 次连续自主成功
相对 RTK 平均跟踪误差
跨视角定位平均误差
纯激光里程计误差
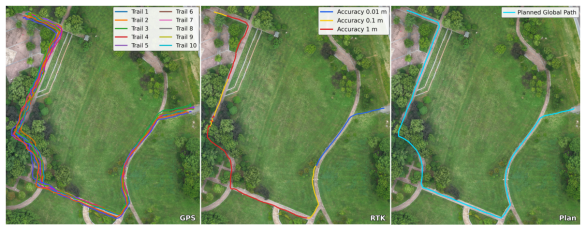
图 7|定量结果:10 次自主实验的 GPS 轨迹、单次 RTK 高精度轨迹与规划全局路径(图源:论文原文 Figure 9)
给四足装上 RTK 接收机后,论文沿 285 米路线连做了 10 次自主实验:9 次无人工干预、无碰撞完成,唯一一次失败源于定位偏差把机器人带离了目标。三类定位的误差对比很说明问题:跨视角定位平均 0.852 米、GPS 1.253 米、纯激光里程计 24.132 米——长距离导航里,"看得见地图"的定位赢过了卫星,也远胜会漂的里程计。
08 冷静看:三处没绕开的限制
作者自己在限制一节写得很诚实。其一,局部规划器不懂语义:它只做几何避障和轨迹跟踪,BEV 层面几米的偏差就会让机器人偏离路面——论文已经在设想用路径条件化的 VLA 策略替换或增强这一层。其二,依赖高质量底图:需要地理配准准确的正射影像和可用的跨视角定位,航拍图过时或错位就会掉链子。其三,幻觉无法根除:像素差检测只是工程锁,模型仍可能编出几何上不自洽的路——多采样一致性检查、可通行性验证和闭环重规划是下一步。
还有一个藏在附录里的工程洞察:prompt 的限制条款是一笔权衡——加上大量"Do not"能压住幻觉,但删掉它们会立刻过分割(把车道、树林都涂成可走)。最实用的配置是保留限制条款,把兜底交给 A*:搜不出路就重生成。
09 结语:分工,而不是全栈
这篇文章最动人的地方不是某个数字,而是它对"机器人该自己理解世界吗"给出了一种省力的答案:不训导航模型、不做任务微调,把理解整个外包给现成的生成模型,机器人只保留一层久经考验的经典控制。高层在云端想得深,低层在机载跑得稳——这是一次教科书式的分工。
基础模型的泛化能力不必通过微调转移——把任务重构成它本来就擅长的形式,能力自己就迁移过来了。
—— PathPainter 给所有具身任务的启示
资源速递
论文与开源信息
论文
PathPainter: Transferring the Generalization Ability of Image Generation Models to Embodied Navigation
出处
CoRL 2026(Austin, TX)
编号
arXiv:2605.07496
代码
论文承诺代码与数据将于发表后开源
10 核心要点一图流
维度
关键结论
问题重构
目标推断与可通行性估计统一成图像生成任务,A* 只负责在"画"出来的地图上搜路
零样本泛化
不微调任何导航模型;域外路径规划成功率 0.766,同期拓扑提取方法仅 0.25–0.34
直接画路不行
跳过掩码直接生成路径(Gemini-Direct)成功率只有 0.280——模型爱抄近道,先验 + 搜索才是正解
幻觉防线
掩码必须叠加原图输出,逐像素比对(阈值 50)检出 100%,14 例幻觉全部 2 次内修复
定位组合拳
1 Hz 跨视角定位修漂移(0.852 m)+ 10 Hz 局部规划,远胜纯激光里程计的 24.132 m
真机成绩
285 m 户外长距离,10 次连续自主 9 次成功,平均跟踪误差 0.901 m
—— 完 ——
本文图片均来自论文原文,仅作学术解读用途
原文链接: https://www.leiphone.com/category/private/PN8ly7EPZbsN9fNM.html
