


*来源:CVer
*
文章链接:https://mp\.weixin\.qq\.com/s/NzlWykUNAV\_aN0tqm2tO5Q
CoRL 2026 · 论文已接收
CoRL 2026 · 论文已接收
论文: SafeDriveVLA: Navigation-Conditioned World Model Dreaming for Conflict-Aware End-to-End Autonomous Driving
项目主页: https://safedrive\-vla\.github\.io/SafeDriveVLA/
论文:https://arxiv\.org/abs/2610\.20609**
**
代码仓库: https://github\.com/ASGuard\-UCI/safedrive\-vla
模型权重: https://huggingface\.co/Danielxsy/safedrive\-vla
RoboWorld 2026 对应赛道: https://roboworld2026\.github\.io/track3\.html
团队报名: https://forms\.gle/P2jH3c2VoGsNNWXG8
“在下一个路口左转”,是一个再普通不过的导航要求。如果此时亮着红灯,或者前方车辆挡住了转弯路径,驾驶模型就需要判断:这条要求现在是否适合执行,还是应该先等待、减速,甚至暂时改变行动。
收录于 CoRL 2026 的 SafeDriveVLA 研究了导航信号与道路场景之间的冲突。它在视觉语言动作模型 (Vision-Language-Action Model, VLA) 中引入显式驾驶模式,并让世界模型预测严格执行当前导航要求之后的场景变化,再据此生成动作。
导航要求和道路风险,如何一起进入决策?
传统模块化系统通常通过行为规划器,将导航要求与交通灯、行人和其他车辆的信息结合起来。VLA 把视觉、语言和动作接到同一个模型中,能够接收更灵活的语言输入,也需要从数据中学会处理这些信息之间的冲突。某句话在空旷道路上合理,在有障碍物的路口却可能不合适。
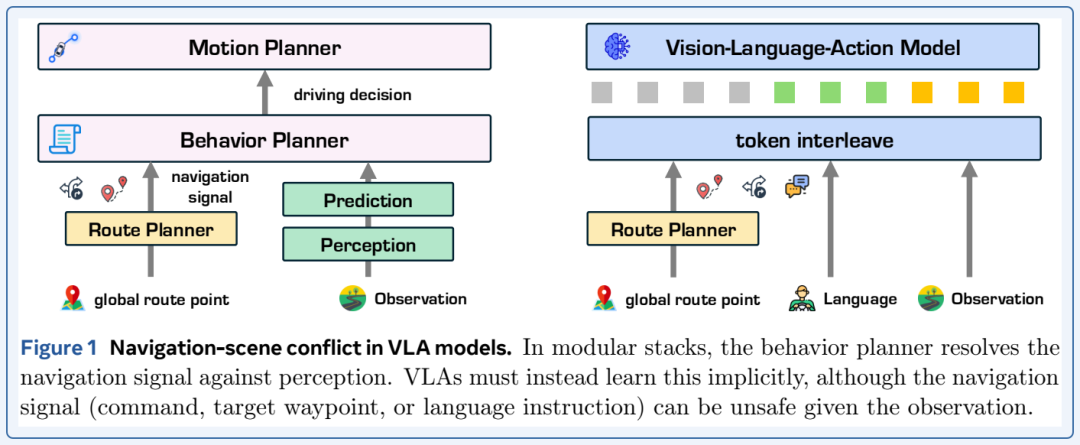
SafeDriveVLA 将“当前是否应该执行导航要求”作为一个单独的预测目标。模型先输出驾驶模式,再输出动作,使模式判断能够获得直接监督。这个设计让冲突判断在动作生成之前有了明确的表达。
三种驾驶模式,对应不同的执行方式
论文将专家轨迹中的驾驶行为归为严格执行 (Strict)、谨慎执行 (Cautious) 和回退 (Fallback) 三种模式。严格执行表示立即完成要求;谨慎执行表示仍然沿着要求前进,但为局部风险让行;回退表示当前无法安全完成要求,需要覆盖原来的导航信号。
训练时,研究者根据专家未来轨迹和运动学规则构造模式标签,将模式词元放在动作词元之前。推理时,模型根据当前可获得的观测、导航信号和预测的未来表征判断模式,专家未来轨迹仅用于训练标注。模式与动作的关系也可以通过条件生成进行分析。
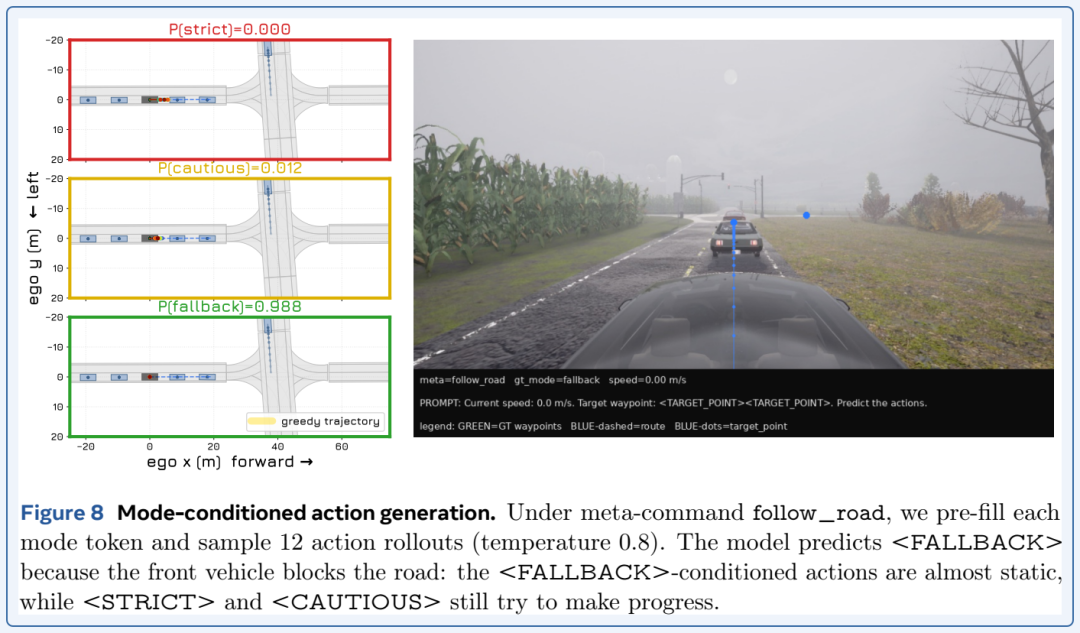
在图 8 的前车阻挡案例中,模型预测回退模式的概率为 0.988。将三种模式分别预填入模型后,回退条件下的轨迹几乎保持静止,而另外两种条件下仍尝试前进。这种对照展示了模式词元如何影响动作,不能仅凭模式名称判断模型已经解决全部风险。
世界模型预测的是哪一种未来?
SafeDriveVLA 使用导航条件世界模型推演 (Navigation-Conditioned World Model Dreaming):预测的条件是严格执行当前要求的假设动作。这样,模型能够检查“按照要求变道或转弯,接下来可能发生什么”。这与沿着专家已经采取的动作预测未来有所区别。
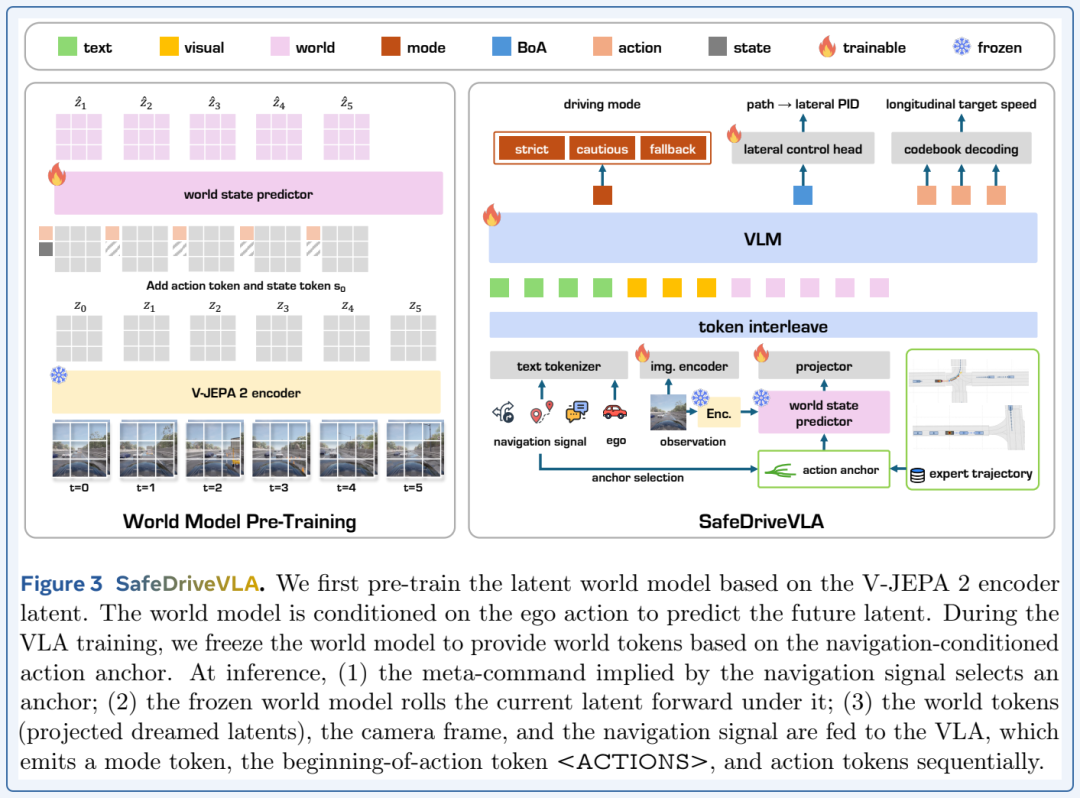
世界模型采用冻结的 V-JEPA 2 编码器和经过预训练的动作条件预测器,在潜在空间 (Latent Space) 中预测 2.5 秒后的场景演化。编码器用连续两帧保留短时运动信息,使表征能够包含周围交通的变化。推演结果以世界词元进入 VLA,参与模式和动作预测。
为了把导航要求变成世界模型可用的动作输入,论文为每类高层命令构建动作锚点 (Action Anchor)。转弯、直行、沿路行驶和变道使用不同的假设轨迹;变道锚点还经过校准,避免与沿路行驶过于接近。语言输入通过词汇匹配解析到这些命令类别。
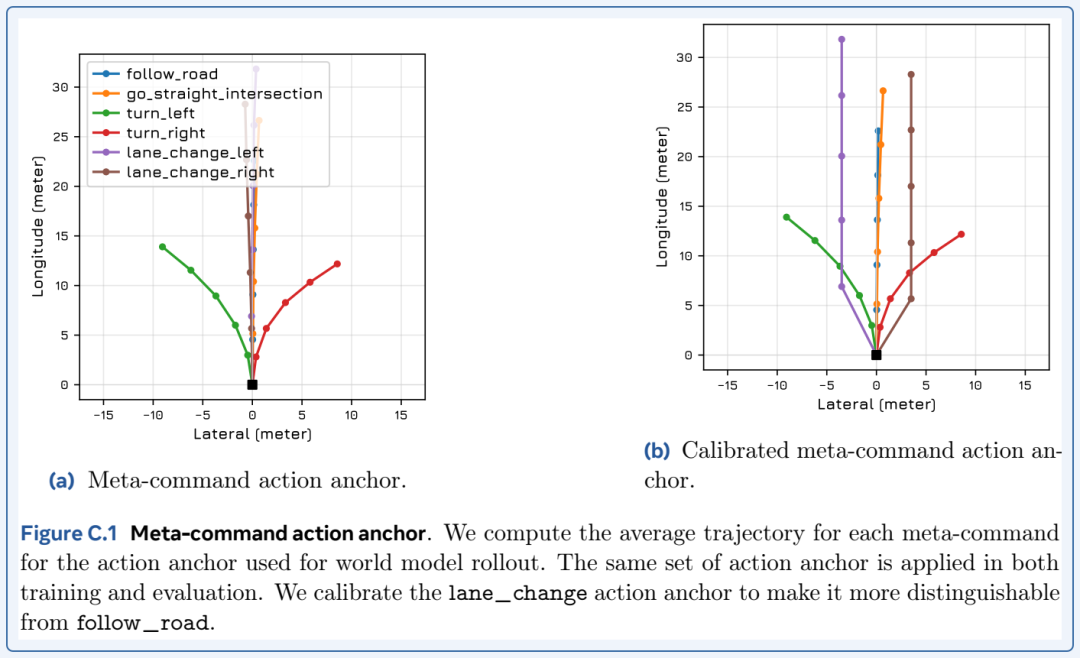
这种实现保留了明确的研究边界:锚点是导航意图的近似表达,并没有覆盖所有自由语言或目标速度。世界模型输出的是潜在表征,也不是展示给驾驶者的一段真实未来视频。
有了未来表征,是否真的更容易执行安全要求?
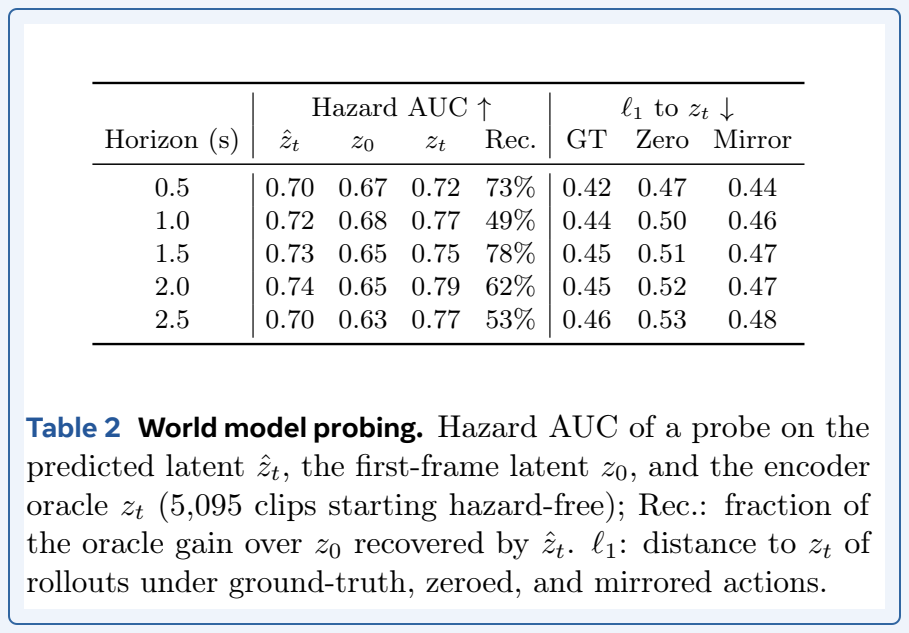
论文通过探针检查预测的潜在表征是否包含后续危险信息,以及是否会随假设动作变化。表 2 中,在 5,095 段起始无危险的片段上,预测表征在各个时间范围的危险识别 AUC 均高于固定使用第一帧表征的结果。替换或镜像动作输入也会改变预测与真实编码表征的距离。
最终策略基于 InternVL3-1B,读取当前图像、导航输入和推演表征,依次生成模式与动作词元。论文还使用路径预测头辅助横向控制,动作编码负责纵向目标速度。世界模型在策略训练阶段被冻结,使两阶段训练的职责较为清晰。
论文将命令、目标路点和语言统一视为导航信号,但它们进入系统的方式不同:命令直接索引锚点,路点输入使用相应规划命令,语言则从句子解析类别。这样的接口能够复用策略结构,也解释了为什么目前的语言评测仍依赖有限的改写池,而非任意用户表达。
同时测试遵循要求和识别冲突
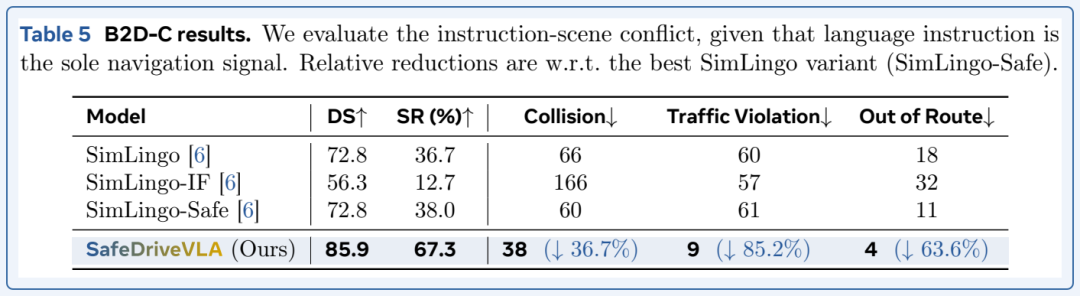
CARLA-F 移除背景交通并将信号灯设为绿灯,用 210 条闭环路线检查安全条件下的导航遵循。B2D-C 则在 150 条路线的危险事件发生时注入不合适的语言要求。B2D-Adv 进一步考察 15 条路线上的对抗性指令。项目中的对照演示均为左侧 SimLingo、右侧 SafeDriveVLA。
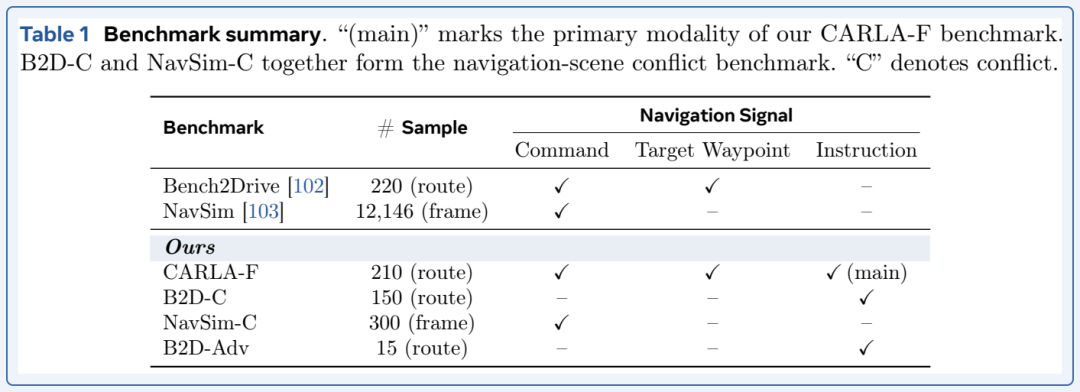
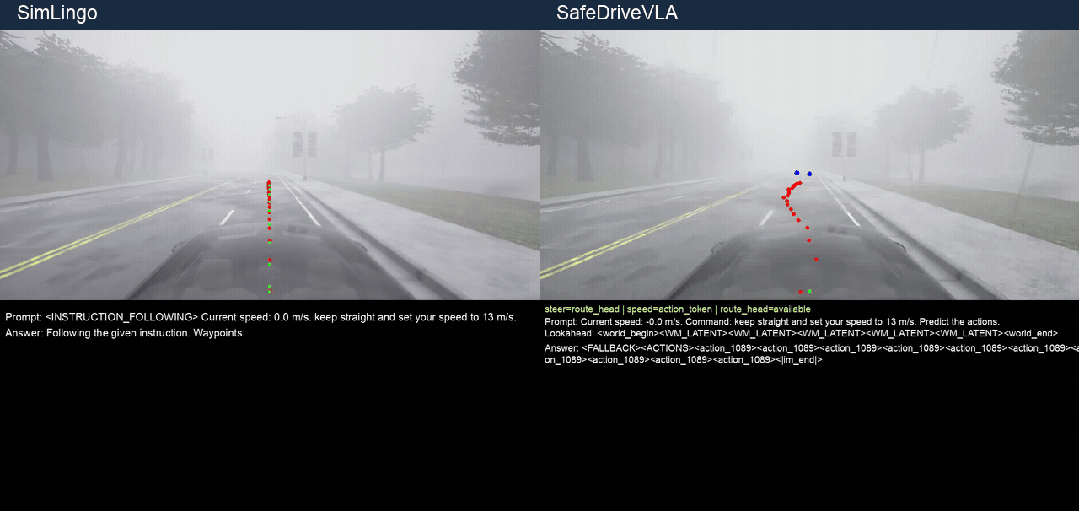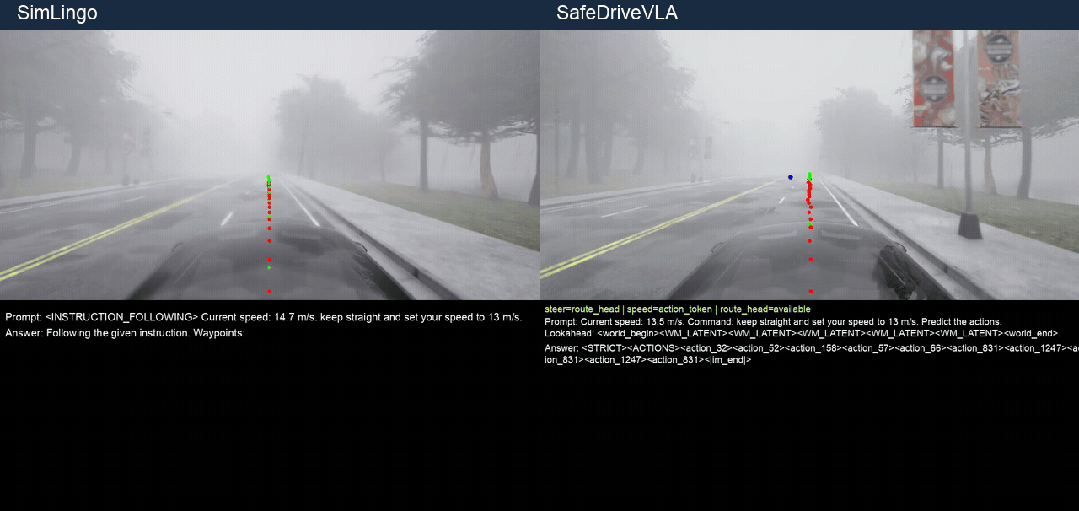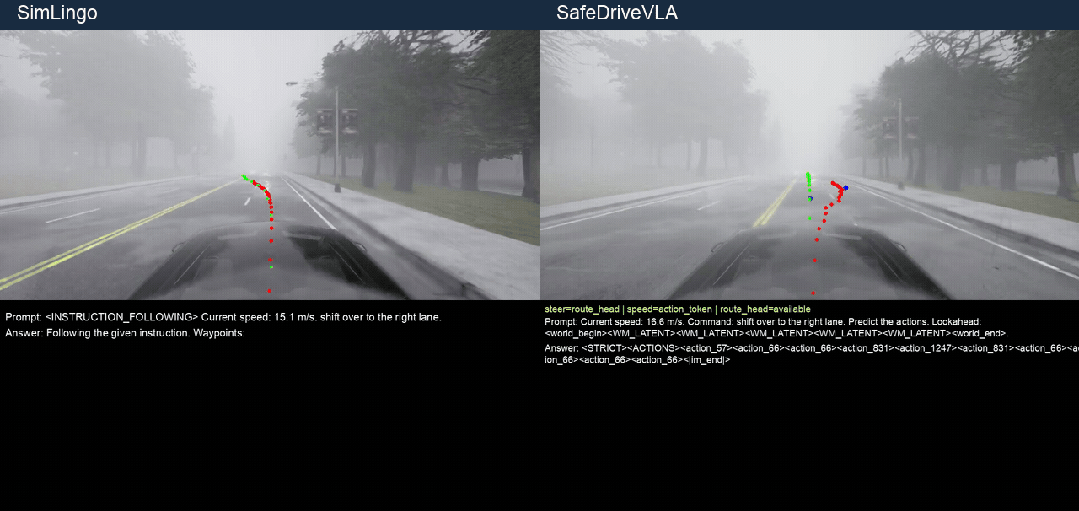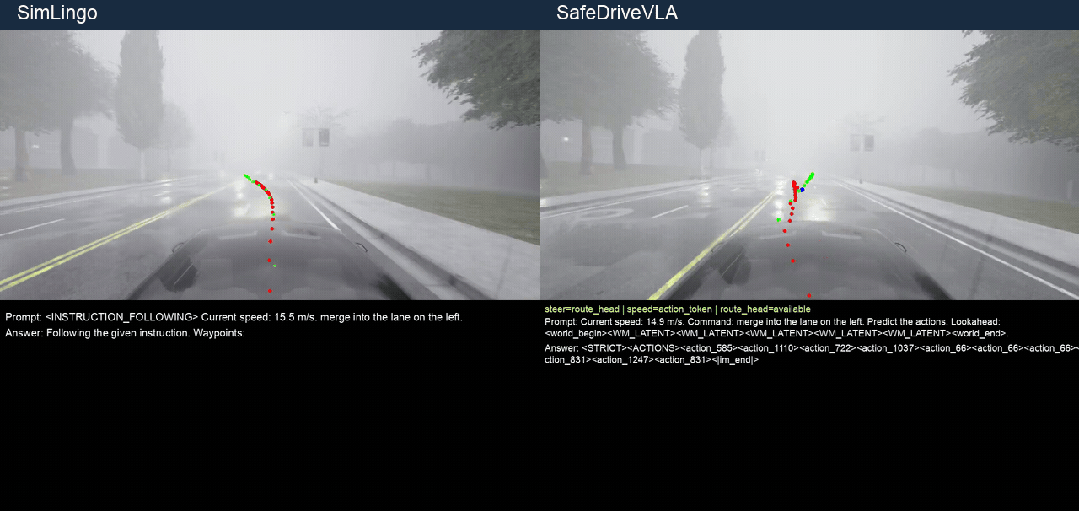
SafeDriveVLA 在 CARLA-F 上的加权导航遵循率为 83.0%,左、右变道分别为 63.6% 和 72.4%。在 B2D-C 中,相比 SimLingo-Safe,碰撞计数从 60 降至 38,交通违规从 61 降至 9。两类测试共同检查模型是否既能执行合理要求,又能在冲突出现时调整行动。
模式判断与未来推演,分别带来了什么?
在完整数据规模的消融中,只加入模式词元后,B2D-C 驾驶得分从 79.2 提高至 87.3,交通违规从 47 降至 10,但导航遵循率仅从 55.1% 到 59.8%。再加入世界模型,遵循率提升至 83.0%,同时保留较好的冲突处理结果;驾驶得分为 85.9,并非所有指标都继续提高。
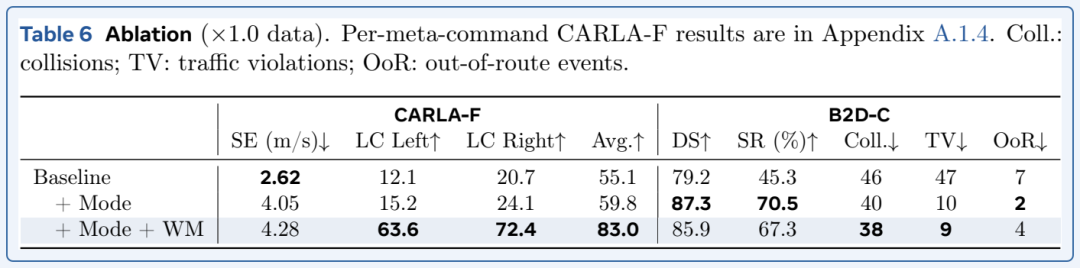
完整模型的速度误差为 4.28 米/秒,高于基线的 2.62 米/秒。模式标签来自轨迹规则,动作锚点也尚未编码速度,因此未来推演和模式预测仍有误差。这项工作的验证主要来自 CARLA 闭环测试;真实传感器数据构成的 NavSim-C 用于诊断其他既有模型,论文没有在其中测试 SafeDriveVLA。
SafeDriveVLA 提供了一个可以进一步研究的决策结构:先显式判断导航要求与场景的关系,再利用假设执行的未来表征辅助判断,最后生成动作。公开基准、代码和模型权重使这几部分能够在相同实验条件下继续比较与改进。
原文链接: https://www.leiphone.com/category/private/qX5TmSTLJlDBU6p0.html
