


来源:越疆机器人
文章链接:https://mp\.weixin\.qq\.com/s/JUXV\_hdXIRGQHkE552zIUw
想象一下:
如果你想教一个人叠衣服,最直观的方式是什么?
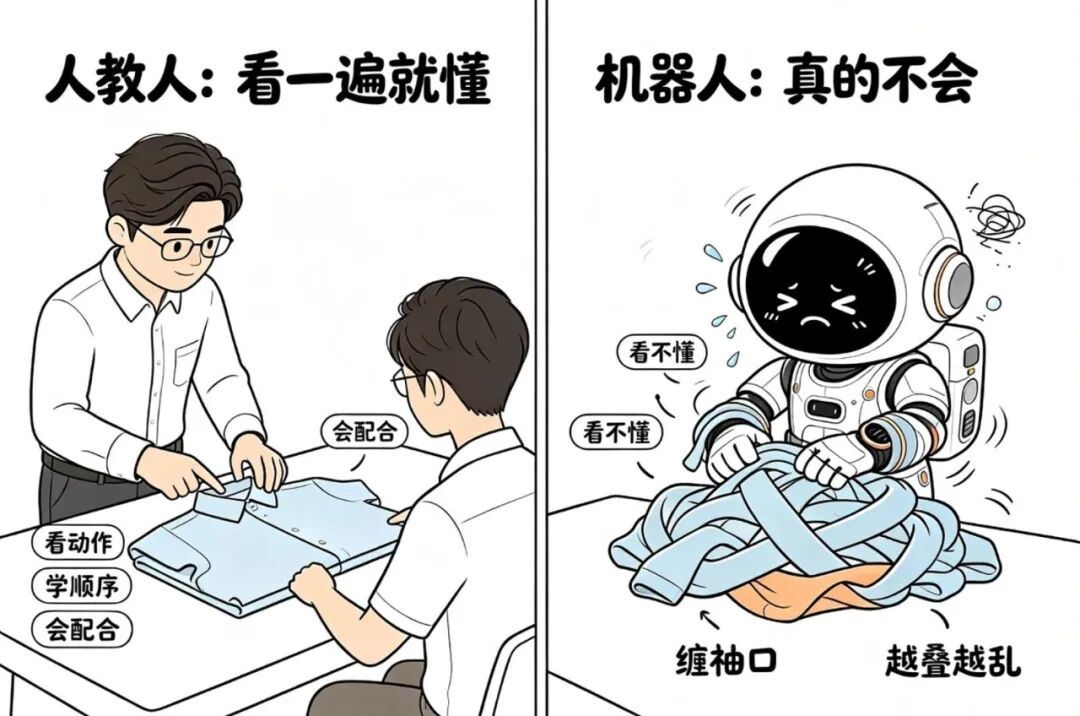
近期,帝国理工学院团队在越疆双臂机器人 X-Trainer 平台上,成功验证了基于上下文的柔性物体操作的范式,并在真实机器人上完成了端到端部署。相关成果发表于论文《Instant-Fold: In-Context Imitation Learning for Deformable Object Manipulation》。
该论文提出了一个叫 Instant-Fold 的系统。一种面向 DOM 的上下文内模仿学习(in-context imitation learning)框架,使机器人无需额外训练或微调,仅通过观看一次演示即可推断操作意图并自主执行,为柔性物体操作迈向“看一次就会”的通用模仿能力迈出了关键一步。
Instant-Fold 的能力建立在两个关键步骤之上。
第一步:让机器人认得出变形后的衣服。
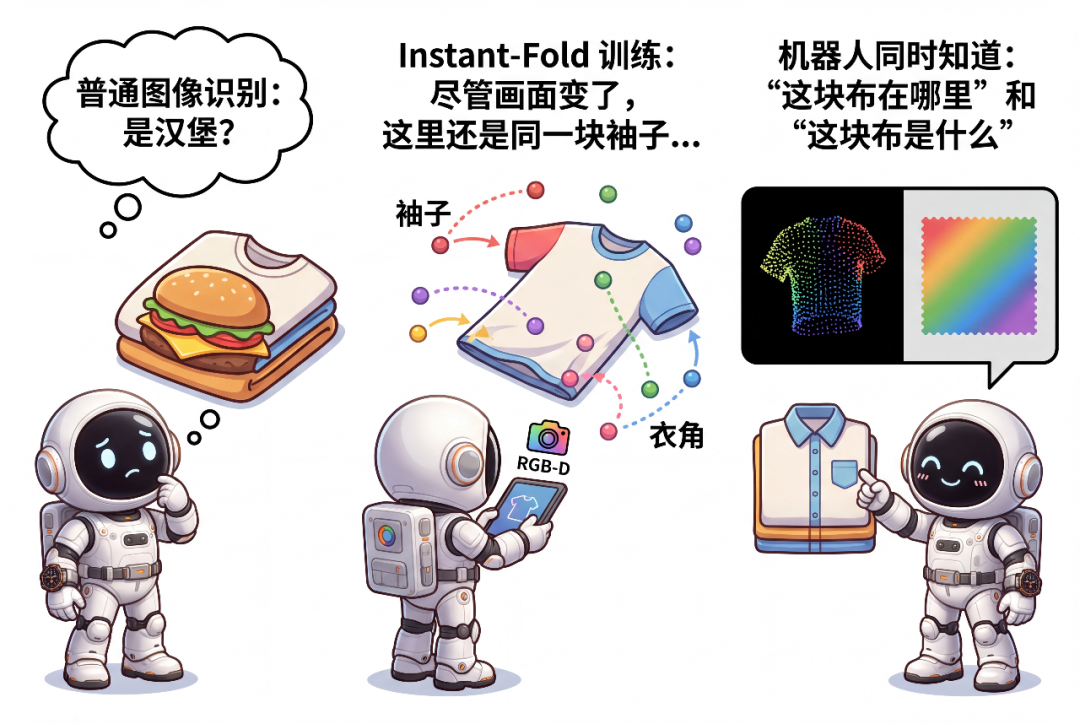
普通图像识别模型看到衣服折起来后,可能会以为这是一件“完全不同的东西”。
Instant-Fold 的做法是:在训练时,让系统反复观察衣服在折叠过程中的变化,并告诉它:“尽管画面变了,这里还是同一块袖子,那边还是同一个衣角”。
系统使用 RGB-D 相机信息,也就是普通颜色图像加上深度信息,把衣服理解成许多带有三维位置的小点。每个小点都同时记录:
它在空间中的位置,它看起来像什么。
简而言之,就是让机器人同时知道“这块布在哪里”和“这块布是什么”。
第二步:看一次示范,理解“这次要怎么叠”。
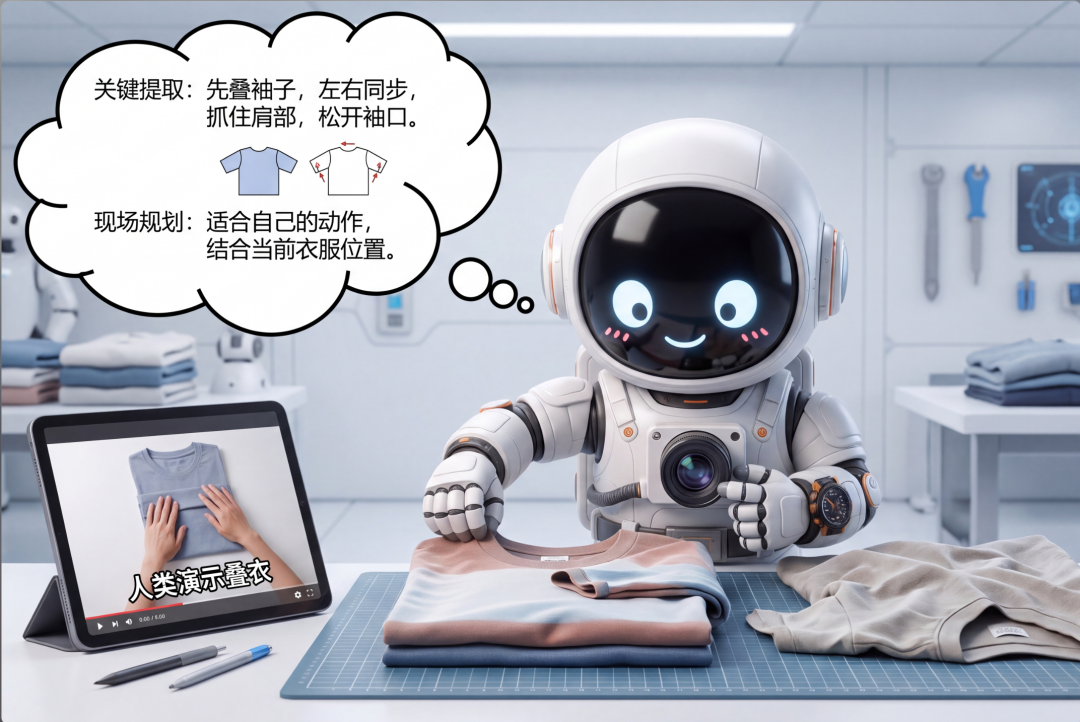
实际使用时,机器人会同时看两样东西:
人类演示的一小段叠衣服过程;
自己眼前这件衣服现在的状态。
它不会机械复制人的手部轨迹。因为人和机器人手臂结构不同,而且眼前衣服也不会和演示中的一模一样。
机器人真正做的是:从示范中提取关键意思,例如:
这次是先叠袖子还是先叠衣身;
左右两侧谁先动;
两只手应该同步还是轮流;
哪个位置该抓住,何时该松开。
之后,它再结合当前衣服的实际位置,现场规划适合自己的动作。
论文把负责“读懂示范”的部分称为 Context Encoder(上下文编码器)。它像一个会做笔记的观察者,把示范中的衣服形状、双手位置、夹爪开合动作和步骤顺序整理成一份“折叠说明书”。
而负责生成动作的部分叫作 Flow-Matching Action Decoder(流匹配动作解码器)。它像一个动作教练:根据这份说明书和当前衣服状态,持续给出双臂下一小段应该怎么移动的建议。
机器人不是一次把整套动作做完,而是“做几步—再看一眼—再决定下一步”,这叫作闭环控制。它使机器人在衣服发生偏移、折得不完全整齐时,有机会及时修正。
在测试能力的时候,团队并未在现实中反复训练机器人,而是在物理模拟器中通过域随机化生成了约12万条包含多样颜色、光照、摆放姿态及褶皱状态的虚拟轨迹,迫使模型学习通用的折叠规律而非死记硬背。
实验表明,
在没有见过的新折叠方式上:
使用语言指令时,条件成功率为 20.2%;
使用人类示范时,条件成功率提升到 42.3%;
加上完整的视觉预训练后,示范方案达到 58.3%。
实验印证了对复杂柔性操作而言,“看”比“听”传递更多信息。
更关键的是,该系统实现了零样本仿真到真实迁移。团队把只在模拟器中训练过的系统,直接放到真实双臂机器人上测试,没有额外收集真实训练数据,也没有再微调模型。机器人面对了 8 类此前没见过的真实衣物,包括衬衫、短裤、上衣、运动夹克和牛仔夹克。
Instant-Fold 的平均成功率为 60.9%,高于论文中比较的其他方法:
ClothFunnels:9.4%
UniFolding:29.7%
UniGarmentManip:26.6%
这意味着,机器人虽然还不算“百战百胜”,但已经能把在模拟世界中学到的能力直接带到现实里,并处理不同类型的真实衣物。
Instant-Fold 的意义远不止自动叠衣服。它展示了一种更符合人类直觉的交互方式:当任务涉及复杂形变、难以用语言精确描述时,“做一次给机器人看”比“说清楚每一步”更高效、更可靠。未来,这一范式有望拓展至整理床单、处理线缆、包装软质材料、装配柔性零件等广泛场景,推动机器人从“执行预设技能”走向“理解人类意图”的通用模仿能力。
原文链接: https://www.leiphone.com/category/private/vCMmm91QjE2DTLeF.html
