


来源:多模态论文每日速递
网站链接:https://mp.weixin.qq.com/s/jF4LR2urolrh8aQVhNYsgw
EmoBench-M:Benchmarking Emotional Intelligence for Multimodal Large Language Models
作者单位:深圳大学,光明实验室,同济大学,澳门大学
项目链接:https://emo-gml.github.io/
01 Background | 从理解内容,到理解情绪
多模态大模型正在进入更加贴近人的交互场景。对于交互式机器人、智能助手等应用而言,仅仅识别画面中的物体、转录用户说的话,还不足以支撑自然的人机交流。模型还需要理解:对方是在开心、担忧,还是压抑着不满?这句话是在询问、鼓励,还是安慰?
情绪智能(Emotional Intelligence,EI)为这些能力提供了研究视角。现实中的情绪表达通常由语言、声音、面部表情与身体动作共同构成,而且会随着对话进程和社会情境发生变化。同一句话,换一种语调或表情,就可能传达完全不同的态度。
因此,评估模型的情绪理解能力,需要走出静态文本和单张图像,进入包含视频、音频与文本的动态场景。EmoBench-M 正是围绕这一需求构建的多模态情绪智能基准。
02 Motivation | 现有评测还缺少什么?
第一,模态覆盖与真实交互之间存在距离。许多既有基准侧重文本或图文任务,难以充分考查语气变化、动态表情及其相互作用。遗漏这些线索,可能让情绪理解退化为对字面内容的判断。
第二,单项情绪识别难以代表完整能力。判断“高兴还是难过”,与理解“为什么这句话带有讽刺意味”,需要不同层次的信息处理。只在某个情绪分类数据集上取得高分,不能说明模型能处理更复杂的对话和社会情境。
第三,评测既要看答案,也要看解释。对于“观众为什么发笑”这样的开放问题,生成文本与参考答案的词面相似度,并不直接代表推理是否合理、是否抓住了关键的多模态线索。
由此,论文提出一个核心问题:能否建立一套有理论依据、覆盖多种场景、兼顾分类与生成任务的评测体系,系统描绘多模态大模型的情绪能力?
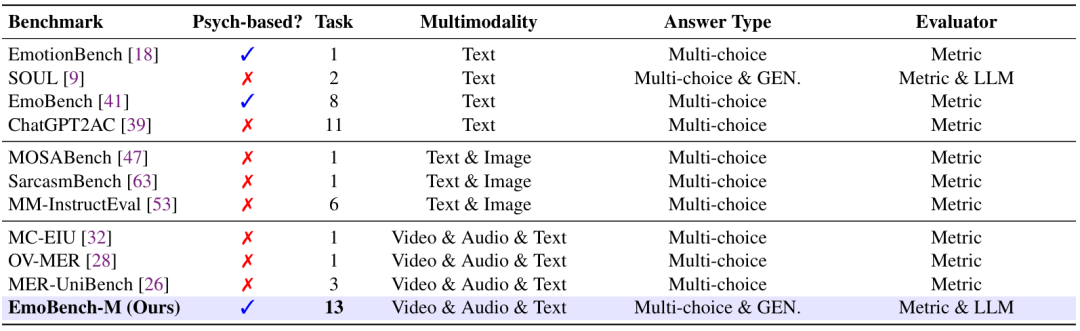
表1:与情绪智能相关的基准测试比较。
03 Contribution | 三层能力、13 个场景、27 个模型
EmoBench-M 的主要贡献可以概括为三个方面。
1. 建立分层评测体系。以既有情绪智能心理学理论为依据,将评测组织为基础情绪识别、对话情绪理解和社会复杂情绪分析三个维度,共覆盖 13 个场景。
2. 构建经过人工复核的多模态测试集。对已有数据源进行筛选、标签复核与类别分布调整,并结合分类指标和生成式评价,形成统一的评测流程。
3. 开展跨模型的系统诊断。在零样本条件下评估 27 个模型,比较通用模型、情绪专用模型及推理增强版本,分析不同任务、模态与模型规模下的能力差异。
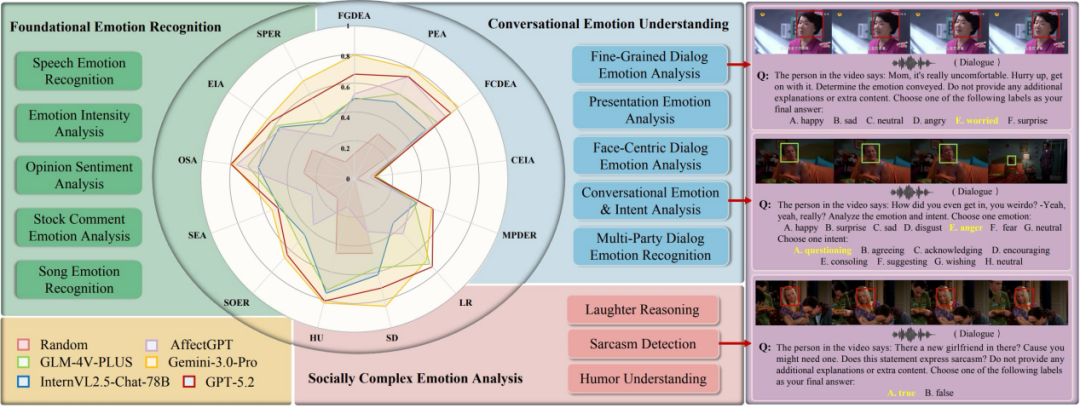
图1:多模态大语言模型情感智能能力评估分类体系
04 Method | 如何给多模态大模型做“情绪测评”?
1. 从识别情绪,到理解社会语境
第一层是 Foundational Emotion Recognition(FER,基础情绪识别)。它关注模型能否从语音、歌曲、视频评论等内容中识别情绪与情感倾向,包括歌曲情绪识别、语音情绪识别、观点情感分析、情绪强度分析和股票评论情绪分析五个场景。
第二层是 Conversational Emotion Understanding(CEU,对话情绪理解)。模型需要结合对话及人物线索理解情绪,覆盖细粒度对话情绪分析、演讲情绪分析、面部中心对话情绪分析、对话情绪与意图分析,以及多方对话情绪识别五个场景。其中,情绪与意图任务要求模型同时回答“对方是什么情绪”和“对方想做什么”。
第三层是 Socially Complex Emotion Analysis(SCEA,社会复杂情绪分析),包含幽默理解、讽刺检测和笑声原因推理三个场景。这里的关键不只是发现情绪信号,还要结合社会语境解释这些信号的含义。例如,模型需要解释一段情景喜剧中观众为什么发笑。
2. 人工复核与类别分布调整
基准的数据来自 RAVDESS、CMU-MOSI、CMU-MOSEI、MER2023、CH-SIMS、MC-EIU、MELD、MUStARD、SMILE 等已有数据源。研究团队安排三位具有情感计算研究经验的研究生,按照统一标准对样本进行复核,通过多数投票形成复核标签,并保留原标签与复核共识一致的样本。对于筛选后超过 500 条的任务,研究进一步从当前样本最多的类别中逐步下采样,将任务规模控制在 500 条,同时缓解类别不平衡。最终,各场景包含 80 至 500 条样本;按论文 Table 2 汇总,共有 5,646 条任务样本。
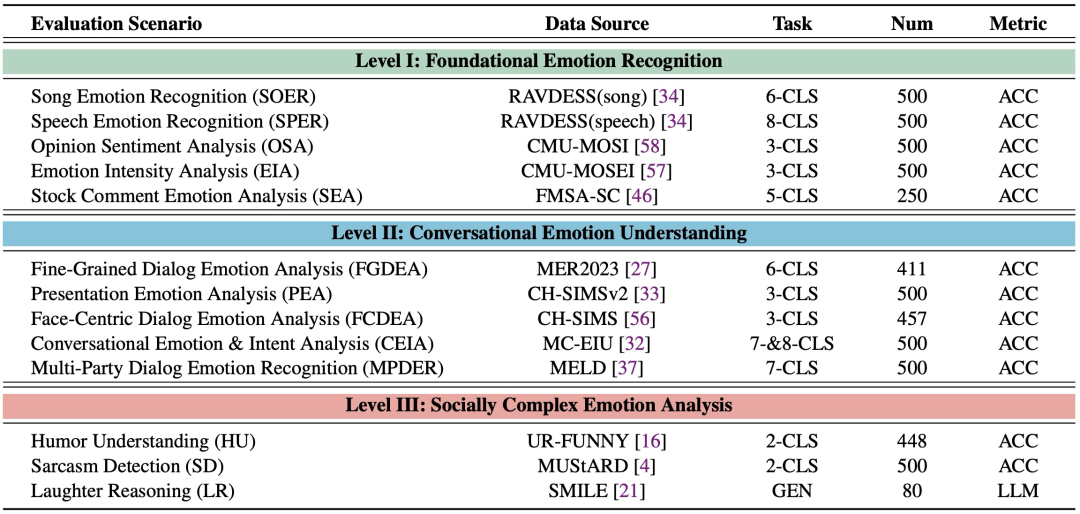
表2:情感识别任务与指标
05 Experiment | 主要实验发现
在 27 个受测模型中,Gemini-3.0-Pro 和 GPT-5.2 的综合分数分别为70.5和66.5。各模型在不同场景中的表现仍存在明显差异。
1.基础情绪识别:语音线索值得重视
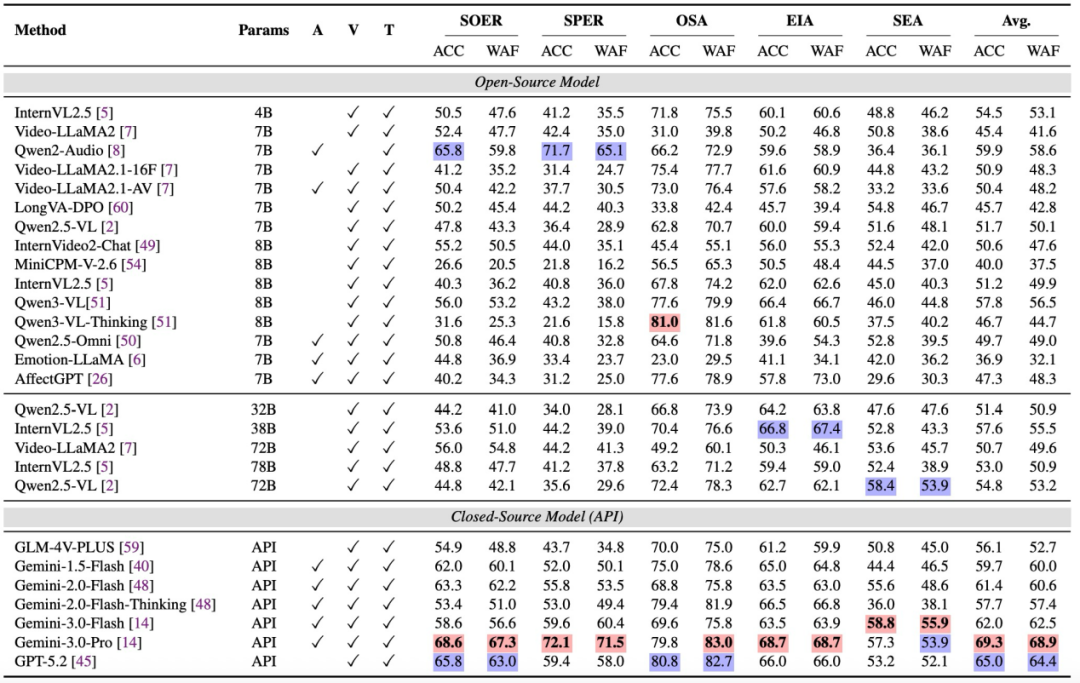
表3:不同方法在 EmoBench-M(基础情绪识别) 上的性能比较。
Gemini-3.0-Pro 的平均准确率为 69.3%。Qwen2-Audio-7B 以 59.9% 在受测开源模型中领先,尤其擅长歌曲和语音情绪识别,提示声音线索对这类任务具有重要价值
2.对话情绪理解:情绪与意图仍是难点
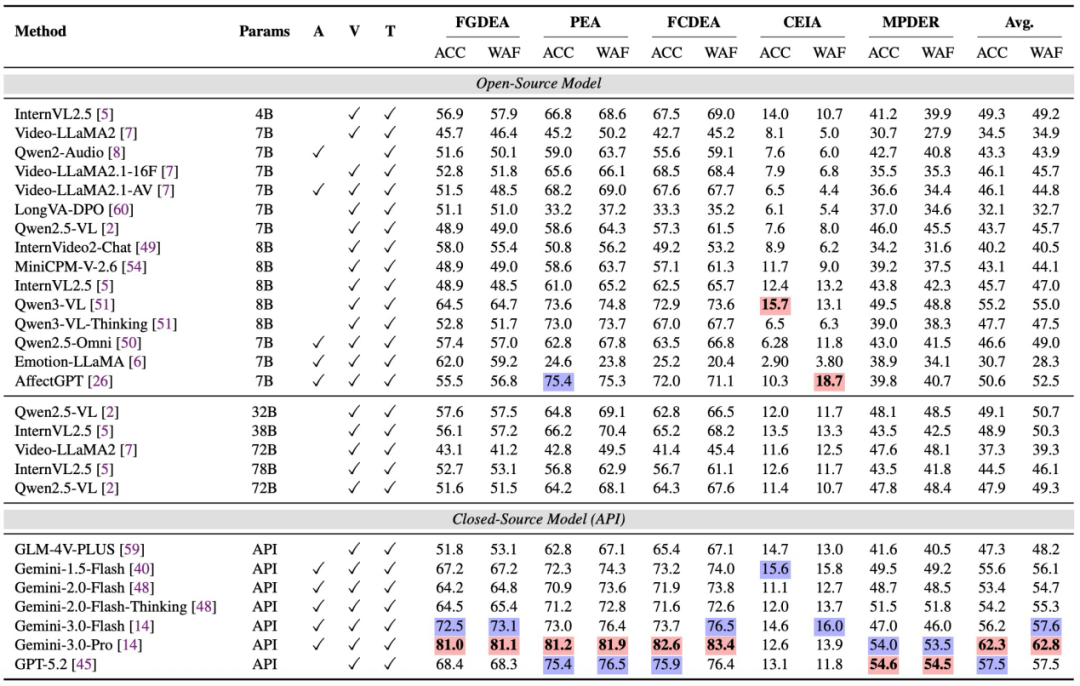
表4:不同方法在 EmoBench-M(对话情绪理解) 上的性能比较。
Gemini-3.0-Pro 的平均准确率为62.3%,但在情绪与意图分析(CEIA)上仅为 12.6%。AffectGPT 在演讲情绪分析等任务中表现较好,但优势未覆盖所有场景,说明对话中的情绪与意图理解仍需加强。
3. 社会复杂情绪分析:识别与解释各有挑战
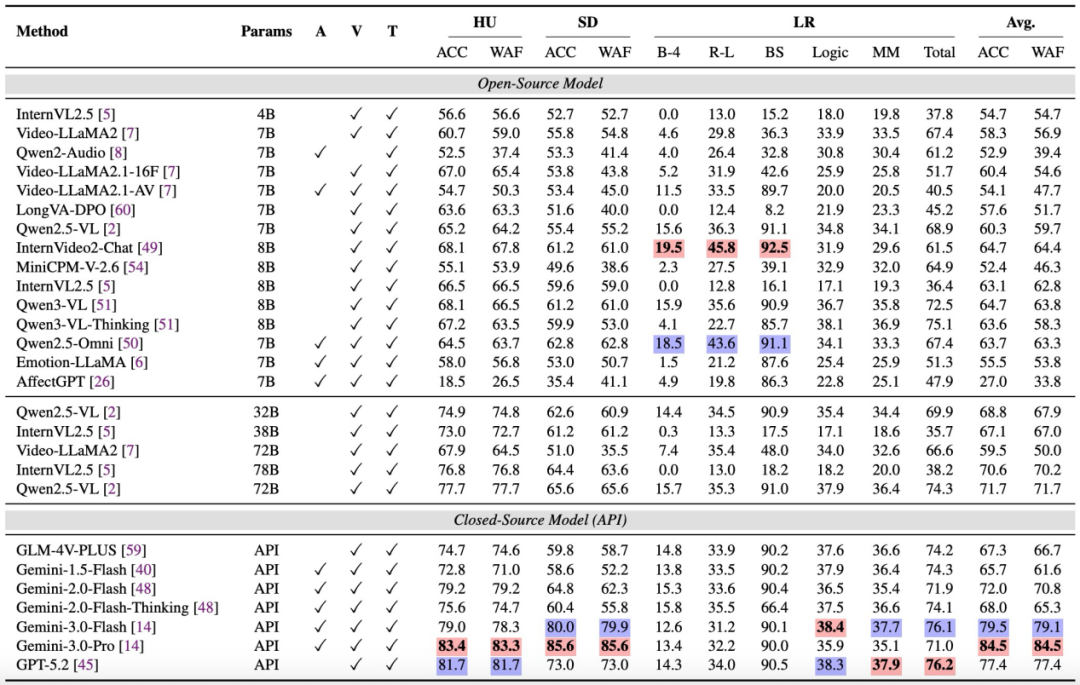
表5:不同方法在 EmoBench-M(社会复杂情绪分析) 上的性能比较。
整体来看,扩大模型规模并不必然带来更好的情绪理解能力:InternVL2.5 的 38B 版本综合得分为 54.4,高于 78B 版本的 52.4。Thinking 版本的优势也具有任务依赖性,例如 Qwen3-VL-8B 的综合得分为 60.1,而 Thinking 版本为 53.9,但后者在笑声原因推理上有所提升。此外,情绪专用训练尚未形成跨场景的稳定优势,AffectGPT 在演讲情绪分析中表现较好,却在幽默理解和讽刺检测中存在短板。这些结果提示,有效的跨模态感知、信息融合与语境理解,仍是提升模型情绪智能的关键方向。
06 Conclusion | 让情绪理解成为可检验的能力
EmoBench-M 将多模态情绪智能拆解为三个维度和 13 个场景,让“模型是否懂情绪”成为可以逐项检验的问题。实验展示了当前模型的进展,也揭示了对话情境理解、细粒度情绪区分和跨场景泛化方面的不足。
走向更自然的人机交互,需要模型把表情、语气和语境联系起来,读懂一句话背后的情绪。EmoBench-M 为衡量这段距离提供了一套统一的评测基准。
