


来源:JOJO极致算法
文章链接:https://mp\.weixin\.qq\.com/s/9PxTNLKMVuDB3cGFkfqtOQ
导读:从大模型感知延伸至机器人自主学习,具身智能正在经历从“理解语义”到“对齐物理法则”的关键跨越。要想让智能体在开放世界中稳定作业,系统亟需跨越三道核心障碍:空间感知中环境边界与拓扑关系的丢失、末端抓取中二维表面接触带来的严重穿模与受力失稳,以及人形机器人全身控制中高保真交互数据的极度匮乏。针对这些横跨三维认知与物理控制的底层瓶颈,本文精选了近期被NeurIPS 2026与CoRL 2026录用的三篇前沿研究,分别来自中科院计算所(SceneScaffold)、英国伯明翰大学与北理工(VolCo),以及诺亦腾机器人联合团队(HiPHI)。三项成果分别在主动空间状态构建、三维体积接触力学与百小时级人形交互基准上取得突破,为具身智能与机器人策略学习筑牢了物理世界的落地底座。
✨
?告别被动压缩:揭示了现有3D视觉大语言模型(3D-LMMs)中因视觉瓶颈被动压缩导致的“模态分工错位”——视觉侧只粗暴筛选出了离散的物体片段,却迫使语言模型在一维序列中吃力地脑补丢失的三维空间关系,导致关系密集型推理频频失误。
?主动构建空间骨架:提出在有限的Token预算下,将视觉瓶颈从“被动特征压缩器”重塑为“主动场景组织者”。在视觉特征进入语言模型前,显式搭建起具备空间结构与角色意识的场景状态骨架。
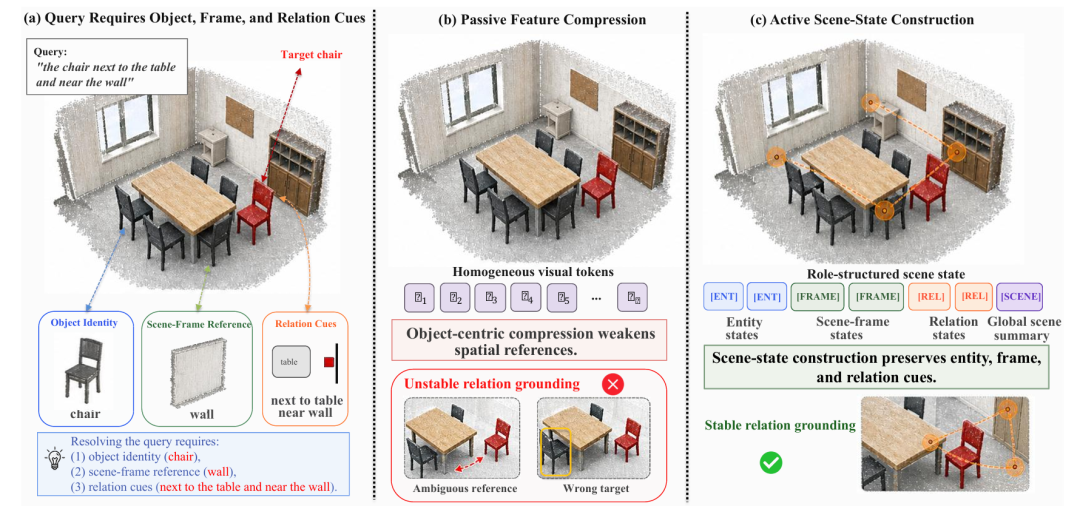
*图1:*SceneScaffold的核心动机与机制。(a)关系密集型空间查询需要物体身份、场景框架与相对关系线索;(b)传统方法被动压缩导致空间参照弱化,大模型容易在同类物体中定位漂移;(c) SceneScaffold在语言推理前主动构建包含实体、场景框架与关系状态的结构化空间骨架,实现稳健的三维空间对齐。
?创新点
?角色化场景状态归纳 (Role-Constrained State Induction):在有限的Token预算内,将点云离散特征主动归纳为“实体语义”、“场景边界框架”与“相对几何关系”三大专用角色块,在输入大模型前构建起立体的空间坐标骨架;同时将这套空间骨架作为下游任务的统一先验,让大模型语言推理与目标空间分割共享一致的三维拓扑认知。
?角色保持正则化:设计轻量级的几何监督机制,分别约束实体语义不丢失、框架对房间边界的视野覆盖,以及关系块对空间方位的表达,防止不同状态发生表征坍缩。
?成果
?空间定位大幅突破:在3D视觉定位基准ScanRefer与Multi3DRefer上,SceneScaffold 分别斩获47.0 mIoU与47.9 mIoU,相较强基准3D-LLaVA显著提升3.7与5.2mIoU,展现了卓越的抗空间漂移能力。
?空间问答与描述全面占优:在考验机器人第一人称空间推理的具身问答基准SQA3D上,模型回答命中率达55.5%(精炼版 58.3%);在三维物体密集描述基准Scan2Cap上,更实现了79.1的高分描述质量(CIDEr@0.5),显著领先现有通用大模型。
?攻克高难歧义子集:在包含多重空间参照与大量同类候选物的高难诊断子集(Rel.+Amb.)上,定位与问答指标均取得显著优势,彻底解决了机器人在复杂布局中“找错同类物体”的痼疾。
✨亮点速览
?首创3D体积接触表征:打破了学术界长期将接触局限在物体表面“2D接触图”的传统假设,首次提出围绕物体表面向外延展的“3D体积接触网格(Volumetric Contact, VolCo)”,将接触采样点从二维表面拓展至三维局部空间。
?摆脱启发式优化陷阱:彻底摒弃了传统测试时自适应(TTA)中基于最近邻查询的非凸穿透损失,通过体积网格内的连续表面嵌入(CSE)与接触概率,能够确定性、高精度地直接反演局部手部几何。
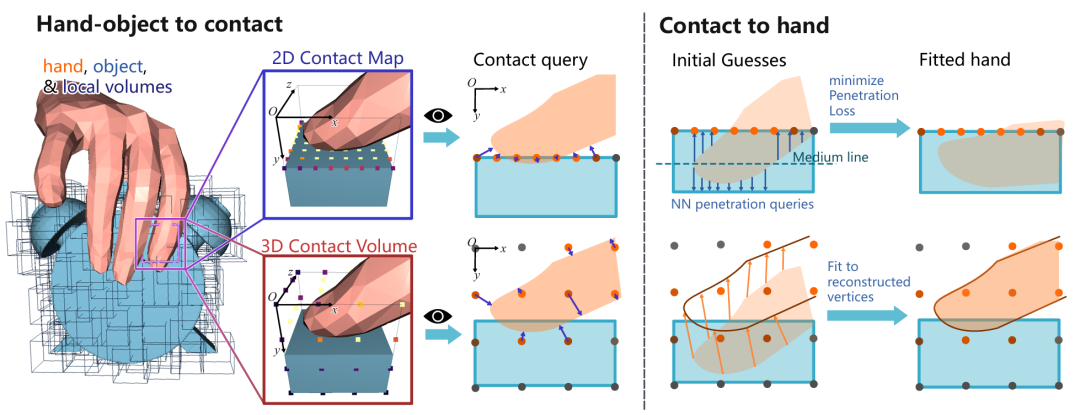
*图2:*2D表面接触图与3D体积接触网格(VolCo)对比。传统的二维接触图(左)仅在物体表面采样,信息严重残缺,不得不依赖脆弱且非凸的最近邻穿透损失;VolCo(右)将采样扩展至物体周围的三维体积网格中,完整保留局部手部几何构型,无需不稳定的穿透损失即可高精度、确定性地恢复真实交互姿态。
?创新点
?体积变分自编码器 (VolumeVAE):利用局部小体积空间形变有限的先验,以局部符号距离场(SDF)为几何条件,采用3D-VAE将密集的体积接触网格压缩为128维潜变量,精准学习一切在物理几何上可行的局部手部贴合构型,从源头杜绝严重穿模。
?手部先验引导扩散:在扩散模型生成接触体积时,并行引入手部运动学先验作为全局约束,确保由微观体积反演出的所有离散接触点,都能被一只符合人体解剖结构的完整手掌自然贴合。
?力学平衡与松弛优化:基于弹簧-阻尼力学模型,显式推导各接触点受力,并创新性地引入容忍测量噪声的松弛变量,在训练中直接对抓取的合外力与合力矩平衡进行可导优化。
?成果
?接触反演精度质变:在利用真实接触反演手部姿态的任务中,姿态反演误差(EPE)大幅下降40.1%(仅为6.33毫米),在5毫米严苛误差阈值内的贴合准确率提升超两成,信息保留完整度断层式领先以往所有表面接触图方案。
?物理仿真稳定抓取:在 GRAB 数据集上的PyBullet刚体动力学仿真中,物体质心位移降低至0.52 cm(优化 14.8%),最大穿透深度仅为0.27 cm(改善 32.5%),有效接触面积达到31.1平方厘米,实现了极紧凑且物理合理的抓握。
?强劲的零样本跨域泛化:在未参与训练的真实物体数据集HO3D上,物体位移降低12.3%,穿透深度优化28.6%,有效接触面积提升18.2%,证明了模型对异形物体尺度的极强适应性。
✨亮点速览
?600+小时级高质量基石:打造了目前具身智能与机器人学习领域规模最大、精度最高的光学动捕基准,全量发布时长达617.5小时(含镜像,原始录制308.7小时)、约2亿帧90Hz亚毫米级精度的全身人体运动。
?语言学脚手架指引数据构建:开创性地将认知语言学框架FrameNet引入动捕采集,摆脱了传统随手编写动作剧本导致的语义混乱与动作冗余,实现了动作空间的系统化、可溯源枚举与扩展。
?打通真机控制闭环:不仅包含245.7小时的高保真刚体人-物交互(HOI)轨迹与CAD网格,更打通了从强化学习物理仿真到宇树(Unitree)G1人形机器人真机部署的全套技术栈。
?创新点
?Frame-LU运动空间衍生流水线:精选与机器人控制紧密相关的22个框架与214个词元单元(LU)作为动作种子,沿速度、路径、转向半径、肢体协调、接触模式与物体负载等物理控制轴进行受控扩展,实现运动流形的高覆盖与低重复。
?同步人-物刚体几何对齐:涵盖12类常用物品、40个真实CAD网格模型。采集过程中全程同步追踪人体骨骼与物体的六自由度空间轨迹,彻底消除了传统动捕中“隔空悬坐”、“虚空推物”等非物理假动作。
?成果
?极致的运动与接触精度:脚部滑动漂移仅为64 mm/s,地面穿透深度仅为8 mm(远优于传统数据集的111 mm);人-物交互非冲突率高达98.1%,彻底消除了传统动捕中“悬空虚坐、隔空推物”等非物理缺陷。
?验证人形控制Scaling规律:在Unitree G1机器人的仿真学习中,首次证实了动捕数据规模的“扩展定律”——随着训练数据从3小时逐步扩充至300小时,机器人的全身关节动作跟踪误差呈现平滑的幂律下降,展现了极强的通用泛化潜力。
?真实硬件复杂技能执行:策略直接部署于Unitree G1人形机器人实物,在面临电机延迟与传感器噪声时依然表现出极高的稳定性,成功完成了跑步、深坐、地面爬行、双手抬箱搬运、动态前滚翻及单手拉行李箱等复杂高动态任务。
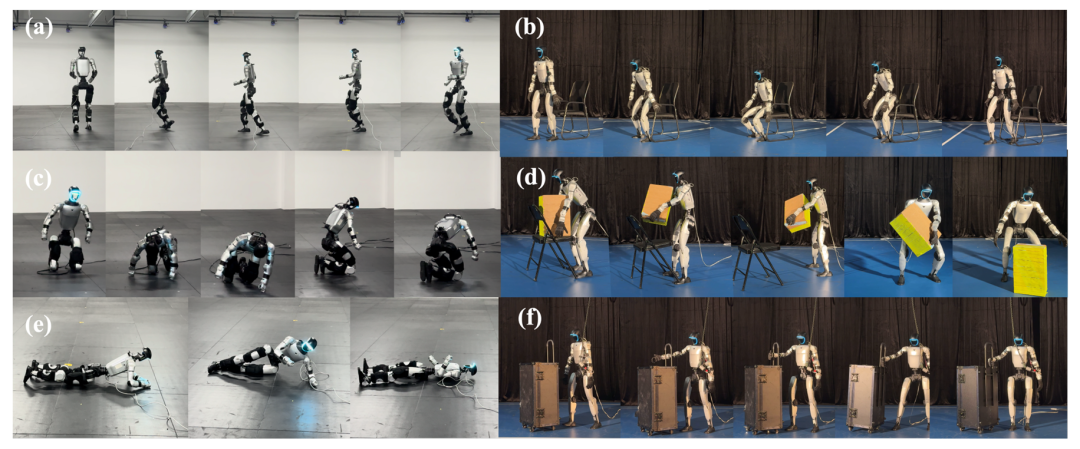
*图3:*HiPHI策略在Unitree G1人形机器人上的真实世界部署。依靠高保真动捕与真实交互数据训练的策略展现出极高的物理可行性与抗扰动能力,人形机器人在真实硬件上流畅完成了跑步、坐地、爬行、双手抬箱搬运、动态翻滚以及单手拖拽重物等多样化复杂技能。
?具身机器人策略学习迈向物理现实
具身智能与机器人策略学习的核心挑战,本质上在于如何让算法穿透表层的拟合,真正理解并遵循物理世界的相互作用机制。纵观这三项研究,前沿探索不再局限于虚拟沙盒中的指标博弈,而是开始在空间拓扑骨架、微观受力接触与全身运动交互等真实作业的底层痛点上协同发力。
这种将结构化空间认知、接触力学约束与大规模动力学先验有机结合的思路,打通了从高层环境理解到底层动作执行之间的逻辑链条。它让智能体开始真正具备察觉空间格局、拿捏操作细节并稳定协调机体的综合能力,也为机器人学习在复杂无序的现实世界中稳健落地奠定了坚实的物理底座。
原文链接: https://www.leiphone.com/category/private/B6D2QVFlEXe0RLiI.html
