


来源:电子科技大学智能计算研究院
原文链接:https://mp.weixin.qq.com/s/--mdskLsbu1aT3BkgV7kCg
2026年7月,国际多媒体领域顶级会议 ACM International Conference on Multimedia(ACM MM 2026)公布论文录用结果,电子科技大学智能计算研究院6篇论文被会议接收。以下为论文录用信息,排名不分先后。
Rectifying Geometric Covariate Shift for Robust Incomplete Multimodal Learning
智能模型研究室工程师戴瑞婷为第一作者,何涛副研究员为通讯作者,电子科技大学为第一单位。
多模态学习通过融合文本、语音和视觉等多源信息,为情感分析、智能交互和多媒体内容理解提供更加全面的语义表示。然而,在实际应用中,模态缺失通常并非随机发生。例如,低照度环境更容易造成视觉信息失效,环境噪声可能选择性破坏语音信号,隐私保护也可能限制特定类型的数据采集。这类与环境条件或语义类别相关的结构化缺失,会使不同类别的样本产生方向和程度各异的表示漂移,进而破坏潜在空间中的类别边界。论文将这一问题概括为几何协变量偏移(Geometric Covariate Shift,GCS),并从理论上证明:当不同类别具有不均衡的模态缺失率时,传统的边缘分布对齐会将不完整样本拉向带有类别偏差的整体分布中心,而非其正确的类别语义中心,从而引发跨类别负迁移。
针对上述问题,论文提出两阶段框架 A-STAR(Adversarial-Semantic Transfer and Adaptive Rectification)。在第一阶段,A-STAR开展宏观几何校正,将不同模态的特征映射到统一的超球面语义空间,并仅利用模态完整样本构建稳定的类别条件原型。在进行完整域与不完整域对抗对齐的同时,模型通过原型约束将不完整样本引导至相应的语义邻域,从而避免整体分布对齐造成类别混叠,恢复潜在空间中的类别紧致性和判别边界。
在第二阶段,A-STAR进一步开展微观特征协同,通过双流结构恢复缺失模态的实例级信息。其中,实例驱动分支从当前可观测模态中提取个性化残差信息,原型驱动分支则从完整样本建立的语义原型库中检索稳定先验。论文根据样本在原型空间中的聚类熵,解析地计算无需额外参数的置信度权重:当样本语义位置清晰时,模型更多保留实例细节;当样本受到严重缺失或噪声干扰时,则更多依赖可靠的原型先验,从而在对齐质量与特征恢复可靠性之间建立自适应联系。
论文在 CMU-MOSI 和 CMU-MOSEI 多模态情感分析数据集上,分别构建了独立同分布随机缺失、类别非对称缺失和噪声诱导缺失等多种评测场景。实验结果表明,A-STAR在不同缺失率和缺失机制下均取得了稳定领先的性能,在极端非独立同分布条件下,二分类准确率相较现有先进方法最高提升 5.43%。同时,该方法采用高效的前馈式特征恢复机制,在保持较低参数量的情况下显著降低推理延迟,展现出良好的鲁棒性、可解释性和实际部署潜力。
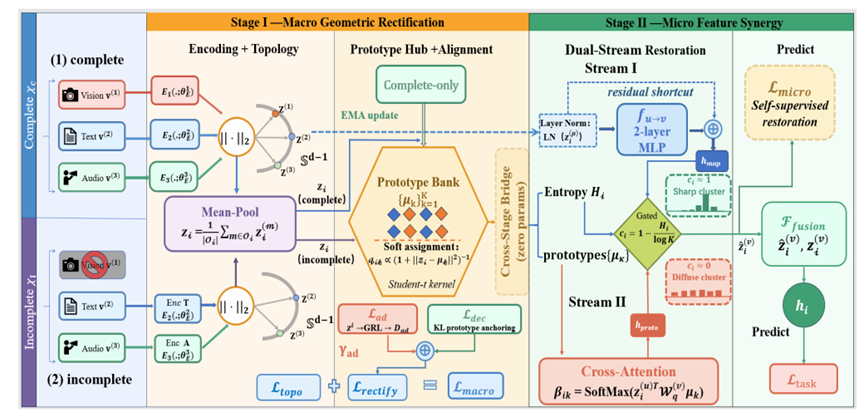
框架整体示意图
What to Remove, What to Preserve: Dual-Ambiguity Rectification for All-in-One Image Restoration
2024级博士研究生刘涔涔为第一作者,通信作者为卢国明研究员,协助指导老师为王洁磊副研究员以及张东阳副研究员,电子科技大学为第一单位。论文ACM MM 2026接受录用为Poster论文。
一体化图像恢复旨在利用统一模型处理多种图像退化类型,以提升模型的泛化能力和实际应用价值。然而,现有方法通常在共享潜在空间中联合编码退化信息与图像内容,导致二者相互耦合,难以准确区分“应去除的退化信息”和“应保留的内容信息”,从而引发内容受损和退化残留等问题。为此,本文提出一种新颖的双重歧义校正网络DAR-Net(Dual-Ambiguity Rectification Network),通过同时缓解通道维和空间维上的退化-内容耦合,实现更加精准的一体化图像复原。具体而言,提出退化原型表示(DAR)模块,通过单纯形约束的原型混合建模构建结构化退化状态,为后续恢复提供可靠的退化先验;进一步设计语义歧义校正(SeAR)模块,利用退化感知提示对解码器进行通道级条件调制,增强不同退化类型的语义判别能力;同时提出空间歧义校正(SpAR)模块,通过正交子空间约束分离退化相关特征与内容相关特征,有效减少去除与保留信息之间的空间干扰。大量实验表明,DAR-Net在三退化、五退化、混合退化及真实天气退化等多个标准基准上均取得了最优或具有竞争力的性能,相比现有最佳方法平均PSNR分别提升0.14 dB和0.34 dB,并在保证较高推理效率的同时展现出优异的泛化能力和恢复质量。
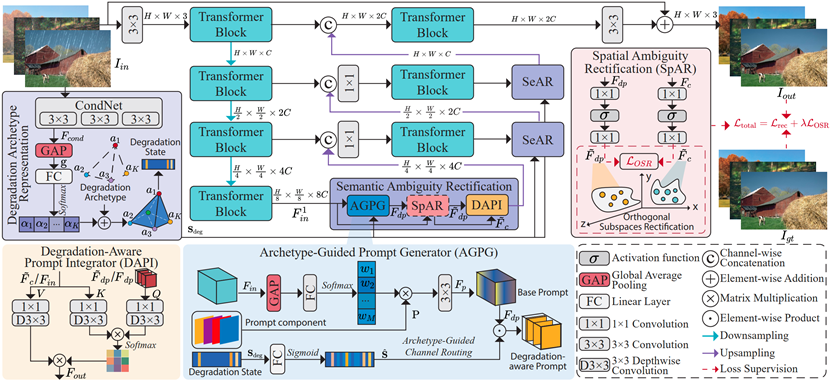
DAR-Net架构图
SPARK: Learning Task-Specific Semantic from Vision-Language Models for Data-Scarce Knowledge Distillation
边缘计算研究室2026级博士研究生程子涵为第一作者,通讯作者为王洁磊副研究员,指导老师为卢国明研究员,电子科技大学为第一单位。
基于视觉语言模型(VLMs)的知识蒸馏为在数据稀缺条件下训练轻量级模型提供了一种有前景的解决方案。然而,大多数现有方法通常假设预训练的大型VLM所习得的知识能够有效地转移到容量受限的轻量化学生模型上。实际上,这些表征往往是高维的且语义上相互纠缠,导致在数据有限的情况下难以进行迁移。
本文提出了一种名为SPARK的两阶段知识蒸馏框架,该框架通过特征空间演化范式明确解决了这一挑战。SPARK并非直接蒸馏原始 VLM表征,而是通过可学习的上下文参数化和一种基于熵的自适应蒸馏机制,首先将教师模型的语义空间重构为紧凑且适合学生的表征。随后,它使学生能够根据自身的视觉特征进一步适应该语义空间,同时通过子空间上的约束来保持文本特征空间的结构。
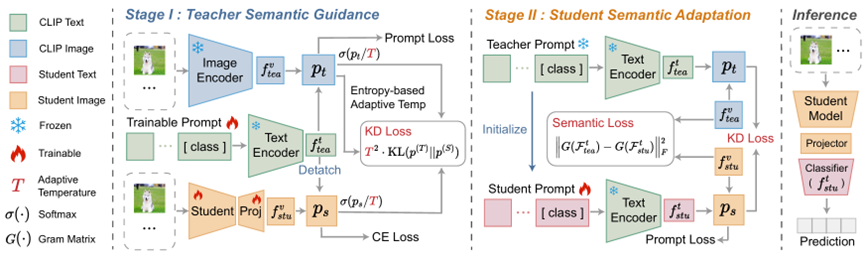
SPARK流程图
本文在包含多种下游任务的九类图像数据集上,采用不同架构的轻量化网络开展对比实验,结果显示相较于未经过蒸馏的原始学生模型,该方法在多种少样本设置下平均识别精度提升15.82%,为数据稀缺条件下大视觉语言模型向边缘小模型高效迁移知识提供了全新可行的技术方案。
Visual Graph Reasoning via Knowledge Compilation
智能模型研究室2024级博士研究生王荣正为第一作者,导师为秦科教授,协助指导老师为梁爽副研究员,梁爽为通讯作者,电子科技大学为第一单位。
视觉图推理旨在让模型直接从图像形式的图结构中完成可达性、环检测、最短路径和最大流等任务。由于拓扑关系、边方向和权重等信息隐藏在节点样式、边样式及布局中,现有视觉语言模型难以稳定恢复完整图结构,容易受视觉风格和图状态变化影响,进而产生识别或推理错误。
针对上述问题,论文从知识编译(Knowledge Compilation)视角提出 VGCompiler 框架,以可执行代码串联图结构恢复与算法执行:表示编译器将视觉图转换为保留拓扑、方向和权重的属性邻接表,操作编译器依据问题意图生成相应图操作。同时,框架通过条件签名检索复用高质量代码,并采用分层奖励目标 LORO 联合优化代码可执行性、图表示质量和操作质量,从而提升跨风格、跨任务的视觉图推理稳定性与准确性。
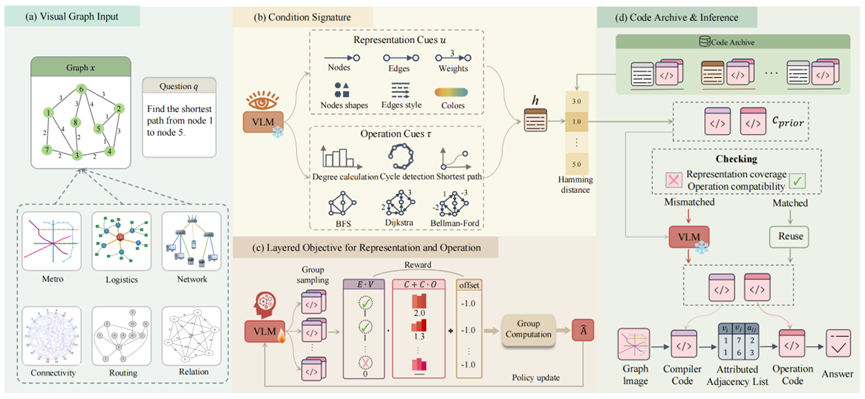
VGCompiler整体框架示意图
实验结果表明,基于 Qwen3-VL-8B 构建的 Qwen-VGCompiler 在 GVLQA、VisionGraph 和 VGCURE 三个公开视觉图推理基准上取得91.72%的平均准确率,较最强闭源视觉语言模型基线和最强代码推理基线分别提高28.89和23.69个百分点。此外,模型在地铁路径规划、物流配送和网络故障评估三类真实场景中均取得最佳表现,体现了面向异构视觉图和领域任务的良好泛化能力。
Alignment-Preserving Knowledge Transfer for Heterogeneous Multimodal Large Language Model Merging
智能模型研究室2024级硕士研究生谢秋豪和2025级硕士研究生林春辉为论文共同第一作者,论文指导老师为张东阳副研究员,电子科技大学为第一单位。
多模态大语言模型已广泛应用于视觉理解、图文问答、OCR文字识别和多模态推理等任务。然而,不同模型的优势能力通常分散在各自独立的模型中,如何在不重新训练的情况下,将多个模型的互补能力整合到一个统一模型中,是多模态大模型高效部署的重要问题。模型合并为此提供了一条低成本路径,但异构多模态模型之间往往采用不同的视觉编码器、跨模态连接器和语言模型结构,其合并难度显著高于同构模型。更重要的是,多模态能力依赖视觉编码与语言推理之间已经建立的协同关系,即“多模态对齐”。此前研究更多关注异构模型在结构上“能否合并”,却较少考虑知识注入是否会破坏目标模型原有的视觉—语言协调机制。如何在吸收源模型互补能力的同时保护多模态对齐,成为本研究的核心出发点。
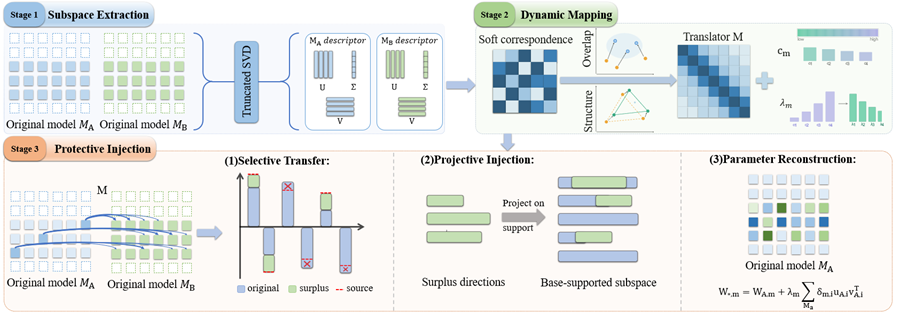
APT-Merging框架图
针对上述挑战,论文提出了APT-Merging框架(Alignment-Preserving Transfer,面向对齐保持的知识迁移框架)。该框架是一种严格的数据无关模型合并方法,不依赖训练数据、标注信息或模型前向推理,仅通过模型权重完成能力迁移。APT-Merging包含三项关键设计:(i)子空间提取(Subspace Extraction),利用截断奇异值分解提取目标模型的主导参数方向,构建需要保护的目标子空间;(ii)动态映射(Dynamic Mapping),在结构描述符空间中建立细粒度的源模型—目标模型对应关系,筛选方向结构更兼容的源模型信息;(iii)保护性注入(Protective Injection),将可靠的正向增益投影至目标模型支持的方向,并根据模型间结构差异动态调节注入强度。通过上述设计,APT-Merging将传统的直接参数融合转化为受目标模型结构约束的对齐保持知识迁移。
实验方面,论文在Qwen2-VL与LLaVA-OneVision、CogVLM与LLaVA两个7B规模异构多模态模型合并场景上进行了系统验证,覆盖8个视觉语言基准,并与Task Arithmetic、TIES-Merging、DARE、TSV-Merge、WUDI-Merging和AdaMMS等数据无关方法进行比较。结果表明,APT-Merging在两个场景中均取得最优总体性能。在Qwen2-VL与LLaVA-OneVision场景中,综合得分达到568.53,相比最强基线提升4.97,相比原始目标模型提升9.46;在CogVLM与LLaVA场景中,综合得分达到463.13,相比最强基线提升3.92,相比原始目标模型提升16.47。进一步分析表明,APT-Merging并非简单注入更多源模型参数,而是能够选择性迁移与目标模型对齐结构兼容的有益知识。
除此之外,论文在GQA、VizWiz和OCRBench等对多模态对齐较为敏感的任务上进行了进一步分析。结果显示,APT-Merging在相关任务子集上的能力恢复率达到100.0%,平均相对目标模型增益由AdaMMS的−0.07提升至+1.48。消融实验进一步验证了子空间投影、动态映射和保护性注入的有效性,其中目标子空间投影和动态映射是维持多模态对齐的关键组件。
该研究从多模态对齐保持的角度重新审视了异构多模态大语言模型合并问题,将无约束的参数融合转化为受控的知识迁移,为多模态大模型的低成本能力整合、可靠部署和知识复用提供了新的技术路径。
GHOST: Geometry-Constrained Hybrid Diffusion for Open-Vocabulary 3D Scene Graph Generation
智能模型研究室2025级硕士研究生冯昌群为论文第一作者,指导老师为何涛副研究员,电子科技大学为第一单位。
3D 场景图以物体为节点、以物体间关系为边,为三维场景提供紧凑的结构化表示,是具身导航、机器人操作等任务的重要中间表征。现有开放词汇方法虽然借助视觉语言模型提升了对未知物体和关系的识别能力,但其空间关系判断往往依赖图文数据中的语义共现规律,而非真实三维坐标所对应的可验证几何关系;同时,一次性关系预测容易在深度模糊、物体对称等场景中过早作出错误判断,后续几何校验也难以有效纠正。
为此,论文提出几何约束混合扩散框架GHOST(Geometry-Constrained Hybrid Diffusion for Open-Vocabulary 3D Scene Graph Generation)。该方法联合建模连续的物体三维几何信息与离散的关系谓词,在每一步反向扩散中依次完成“几何去噪—约束投影—关系解码”,使关系预测始终基于逐步精化且满足几何约束的场景布局。论文进一步将关系文本映射为由方向、距离、包含和相对大小等几何原语组成的可微约束,并设计几何—拓扑协同去噪器,实现物体几何与关系结构的双向迭代修正。实验结果表明,GHOST在3DSSG等数据集的闭集和开放词汇设置下均取得领先性能,尤其在空间谓词识别方面表现出显著优势。
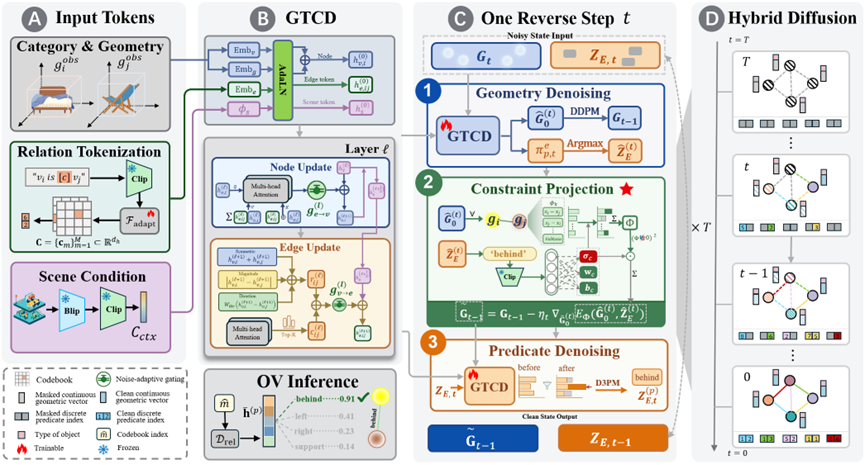
GHOST框架整体示意
TC-Flow: Trajectory-Coupled Multimodal Flow Matching for Incomplete Modality Learning
智能模型研究室2023级本科生蒙灏冉为第一作者,导师戴瑞婷工程师为通讯作者,电子科技大学为第一单位。
真实场景中的多模态数据常因传感器故障、网络丢包、隐私限制或数据损坏出现模态缺失,导致训练与测试分布不一致并削弱预测性能。论文发现,现有扩散式补全虽能生成高保真特征,但极端缺失下相较纯高斯噪声增益有限,并将这一瓶颈定义为“终端状态监督鸿沟”(Terminal-State Supervision Gap)。
针对这一问题,论文提出Trajectory-Coupled Multimodal Flow Matching(TC-Flow)框架。PCFD模块结合条件流匹配与x-prediction,直接预测任务相关的终端特征,并通过ODE求解器将下游任务损失端到端回传至生成轨迹;TCF模块从ODE积分轨迹中提取动态稳定性作为可靠性先验,自适应校准融合门控,在轨迹不稳定时抑制错误补全传播,在轨迹平稳时恢复多模态协同增益。
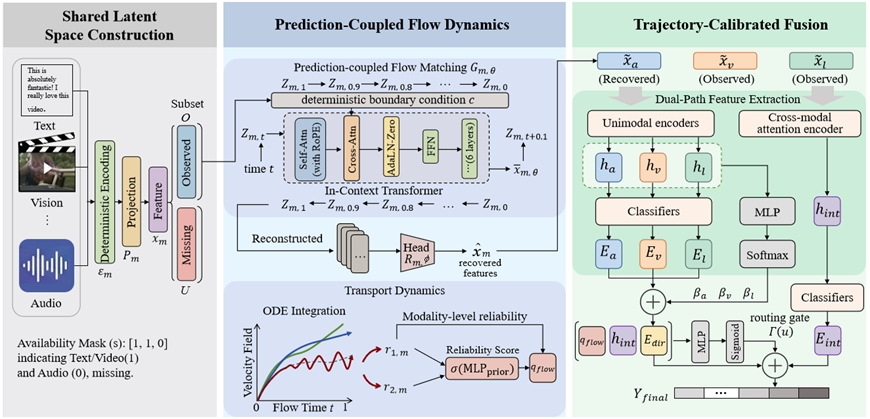
TC-Flow框架总体架构图
论文在CMU-MOSI、CMU-MOSEI和Weibo-17三个多模态基准数据集上开展验证,覆盖固定缺失与随机缺失设置,并与MCTN、MMIN、DiCMoR、IMDer、EUAR、GSDNet、GCNet、GameOn、RedCore、TriSPrompt等方法对比。结果表明,TC-Flow在不同缺失协议与缺失率下均保持领先,在CMU-MOSEI固定缺失设置中最高取得8.0%的二分类准确率绝对提升。
该研究揭示了不完整多模态学习中“高质量重构不等于高任务效用”的关键瓶颈,并提出以任务监督驱动生成动态、以轨迹可靠性调控融合决策的新思路,为复杂真实场景下的稳健多模态智能系统构建提供了新的技术路径。
相关链接:
ACM International Conference on Multimedia(简称 ACM MM)是多媒体领域最具影响力的国际学术会议之一,重点关注图像、视频、音频、语音、音乐、传感器数据、视觉与语言以及跨模态信息融合等前沿方向。ACM MM 被中国计算机学会(CCF)推荐为计算机图形学与多媒体领域 A 类国际学术会议。ACM MM 2026 将于2026年11月10日至14日在巴西里约热内卢举行。
一审一校:冷鸿霖
二审二校:庄志东
三审三校:武 鑫
