来源:测绘遥感工程信息全国重点实验室
文章链接:https://mp.weixin.qq.com/s/_t2G7nrPm_OZDapxjfnNUA
近期,武汉大学测绘遥感信息工程全国重点实验室涂志刚教授课题组,在多模态大模型驱动的视觉行为理解领域取得多项关键研究成果。(1)在 CCF-A类会议ACM MM 2026 的微动作分析挑战赛(Micro-Action Analysis Grand Challenge, MAC 2026)赛道三,取得全球冠军,相关技术突破以论文形式发表于ACM MM 2026。(2)课题组关于时序行为定位的研究成果被CCF-A类会议NeurIPS 2026录用。两项工作分别围绕微动作行为的准确理解,连续视频中行为起止时间的精确定位展开。
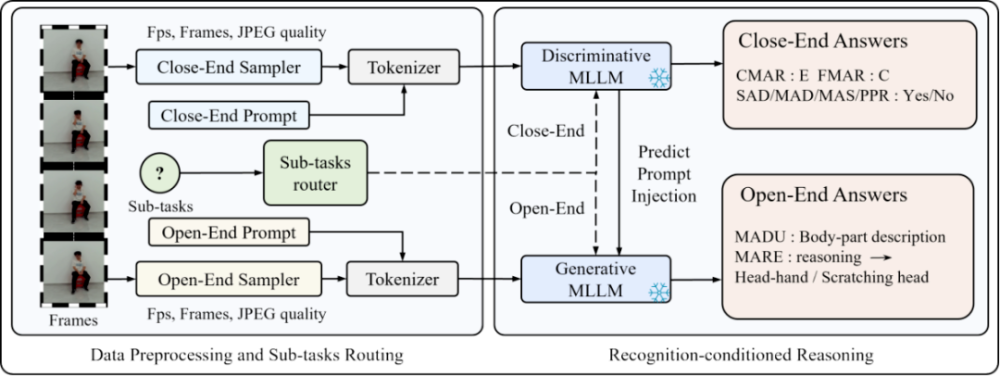
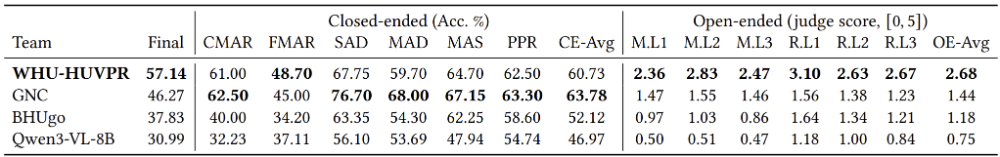
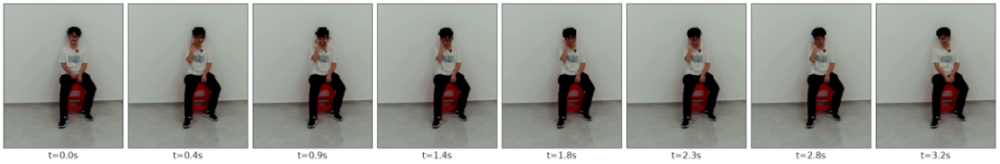
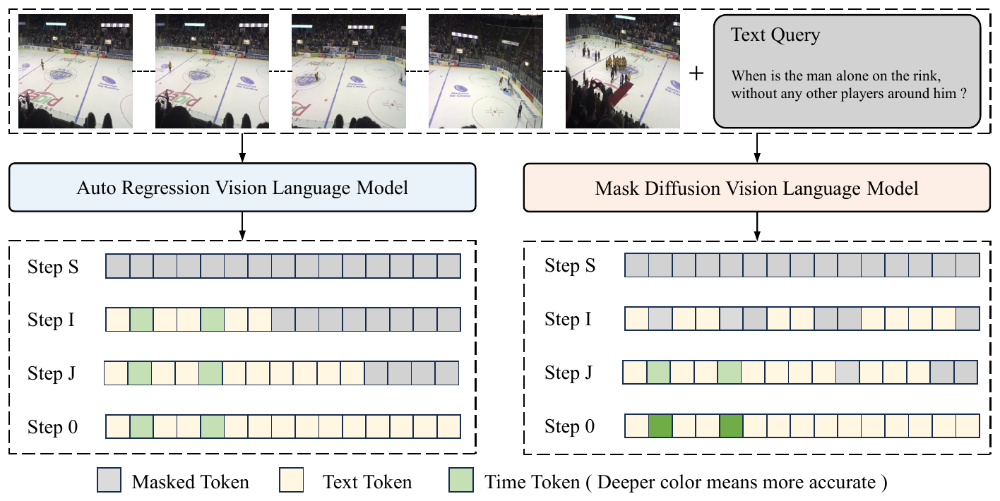
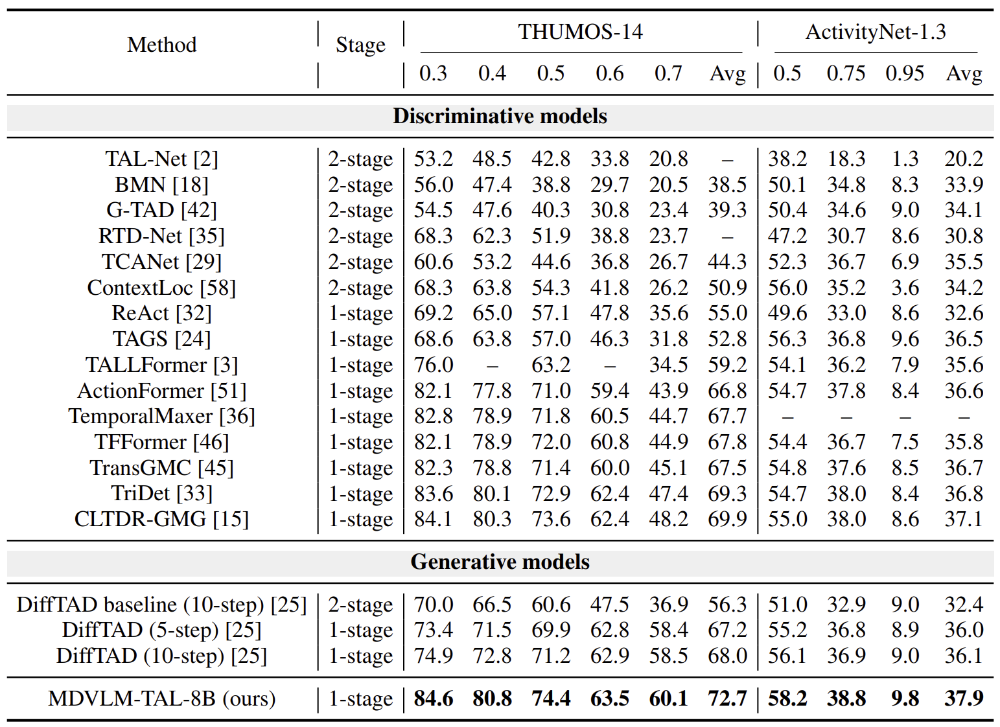
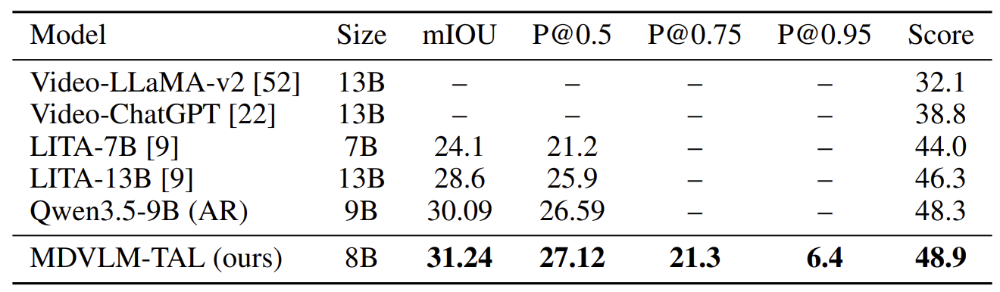
多模态大模型能够结合视频与语言描述人物活动,但一段流畅的回答,仍可能认错动作类别或给出不准确的时间范围。针对这些问题,课题组提出了识别条件化推理方法 RCR 和掩码扩散视觉语言模型 MDVLM-TAL,分别从识别与解释的协作、语义与时间边界的联合生成入手,提高行为理解的准确性。一、 MAC 2026 赛道三全球冠军成果发表于 ACM MM 2026论文《Recognition-Conditioned Reasoning: A Training-Free Multimodal-LLM Pipeline for Fine-Grained Micro-Action Understanding》介绍了课题组获得 MAC 2026 赛道三冠军的微动作理解方案,发表于 ACM MM 2026 会议。该研究提出识别条件化推理(Recognition-Conditioned Reasoning,RCR)方法,王丰舜博士研究生为第一作者,涂志刚教授为通讯作者。微动作是搓手、歪头、抖腿等幅度较小的身体动作,其细微变化为情感计算和行为理解等提供了行为线索。微动作理解既要分清“触摸”和“抓挠”等相近类别,也要描述身体部位的运动过程并解释判断依据。MAC 2026 赛道三采用 MA-Bench 评测,包含围绕 1,000 段视频构建的 12,000 条问答,覆盖动作识别、时空判断、开放式描述与推理。这一设定带来的问题是,如何充分发挥多模态大模型的不同能力?团队发现,擅长识别的模型未必最擅长解释,同一个模型还可能围绕错误标签写出流畅的回答;仅靠语言模型裁判评分,又容易掩盖类别错误。因此,研究如何让识别结果参与解释,并直接核对解释中的动作标签?进而为免训练条件下的准确理解提供依据。图1 RCR 的免训练微动作理解流程。识别模型先预测动作标签,再将预测标签作为线索提供给生成模型;两类模型的参数均保持冻结核心创新:以预测标签作为可核验先验的推理—核对范式识别标签引导的条件化可核验推理框架。先让擅长判别的模型预测粗粒度与细粒度动作标签,再把预测结果交给擅长生成的模型,结合视频证据组织解释。标签提供的是可核验的先验:当画面与标签冲突时,生成模型可以否决该标签。整个过程无需微调模型,实际推理使用预测标签,不依赖真实答案。独立度量动作标签预测正确性。研究提出 label-mention 指标,提取解释中实际断言的动作类别,经过同义词归一后,与同一视频识别题中的真实标签核对。这些标签仅用于评测,使“动作有没有认对”可以独立于文字流畅度进行衡量。按任务分配模型与视频预处理方法。团队将不同子任务交给各自擅长的冻结模型,对依赖时序线索的判断增加采样帧数,对其他任务保留较少帧数,并通过较高图像质量编码保存细微运动线索。在 MAC 2026 赛道三的 MA-Bench 官方评测中,课题组方案以 57.14 的总分获得冠军,领先 GNC 的 46.27、BHUgo 的 37.83 及官方基线 Qwen3-VL-8B 的 30.99,较第二名高出 10.87 分。该结果体现了方案在识别、判断、描述与推理等多类任务上的综合表现。表1 MA-Bench 官方评测中与其他方法的比较注:总分是12个子分数归一化到0—100后取平均,各列指标均越高越好。分项比较显示,课题组方案的闭集均分略低于 GNC,但开放式描述与推理的六个评分维度均领先,均分达到 2.68,高于 GNC 的 1.44。在开发集上的消融实验进一步表明,注入预测标签后,解释中的粗粒度标签准确率由 28% 提升至 51%,细粒度由 7% 提升至 35%;仅在诊断时提供正确标签,两项指标可达 79% 和 66%,说明识别环节仍有提升空间。图2 MA-Bench 中的微动作案例。人物抬手靠近耳部,模型结合手臂运动轨迹与接触位置,排除触摸面部、扶眼镜等相近动作,给出“触摸耳朵”的解释RCR 通过组织识别与解释能力改善了微动作理解。对于连续视频,认出目标动作之后,还需要找准它从何时开始、到何时结束。第二项研究进一步关注这一时间定位问题。二、 NeurIPS 2026 让语义理解与动作时间定位协同生成论文《Masked Diffusion Vision-Language Models for Temporal Action Localization》(用于时序动作定位的掩码扩散视觉语言模型)被 NeurIPS 2026 录用,提出 MDVLM-TAL 框架。实验室博士研究生王丰舜为第一作者,涂志刚教授为通讯作者。时序动作定位旨在从未经剪辑的视频中识别目标动作,并给出其开始与结束时间,是视频检索、行为理解等的基础。相比判断整段视频“包含什么动作”,这一任务还需区分动作的开始、执行与结束过程;在语言条件下,模型还要理解文本形式的提问,找到对应片段并说明理由。起止时间相差几秒,就可能导致目标片段与实际动作明显错位。现有自回归视觉大语言模型通常按从左到右的顺序生成答案。如果时间戳先于解释文本输出,后续出现的语义信息很难再用于调整先前已经生成的时间戳。另一方面,常规训练主要判断时间戳是否预测正确,不能充分反映“偏差一点”和“相差很远”在时序定位质量上的区别。研究因此同时关注生成顺序与训练目标,让语义信息更充分地参与动作的边界预测。图3 自回归生成与掩码扩散生成的区别。左侧按顺序输出答案;右侧从待填充的答案出发,在双向上下文中逐步恢复文本和时间符号,使边界预测能够利用更充分的语义信息核心创新:双向注意力指导语义与时间边界协同恢复,片段重合程度指导边界学习掩码扩散统一生成动作类别与时间戳。MDVLM-TAL 将动作标签、起止时间和解释文本放入同一回答序列,从全部被掩码的输出开始,结合视频与问题逐步恢复内容。每一步都利用当前序列的双向上下文,使语义描述与时间信息在统一生成过程中相互提供依据。语义先形成,时间边界后确定。针对时间边界需要更多上下文这一发现,研究设计计划式训练目标:让时间戳在训练中保持更长时间的遮蔽,通常晚于通用文本的恢复;同时,提高后期低噪声步骤的训练权重。这样,模型学习在语义信息逐渐充分之后确定时间边界,减少过早给出时间戳带来的偏差。片段重合程度指导边界学习。研究引入逐步时间交并比奖励。时间交并比(tIoU)衡量预测片段与真实片段的重合程度,越高表示时间范围越接近。在动作的起点与终点时间戳都已出现后,再启用这一奖励,避免用不完整区间计算奖励,使训练关注每一步的定位质量,并在去验码过程中逐步提高定位质量,同时保留文本重建监督,兼顾回答内容与时间预测。研究在 THUMOS-14、ActivityNet-1.3 和 ActivityNet-RTL 三项基准上开展评测。前两项检验模型能否识别动作并找准时间范围,第三项进一步考察结合语言问题定位视频片段与生成解释的能力。采用 8B骨干的 MDVLM-TAL,在论文所比较的方法中取得了SOTA。表 2 THUMOS-14和ActivityNet-1.3数据集上的模型性能比较在表2中的THUMOS-14上,MDVLM-TAL在每个评测的tIoU阈值处都达到最高的平均检测精度(mAP),且在更严格的阈值(如0.7)处增益最大。在ActivityNet-1.3上,它还改进了平均mAP和高重叠指标。这些增益很重要,因为高阈值mAP衡量的是边界质量,而不仅是粗略的动作识别。表3 ActivityNet-RTL数据集上的实验结果比较。Qwen3.5-9B是额外自回归(AR)基线模型。未报告的指标标注为“–”表3评估了查询条件推理设置。ActivityNet-RTL用mIoU和阈值精度衡量定位质量,并用LITA中的“Score”衡量解释质量。源比较基准中的一些通用Video-LLM不能可靠地输出时间戳,因此其比较仅基于分数。MDVLM-TAL在使用单一8B骨干的情况下,在定位和解释质量上都优于此前最强的基模。这一结果表明,表明掩码扩散既有助于闭集定位,也有助于语言条件的时间推理。两项成果分别着手于行为类别与时间边界,但都强调让生成结果受到视频证据的约束。RCR 通过识别结果引导并核验解释,MDVLM-TAL 则把语义与时间定位纳入同一生成过程,为能够说明“发生了什么、依据是什么、发生在什么时候”的视频理解提供了互补方法。相关研究可为行为理解、细粒度视频检索和人机交互等应用提供技术参考。
武汉大学行为理解与视觉感知实验室(HUVPR-Lab),致力于多模态大模型、生成式AI、视觉理解研究,聚焦“以人为中心”的视频行为理解与生成。https://arxiv.org/pdf/2608.21022https://arxiv.org/pdf/2605.29858